
Insight Face 教科書
【目次】
第1章 序論
1.1 顔解析技術の背景
顔解析技術は、1960年代のパターン認識研究に始まり、2012年以降の畳み込みニューラルネットワーク(CNN)の普及によって認識精度が大きく向上した。現在は、個人認証、写真の自動整理、入退室管理、映像解析などで利用されている。
一方で、顔画像は個人情報保護法における個人識別符号に該当し、生体データとして扱われる。取得・保管・利用にあたっては、本人の同意、保管期間、目的外利用の禁止といった運用ルールの設計が必要である。
1.2 InsightFaceの概要とライセンス
InsightFaceは、顔検出・顔認識・顔属性推定を統合したオープンソースの顔解析フレームワークである。開発チームによる主要な研究成果として、顔検出手法のSCRFD(ICLR 2022)およびRetinaFace(CVPR 2020)、顔認識手法のArcFace(CVPR 2019)がある。
Pythonパッケージのバージョン1.0以降では、推論バックエンドはonnxruntimeであり、デスクトップGUI(InsightFace Evaluation Studio)も同梱される。GUIはpip install "insightface[gui]"でインストールし、insightface-guiで起動する。
ライセンス情報:
- ライブラリのコード: MITライセンス(学術・商用ともに利用可能)
- 配布されている学習済みモデル: 非商用の研究目的に限定。自動ダウンロードされるモデルパックも同じ条件であり、商用利用には別途ライセンスされたモデルが必要である
必要な前提知識:
- Python プログラミングの基礎
- 機械学習の基本概念
- コンピュータビジョンの基礎知識
第2章 顔解析の技術基盤
2.1 特徴ベクトルと類似度計算
特徴ベクトル(埋め込み、embedding)とは、顔画像の特徴を数値化した多次元ベクトルである。InsightFaceの認識モデルは、いずれも512次元のベクトルを出力する。
コサイン類似度は、2つのベクトルのなす角度に基づく類似性の指標である。
cos(θ) = (A・B) / (|A| × |B|)ここで、A・Bは内積、|A|、|B|はそれぞれのベクトルのノルムを表す。値域は[-1, 1]で、1に近いほど向きが揃っており、類似度が高い。InsightFaceのFaceオブジェクトは、L2正規化済みのnormed_embeddingを持つため、この属性どうしの内積がそのままコサイン類似度になる。
2.2 深層学習における顔認識の仕組み
顔認識では、CNNを用いて顔画像から特徴ベクトルを抽出する。学習では、同一人物の顔が近い特徴ベクトルに、異なる人物の顔が遠い特徴ベクトルになるように重みが最適化される。学習済みモデルは、学習時に存在しなかった人物に対しても特徴ベクトルを出力できるため、再学習なしで新しい人物を登録できる。
2.3 顔検出と顔認識の違い
顔検出は、画像のどこに顔があるかを求める処理であり、出力は境界ボックス(矩形座標)と信頼度スコア、および5点キーポイント(両目、鼻、両口角)である。物体検出の一種であり、分類と位置推定を同時に行う。
顔認識は、検出・位置合わせ済みの顔画像から特徴ベクトルを抽出し、他の顔と比較して人物を同定する処理である。認識モデルへの入力は112×112画素に正規化された顔画像であり、この正規化には検出段階で得たキーポイントを用いる。したがって、検出の失敗や位置合わせのずれは、そのまま認識精度の低下につながる。
検出器の多くはアンカーベースの方式を採る。これは、あらかじめ定義した大きさと縦横比の候補領域(アンカー)ごとに、顔の有無と位置の補正量を予測する方式である。SCRFDもこの方式に基づく。
2.4 損失関数と角度マージン
損失関数は、予測と正解のずれを数値化する関数であり、学習はこの値を小さくする方向にパラメータを更新することで進む。
顔認識では、通常のsoftmax交差エントロピーだけでは、同一人物の特徴ベクトルが十分に集まらない。そこでArcFaceは、特徴ベクトルと各クラスの重みベクトルをともにL2正規化して角度θを求め、正解クラスの角度にマージンmを加えた cos(θ + m) を用いて損失を計算する。これにより、正解と判定されるために必要な角度が厳しくなり、クラス内の角度は小さく、クラス間の角度は大きくなるように学習が進む。この性質があるため、推論時の類似判定にコサイン類似度が適合する。
2.5 モデル形式とONNX
ONNX(Open Neural Network Exchange)は、学習済みモデルを異なるフレームワーク間で交換するための標準形式である。InsightFaceのPythonライブラリはONNXモデルのみを扱い、推論はonnxruntimeが実行する。PyTorchなど他のフレームワークで学習したモデルも、ONNXへ変換すればライブラリから呼び出せる。
推論処理は、学習済みモデルに入力を与えて出力を得る処理であり、重みの更新を伴わない。GPUで推論するにはonnxruntime-gpuを、CPUのみで推論するにはonnxruntimeをインストールする。
第3章 InsightFaceの技術詳細
3.1 顔検出技術(SCRFDとRetinaFace)
Pythonパッケージが配布するすべてのモデルパック(buffalo系・antelopev2)の顔検出器はSCRFDである。RetinaFaceは同じプロジェクトが公開する別系統の検出器であり、リポジトリのdetectionディレクトリから個別に利用する。
SCRFD
- ICLR 2022で発表された顔検出手法(Sample and Computation Redistribution for Efficient Face Detection)
- 学習サンプルの再配分(Sample Redistribution)と、バックボーン・ネックへの計算量の再配分(Computation Redistribution)により、同一の計算量でより高い精度を得る
- 評価はVGA解像度(640×480)の単一スケールで行われる。
2.5Gなどの表記は、VGA入力時の計算量が2.5G FLOPsであることを意味する - WIDER FACEにおける精度(Easy/Medium/Hard)は、SCRFD_500MFが90.57/88.12/68.51、SCRFD_2.5GFが93.78/92.16/77.87、SCRFD_10GFが95.16/93.87/83.05である
RetinaFace
- CVPR 2020で発表された単段階顔検出手法
- 顔の分類、境界ボックス回帰、5点キーポイント回帰、および3D頂点の回帰を同時に学習する
- 論文のmAPはマルチスケールテストによる評価である
計算量による階層
- 10GF系(buffalo_l, antelopev2):計算量が最も大きく、小さな顔や困難な条件に強い
- 2.5GF系(buffalo_m):中程度の計算量
- 500MF系(buffalo_s, buffalo_sc):軽量版
3.2 ArcFace顔認識技術
ArcFaceは、加法的角度マージン損失(Additive Angular Margin Loss)による顔認識手法である(CVPR 2019)。バックボーンにはResNet系(R50、R100)やMobileFaceNet(MBF)が用いられる。
学習データセット
- WebFace600K(buffalo_l/m/s/scの認識モデル):WebFace42Mの部分集合で、約60万人・約1,200万枚の顔画像からなる
- Glint360K(antelopev2の認識モデル):約36万人・約1,700万枚の顔画像からなる
モデルパックの認識精度
- buffalo_l(R50@WebFace600K):LFW 99.83、CFP-FP 99.33、AgeDB-30 98.23、IJB-C(E4) 97.25、MR-ALL 91.25
- buffalo_s(MBF@WebFace600K):LFW 99.70、CFP-FP 98.00、AgeDB-30 96.58、IJB-C(E4) 95.02、MR-ALL 71.87
- buffalo_mの認識精度はbuffalo_lと同一であり、buffalo_scの認識精度はbuffalo_sと同一である(両者の差は検出器またはランドマーク・属性モデルの有無にある)
LFWはすでに飽和しており、モデル間の差は現れにくい。実運用に近い比較を行う場合は、IJB-CのTAR@FAR=1e-4や、人種横断のMR-ALLを参照する。
3.3 処理パイプライン
InsightFaceのFaceAnalysis.get()は、以下の順序で処理を実行する。
[入力画像]
    ↓
[1. 顔検出(SCRFD)] → 境界ボックスと5点キーポイント
    ↓
[2. 顔ランドマーク検出] → 2D 106点、3D 68点
    ↓
[3. 顔の位置合わせ] → 5点キーポイントを用いて112×112へ正規化
    ↓
[4. 顔認識(ArcFace)] → 512次元の特徴ベクトル抽出
    ↓
[5. 属性推定] → 年齢・性別推定
    ↓
[出力結果(Faceオブジェクトのリスト)]
3.4 モデルパック構成
Pythonパッケージが提供するモデルパックを示す。自動ダウンロードの対象はbuffalo_lのみであり、他のパックは配布ページからzipを取得して~/.insightface/models/に展開してから使用する。
- buffalo_l:SCRFD-10GF + ResNet50@WebFace600K、2d106 & 3d68、年齢・性別、326MB(既定のモデルパック)
- buffalo_m:SCRFD-2.5GF + ResNet50@WebFace600K、2d106 & 3d68、年齢・性別、313MB
- buffalo_s:SCRFD-500MF + MBF@WebFace600K、2d106 & 3d68、年齢・性別、159MB
- buffalo_sc:SCRFD-500MF + MBF@WebFace600K、ランドマークと属性推定を含まない、16MB
- antelopev2:SCRFD-10GF + ResNet100@Glint360K、2d106 & 3d68、年齢・性別、407MB
buffalo_lに含まれるONNXファイル:
- det_10g.onnx:顔検出モデル(SCRFD-10GF)
- w600k_r50.onnx:顔認識モデル(ResNet50@WebFace600K)
- genderage.onnx:年齢・性別推定モデル
- 1k3d68.onnx:3D 68点ランドマークモデル
- 2d106det.onnx:2D 106点ランドマークモデル
buffalo_m/buffalo_s/buffalo_scに含まれるONNXファイル:
- buffalo_m:det_2.5g.onnx、w600k_r50.onnx、genderage.onnx、1k3d68.onnx、2d106det.onnx
- buffalo_s:det_500m.onnx、w600k_mbf.onnx、genderage.onnx、1k3d68.onnx、2d106det.onnx
- buffalo_sc:det_500m.onnx、w600k_mbf.onnx の2ファイルのみ
antelopev2に含まれるONNXファイル:
- scrfd_10g_bnkps.onnx:顔検出モデル(SCRFD-10GF)
- glintr100.onnx:顔認識モデル(ResNet100@Glint360K)
- genderage.onnx:年齢・性別推定モデル
- 1k3d68.onnx:3D 68点ランドマークモデル
- 2d106det.onnx:2D 106点ランドマークモデル
第4章 環境構築と基本実装
4.1 環境構築と基本設定
目的:InsightFaceの基本的なセットアップを行う
期待される結果:顔解析機能が使用可能な状態になる
NVIDIA GPUを搭載した環境ではonnxruntime-gpuを、CPUのみの環境ではonnxruntimeをインストールする。管理者権限のコマンドプロンプトで以下を実行する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
REM GPUを使用する場合
pip install -U insightface onnxruntime-gpu numpy opencv-python pillow

REM CPUのみを使用する場合
pip install -U insightface onnxruntime numpy opencv-python pillow
from insightface.app import FaceAnalysis
# 既定のモデルパック(buffalo_l)を使用。初回実行時に自動ダウンロードされる
app = FaceAnalysis(providers=['CUDAExecutionProvider', 'CPUExecutionProvider'])
app.prepare(ctx_id=0, det_size=(640, 640))
# Glint360K学習の認識モデルを使う場合(antelopev2は手動ダウンロードが必要)
# app = FaceAnalysis(name='antelopev2', providers=['CUDAExecutionProvider', 'CPUExecutionProvider'])
# app.prepare(ctx_id=0, det_size=(640, 640))ctx_idは使用するGPU番号を指定し、CPUで実行する場合はctx_id=-1を指定する。det_sizeは検出時の入力解像度である。バージョン1.0以降ではdet_sizeを省略すると128×128と640×640の2段階で検出してから統合する自動モードになるため、処理時間を一定にしたい場合は明示的に指定する。
4.1.1 使用するモジュールの指定方法
InsightFaceではallowed_modulesパラメータにより、読み込むモジュールを限定できる。不要なモデルを読み込まないことで、初期化時間とメモリ使用量を削減できる。
# 1. すべてのモジュールを使用(デフォルト)
app = FaceAnalysis()

# 2. 顔検出と顔認識のみを使用
app = FaceAnalysis(allowed_modules=['detection', 'recognition'])

# 3. 2D 106点ランドマークのみを使用
app = FaceAnalysis(allowed_modules=['detection', 'landmark_2d_106'])

# 4. 3D 68点ランドマークのみを使用
app = FaceAnalysis(allowed_modules=['detection', 'landmark_3d_68'])

# 5. 両方のランドマークを使用
app = FaceAnalysis(allowed_modules=['detection', 'landmark_2d_106', 'landmark_3d_68'])

# 6. 顔検出のみ
app = FaceAnalysis(allowed_modules=['detection'])
指定可能なモジュール:
'detection':顔検出(他のモジュールの前提となるため常に指定する)'recognition':顔認識(embeddingとnormed_embeddingを得るために必要)'genderage':年齢・性別推定'landmark_2d_106':2D 106点ランドマーク'landmark_3d_68':3D 68点ランドマーク
4.2 基本的な顔検出
目的:画像から顔を検出し、基本情報を取得する
期待される結果:検出された顔の数、位置、キーポイントが出力される
# InsightFace顔検出プログラム
#   静的画像からの顔検出とキーポイント抽出
#   論文: "Sample and Computation Redistribution for Efficient Face Detection" (ICLR 2022)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: SCRFDによる顔検出、顔の境界ボックスと5点キーポイントを同時に出力
#   学習済モデル: buffalo_l の det_10g.onnx(SCRFD-10GF)
#   前準備: pip install -U insightface onnxruntime opencv-python pillow numpy

import cv2
import numpy as np
from datetime import datetime
from PIL import Image, ImageDraw, ImageFont
from insightface.app import FaceAnalysis
from insightface.data import get_image as ins_get_image

# 定数定義
KEYPOINT_NAMES = ["左目", "右目", "鼻", "左口角", "右口角"]
FONT_PATH = 'C:/Windows/Fonts/meiryo.ttc'
DETECTION_SIZE = (640, 640)
CTX_ID = 0  # GPUを使用しない場合は -1

print("=== InsightFace 顔検出プログラム ===")
print("概要: 静的画像から顔を検出し、境界ボックスと5点キーポイントを抽出")
print("操作: 自動実行(対話操作なし)")
print("注意: 初回実行時はモデルのダウンロードが行われる\n")

# 顔検出モデル初期化と画像読み込み
app = FaceAnalysis(allowed_modules=['detection'])
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)
img = ins_get_image('t1')

# 顔検出実行
timestamp = datetime.now().strftime("%Y-%m-%d %H:%M:%S.%f")[:-3]
faces = app.get(img)

print(f"処理時刻: {timestamp}")
print(f"検出された顔の数: {len(faces)}\n")

# 描画用画像の準備(Pillowで日本語を描画する)
img_pil = Image.fromarray(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
draw = ImageDraw.Draw(img_pil)
font = ImageFont.truetype(FONT_PATH, 20)

for face_id, face in enumerate(faces):
    # 境界ボックスと検出スコアの出力
    bbox = face.bbox.astype(int)
    print(f"顔ID: {face_id}, 検出スコア: {face.det_score:.3f}, "
          f"BBox: [{bbox[0]}, {bbox[1]}, {bbox[2]}, {bbox[3]}]")
    draw.rectangle([(bbox[0], bbox[1]), (bbox[2], bbox[3])], outline=(0, 255, 0), width=2)
    draw.text((bbox[0], max(bbox[1] - 25, 0)), f"顔 {face_id}", font=font, fill=(0, 255, 0))

    # キーポイントの出力と描画
    kps = face.kps.reshape(-1, 2).astype(int)  # (5, 2)形状
    for kp_id, (x, y) in enumerate(kps):
        print(f"  キーポイントID {kp_id} ({KEYPOINT_NAMES[kp_id]}): ({x}, {y})")
        draw.ellipse([(x - 3, y - 3), (x + 3, y + 3)], fill=(255, 0, 0))

# Pillow画像をOpenCV形式に変換して表示
result_img = cv2.cvtColor(np.array(img_pil), cv2.COLOR_RGB2BGR)
cv2.imshow('Face Detection Result', result_img)
print("\n任意のキーを押すと終了します")
cv2.waitKey(0)
cv2.destroyAllWindows()
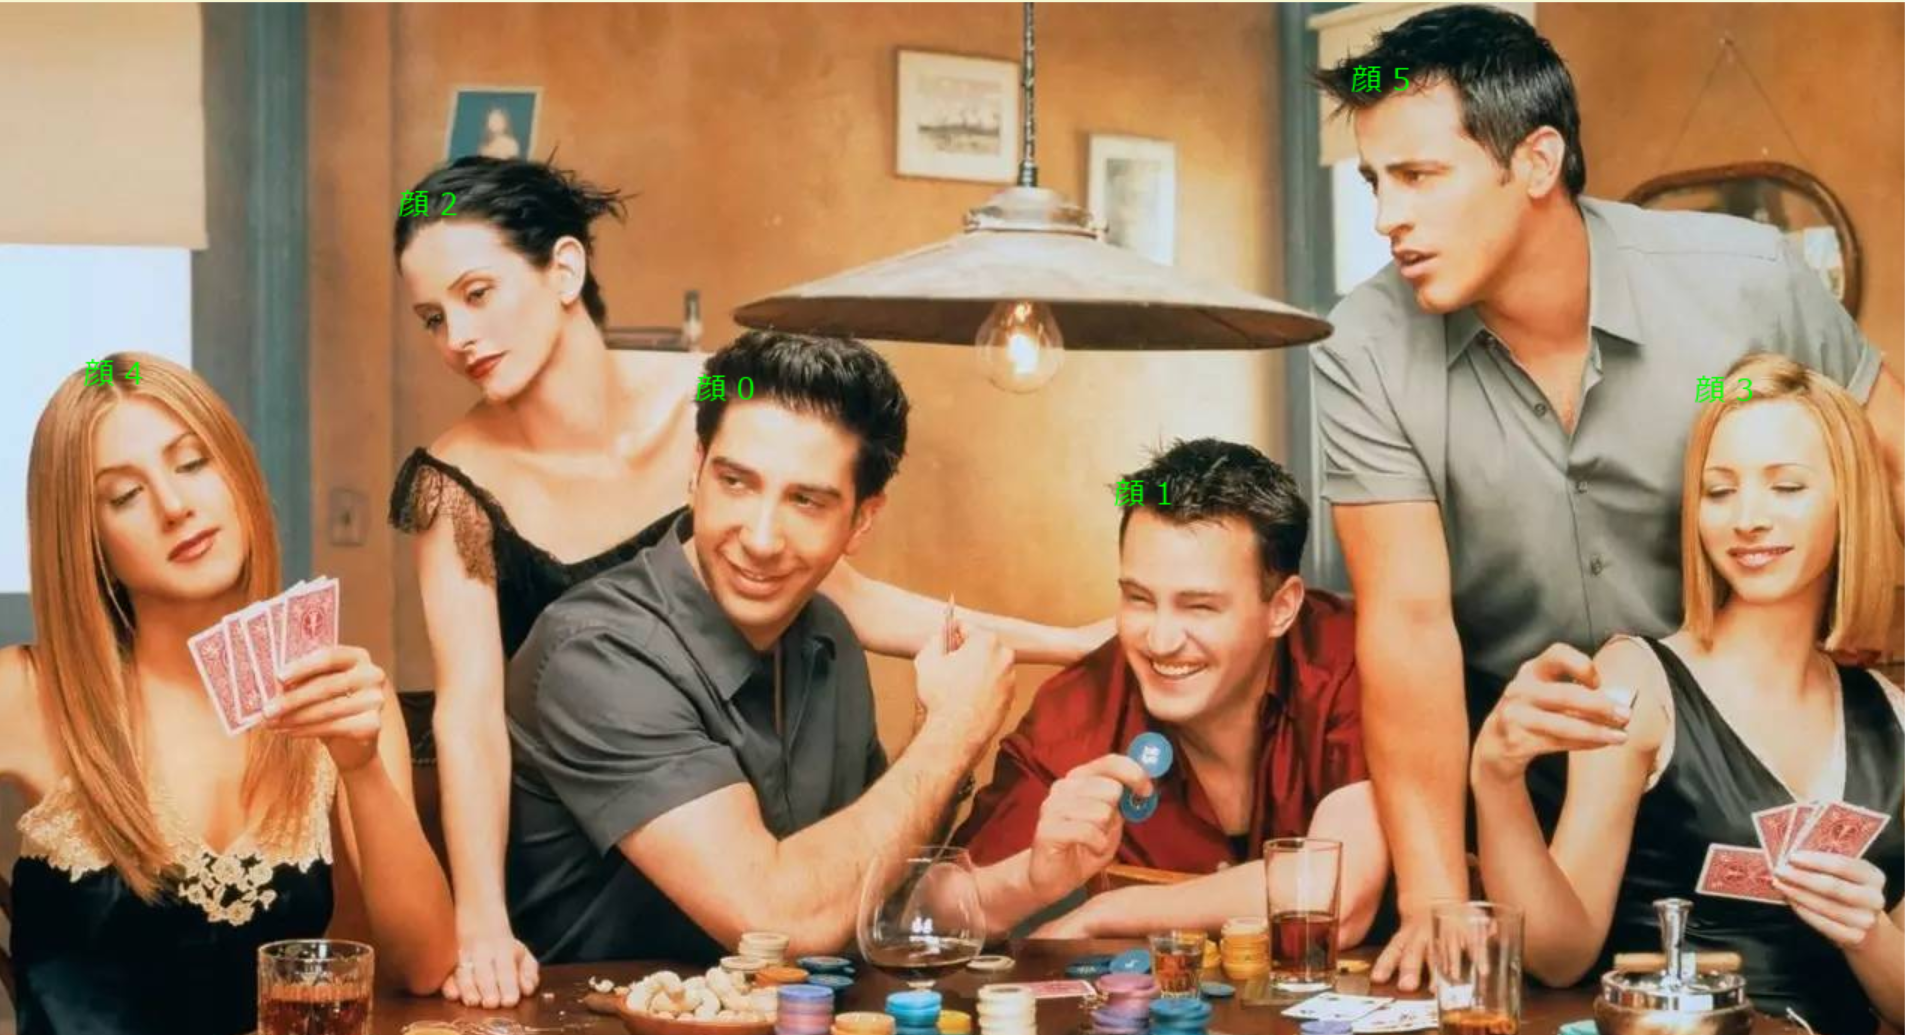
4.3 顔認識と属性推定
目的:検出された顔から特徴ベクトルを抽出し、属性を推定する
期待される結果:512次元特徴ベクトル、年齢、性別、ランドマーク情報が出力される
年齢・性別推定モデルはCelebAで学習されたMobileNet-0.25であり、パラメータ数は0.3Mと小規模である。推定値には誤差があるため、統計的な傾向把握以上の用途には適さない。
# InsightFace顔解析プログラム
#   画像から顔検出・ランドマーク・年齢・性別・特徴ベクトル抽出をまとめて実行
#   論文: "ArcFace: Additive Angular Margin Loss for Deep Face Recognition" (CVPR 2019)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: 角度マージン損失で学習した認識モデルにより512次元の特徴ベクトルを抽出
#         2D 106点・3D 68点ランドマーク、年齢・性別推定を同時に取得できる
#   学習済モデル: buffalo_l(SCRFD-10GF + ResNet50@WebFace600K)
#   前準備: pip install -U insightface onnxruntime numpy

import numpy as np
from insightface.app import FaceAnalysis
from insightface.data import get_image as ins_get_image

# 定数定義
DETECTION_SIZE = (640, 640)
CTX_ID = 0  # GPUを使用しない場合は -1

# 顔解析アプリケーションを初期化
app = FaceAnalysis(name='buffalo_l')
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)

# サンプル画像を読み込み
img = ins_get_image('t1')

# メイン処理
faces = app.get(img)

# 結果出力
for i, face in enumerate(faces):
    print(f"顔 {i+1}:")
    print(f"  検出スコア: {face.det_score:.3f}")
    print(f"  特徴ベクトル次元: {len(face.embedding)}")
    print(f"  正規化済みベクトルのノルム: {np.linalg.norm(face.normed_embedding):.3f}")
    print(f"  年齢(推定値): {face.age}歳")
    print(f"  性別(推定値): {'男性' if face.gender == 1 else '女性'}")

    if face.kps is not None:
        print(f"  5点キーポイント: 利用可能")
    if getattr(face, 'landmark_2d_106', None) is not None:
        print(f"  2D 106点ランドマーク: 利用可能")
    if getattr(face, 'landmark_3d_68', None) is not None:
        print(f"  3D 68点ランドマーク: 利用可能")

print(f"\n実行結果の解釈:")
print(f"- 特徴ベクトル: 顔の特徴を512次元の数値で表現したもの")
print(f"- normed_embedding: L2正規化済みで、内積がそのままコサイン類似度になる")
print(f"- 年齢・性別: 小規模モデルによる推定値であり誤差を含む")
第5章 応用実装とシステム構築
5.1 画像ファイルからの顔検出
目的:認識機能を使わず、画像ファイルに対して顔検出のみを実行する
期待される結果:顔位置とキーポイントが出力される
# InsightFace顔検出プログラム(画像ファイル入力)
#   ローカルの画像ファイルから顔を検出する
#   論文: "Sample and Computation Redistribution for Efficient Face Detection" (ICLR 2022)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: 顔検出モジュールのみを読み込むため初期化が速く、メモリ使用量が小さい
#   学習済モデル: buffalo_l の det_10g.onnx(SCRFD-10GF)
#   前準備: pip install -U insightface onnxruntime opencv-python numpy

from insightface.app import FaceAnalysis
from pathlib import Path
import cv2

# 定数定義
IMAGE_PATH = 'test.jpg'
DETECTION_SIZE = (640, 640)
CTX_ID = 0  # GPUを使用しない場合は -1

# 顔検出器の初期化
app = FaceAnalysis(allowed_modules=['detection'])
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)

# 画像読み込み
if not Path(IMAGE_PATH).exists():
    print(f'画像ファイルが見つかりません: {IMAGE_PATH}')
    raise SystemExit

img = cv2.imread(IMAGE_PATH)
if img is None:
    print(f'画像の読み込みに失敗しました: {IMAGE_PATH}')
    raise SystemExit

# 顔検出実行
faces = app.get(img)
print(f'検出された顔の数: {len(faces)}')

# 結果出力
for i, face in enumerate(faces):
    print(f"顔 {i+1}:")
    print(f"  顔の位置: {face.bbox}")
    print(f"  検出スコア: {face.det_score:.3f}")
    print(f"  キーポイント: {face.kps}")
5.2 顔照合システム
目的:2つの顔画像が同一人物かを判定する
期待される結果:類似度スコアと同一人物判定結果が出力される
判定に用いるしきい値は、モデルと運用環境で変わる。InsightFaceの認識モデルパックでは、誤合致率(FMR)1e-4〜1e-5に対応するコサイン類似度のしきい値はおおむね0.30〜0.45の範囲に入る。運用時は、自組織のデータで検証用のペア集合を作り、目標とする誤合致率からしきい値を決定してから固定する。モデルを変更した場合はしきい値を必ず再計算する。
# InsightFace顔照合プログラム
#   2つの画像から顔の特徴ベクトルを抽出し、コサイン類似度で同一人物かを判定する
#   論文: "ArcFace: Additive Angular Margin Loss for Deep Face Recognition" (CVPR 2019)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: 角度マージン損失により、コサイン類似度がそのまま同一性の指標になる
#         normed_embedding(L2正規化済み)の内積でコサイン類似度を計算する
#   学習済モデル: buffalo_l(512次元の特徴ベクトルを出力)
#   前準備: pip install -U insightface onnxruntime opencv-python numpy

from insightface.app import FaceAnalysis
from pathlib import Path
import numpy as np
import cv2

# 定数定義(THRESHOLDは運用データで再計算して決定する)
THRESHOLD = 0.4
DETECTION_SIZE = (640, 640)
CTX_ID = 0  # GPUを使用しない場合は -1
IMAGE1_PATH = 'person1.jpg'
IMAGE2_PATH = 'person2.jpg'

# 顔検出と顔認識の初期化
app = FaceAnalysis(allowed_modules=['detection', 'recognition'])
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)


def get_largest_face(image_path):
    """画像から最も大きい顔を1つ返す"""
    if not Path(image_path).exists():
        print(f'画像ファイルが見つかりません: {image_path}')
        return None

    img = cv2.imread(image_path)
    if img is None:
        print(f'画像の読み込みに失敗しました: {image_path}')
        return None

    faces = app.get(img)
    if len(faces) == 0:
        print(f'顔が検出されませんでした: {image_path}')
        return None

    # 顔が複数ある場合は面積が最大のものを使用する
    return max(faces, key=lambda f: (f.bbox[2] - f.bbox[0]) * (f.bbox[3] - f.bbox[1]))


# メイン処理
face1 = get_largest_face(IMAGE1_PATH)
face2 = get_largest_face(IMAGE2_PATH)

if face1 is None or face2 is None:
    raise SystemExit

# コサイン類似度計算(normed_embeddingはL2正規化済みのため内積でよい)
similarity = float(np.dot(face1.normed_embedding, face2.normed_embedding))
is_same = similarity > THRESHOLD

# 結果出力
print(f"類似度: {similarity:.3f}")
print(f"同一人物: {'はい' if is_same else 'いいえ'}")
print(f"判定基準: 類似度が{THRESHOLD}を超える場合に同一人物と判定")
第6章 性能最適化と実践的応用
6.1 性能と精度の調整
6.1.1 モデルパックの選択
処理速度とメモリを優先する場合は、buffalo_sまたはbuffalo_scを選び、det_sizeを(320, 320)に縮小する。認識精度を優先する場合は、buffalo_lまたはantelopev2を選ぶ。buffalo_mはbuffalo_lと同じ認識モデルを持ち、検出器のみが軽量であるため、認識精度を保ったまま検出の計算量を下げたい場合に適する。
6.1.2 実行環境の設定
from insightface.app import FaceAnalysis

# GPU実行(onnxruntime-gpuのインストールが必要)
app = FaceAnalysis(name='buffalo_l', providers=['CUDAExecutionProvider'])
app.prepare(ctx_id=0, det_size=(640, 640))

# 複数画像の逐次処理。appの初期化は1回だけ行い、ループ内では推論のみを実行する
def process_multiple_images(images):
    results = []
    for img in images:
        results.append(app.get(img))
return resultsFaceAnalysisの初期化にはモデル読み込みの時間がかかるため、アプリケーション起動時に1回だけ初期化し、以降は同じインスタンスを再利用する。providersに'CUDAExecutionProvider'のみを指定した場合、GPUが利用できない環境では初期化に失敗する。フォールバックが必要な場合は['CUDAExecutionProvider', 'CPUExecutionProvider']を指定する。
6.1.3 精度を高める設定
from insightface.app import FaceAnalysis
import numpy as np

# 小さく写った顔を検出したい場合は入力解像度を上げる(処理時間は増加する)
app = FaceAnalysis(name='buffalo_l')
app.prepare(ctx_id=0, det_size=(1024, 1024))

# 検出しきい値の調整(既定は0.5。下げると検出数が増え、誤検出も増える)
app.det_thresh = 0.4

# 1人につき複数枚を登録し、特徴ベクトルの平均を登録テンプレートとする
def make_template(face_list):
    vectors = np.stack([f.normed_embedding for f in face_list])
    mean_vector = vectors.mean(axis=0)
return mean_vector / np.linalg.norm(mean_vector)認識モデルへの入力は、検出したキーポイントによる位置合わせと、学習時と同じ正規化を経て生成される。この前処理を独自の画像処理(コントラスト補正やヒストグラム平坦化など)で置き換えると、学習時の条件から外れて精度が低下する。精度向上のためには、前処理を変更するのではなく、撮影条件の改善、登録画像の複数枚化、モデルパックの変更で対応する。
6.2 写真整理アプリケーション
目的:複数の写真を顔の類似度でグループ化する
期待される結果:同一人物の写真がグループにまとめられる
以下は、各グループの先頭の顔と比較する逐次的なグループ化である。実装が単純である一方、比較順序によって結果が変わる。写真枚数が多い場合は、scikit-learnのDBSCAN(距離にコサイン距離を指定)などのクラスタリング手法を用いる。
# InsightFace顔グループ化プログラム
#   複数画像から顔の特徴ベクトルを抽出し、コサイン類似度でグループ化する
#   論文: "ArcFace: Additive Angular Margin Loss for Deep Face Recognition" (CVPR 2019)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: 512次元の特徴ベクトルの内積でコサイン類似度を計算し、しきい値でグループ化する
#   学習済モデル: buffalo_l(SCRFD-10GF + ResNet50@WebFace600K)
#   前準備: pip install -U insightface onnxruntime opencv-python numpy

from insightface.app import FaceAnalysis
import numpy as np
import cv2
from pathlib import Path

# 定数定義(SIMILARITY_THRESHOLDは対象データで調整する)
SIMILARITY_THRESHOLD = 0.4
DETECTION_SIZE = (640, 640)
CTX_ID = 0  # GPUを使用しない場合は -1
IMAGE_PATHS = ['photo1.jpg', 'photo2.jpg', 'photo3.jpg', 'photo4.jpg']

# 顔認識アプリケーション初期化
app = FaceAnalysis(allowed_modules=['detection', 'recognition'])
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)

# 各写真から顔特徴を抽出(1枚に複数の顔がある場合はすべて対象とする)
face_data = []
for img_path in IMAGE_PATHS:
    if not Path(img_path).exists():
        print(f'画像ファイルが見つかりません: {img_path}')
        continue

    img = cv2.imread(img_path)
    if img is None:
        print(f'画像の読み込みに失敗しました: {img_path}')
        continue

    for face_index, face in enumerate(app.get(img)):
        face_data.append({
            'path': img_path,
            'face_index': face_index,
            'embedding': face.normed_embedding
        })

# 顔グループの作成
groups = []
for face in face_data:
    placed = False
    for group in groups:
        similarity = float(np.dot(face['embedding'], group[0]['embedding']))
        if similarity > SIMILARITY_THRESHOLD:
            group.append(face)
            placed = True
            break
    if not placed:
        groups.append([face])

# 結果出力
if len(groups) == 0:
    print("処理可能な顔データがありません")
else:
    print("=== 顔グループ化の結果 ===")
    for i, group in enumerate(groups):
        print(f"グループ {i+1} ({len(group)}件):")
        for face in group:
            print(f"  {face['path']} の顔 {face['face_index']}")

    print(f"\n総グループ数: {len(groups)}個")
    print(f"類似度しきい値: {SIMILARITY_THRESHOLD}")
6.3 出欠確認アプリケーション
目的:教室写真から登録済み学生の出席を確認する
期待される結果:出席者リストと欠席者リストが出力される
教室全体を1枚に収めた写真では、1人あたりの顔が小さく写るため、検出漏れと誤照合が生じやすい。det_sizeを大きくする、複数の角度から撮影する、といった対応と、結果を人が確認する運用を前提とする。顔画像とその特徴ベクトルは個人情報として扱い、保管期間と管理方法を定める必要がある。
# InsightFace顔照合による出席確認プログラム
#   登録済み学生の顔写真と教室写真を照合し、出席状況を判定する
#   論文: "ArcFace: Additive Angular Margin Loss for Deep Face Recognition" (CVPR 2019)
#   GitHub: https://github.com/deepinsight/insightface
#   特徴: 登録画像から特徴ベクトルを作成し、教室写真の各顔と1:N照合を行う
#         コサイン類似度が最大の登録者を候補とし、しきい値で受理・棄却する
#   学習済モデル: buffalo_l(SCRFD-10GF + ResNet50@WebFace600K)
#   前準備: pip install -U insightface onnxruntime opencv-python numpy

from insightface.app import FaceAnalysis
import numpy as np
import cv2
from pathlib import Path

# 定数定義(SIMILARITY_THRESHOLDは運用データで再計算して決定する)
DETECTION_SIZE = (1024, 1024)
SIMILARITY_THRESHOLD = 0.4
CTX_ID = 0  # GPUを使用しない場合は -1
CLASSROOM_IMAGE = 'classroom.jpg'
STUDENT_IMAGES = {
    'student001': 'student001.jpg',
    'student002': 'student002.jpg',
    'student003': 'student003.jpg',
}

# InsightFace初期化
app = FaceAnalysis(allowed_modules=['detection', 'recognition'])
app.prepare(ctx_id=CTX_ID, det_size=DETECTION_SIZE)


def get_largest_face(image_path):
    """画像から最も大きい顔を1つ返す"""
    if not Path(image_path).exists():
        print(f'画像ファイルが見つかりません: {image_path}')
        return None

    img = cv2.imread(image_path)
    if img is None:
        print(f'画像の読み込みに失敗しました: {image_path}')
        return None

    faces = app.get(img)
    if len(faces) == 0:
        print(f'顔が検出されませんでした: {image_path}')
        return None

    return max(faces, key=lambda f: (f.bbox[2] - f.bbox[0]) * (f.bbox[3] - f.bbox[1]))


# 登録画像から特徴ベクトルを作成
registered_students = {}
for student_id, image_path in STUDENT_IMAGES.items():
    face = get_largest_face(image_path)
    if face is not None:
        registered_students[student_id] = face.normed_embedding

if len(registered_students) == 0:
    print('登録できた学生がいません')
    raise SystemExit

# 教室写真の読み込み
img = cv2.imread(CLASSROOM_IMAGE)
if img is None:
    print(f'教室写真の読み込みに失敗しました: {CLASSROOM_IMAGE}')
    raise SystemExit

# メイン処理(各顔について最も類似度の高い登録者を選ぶ)
faces = app.get(img)
present_students = []

for face in faces:
    best_id = None
    best_similarity = -1.0
    for student_id, registered_embedding in registered_students.items():
        similarity = float(np.dot(face.normed_embedding, registered_embedding))
        if similarity > best_similarity:
            best_similarity = similarity
            best_id = student_id

    if best_similarity > SIMILARITY_THRESHOLD and best_id not in present_students:
        present_students.append(best_id)

all_students = list(registered_students.keys())
absent_students = [s for s in all_students if s not in present_students]

# 結果出力
print(f"検出された顔の数: {len(faces)}")
print(f"出席者: {present_students}")
print(f"欠席者: {absent_students}")
print(f"出席率: {len(present_students)}/{len(all_students)}")
print("判定結果は人が確認すること")
第7章 用語集
- ArcFace:加法的角度マージン損失を用いた顔認識手法。同一人物の特徴ベクトル間の角度を小さく、異なる人物間の角度を大きくするように学習する(CVPR 2019)。
- コサイン類似度:2つのベクトルのなす角度から算出される類似度指標。値域は[-1, 1]で、1に近いほど類似している。
- Glint360K:約36万人・約1,700万枚の顔認識データセット。antelopev2の認識モデルの学習に用いられている。
- MBF:MobileFaceNet。軽量な顔認識バックボーンで、計算量450M FLOPs、モデルサイズ13MB。buffalo_sとbuffalo_scで使用されている。
- ONNX:Open Neural Network Exchangeの略。異なる深層学習フレームワーク間でモデルを交換するための標準形式。
- RetinaFace:CVPR 2020で発表された単段階顔検出手法。Pythonパッケージのモデルパックではなく、リポジトリのdetectionディレクトリで提供されている。
- SCRFD:Sample and Computation Redistribution for Efficient Face Detectionの略。ICLR 2022で発表された顔検出手法。Pythonパッケージの全モデルパックで使用されている。
- WebFace600K:WebFace42Mの部分集合で、約60万人・約1,200万枚の顔画像からなるデータセット。buffalo系の認識モデルの学習に用いられている。
- 特徴ベクトル:顔画像の特徴を数値化した多次元ベクトル。InsightFaceでは512次元で表現される。L2正規化したものが
normed_embeddingである。 - 顔ランドマーク:目、鼻、口などの特徴点の座標情報。InsightFaceでは5点キーポイント、2D 106点、3D 68点が利用できる。
- FMR / FNMR:誤合致率(他人を同一人物と判定する割合)と誤非合致率(本人を別人と判定する割合)。しきい値を上げるとFMRは下がりFNMRは上がるため、両者を組にして評価する。