
Pedalboard によるエレクトロボイス生成(ソースコードと実行結果)
【概要】
Pedalboard のエフェクトチェーンで音声をロボット的なエレクトロボイスに変換するプログラムを、ソースコードと実行結果とともに紹介する。マイク入力をその場で変換する処理と、音声ファイルをまとめて変換する処理の両方を扱う。学習済みモデルは使用せず、すべてデジタル信号処理(DSP)で音を作る。
【目次】
第1章 Python開発環境,ライブラリ類
ここでは、最低限の事前準備について説明する。機械学習や深層学習を行う場合は、NVIDIA CUDA、Visual Studio、Cursor などを追加でインストールすると便利である。これらについては別ページ https://www.kkaneko.jp/cc/dev/aiassist.html で解説しているので、必要に応じて参照すること。
第2章 Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
第3章 Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する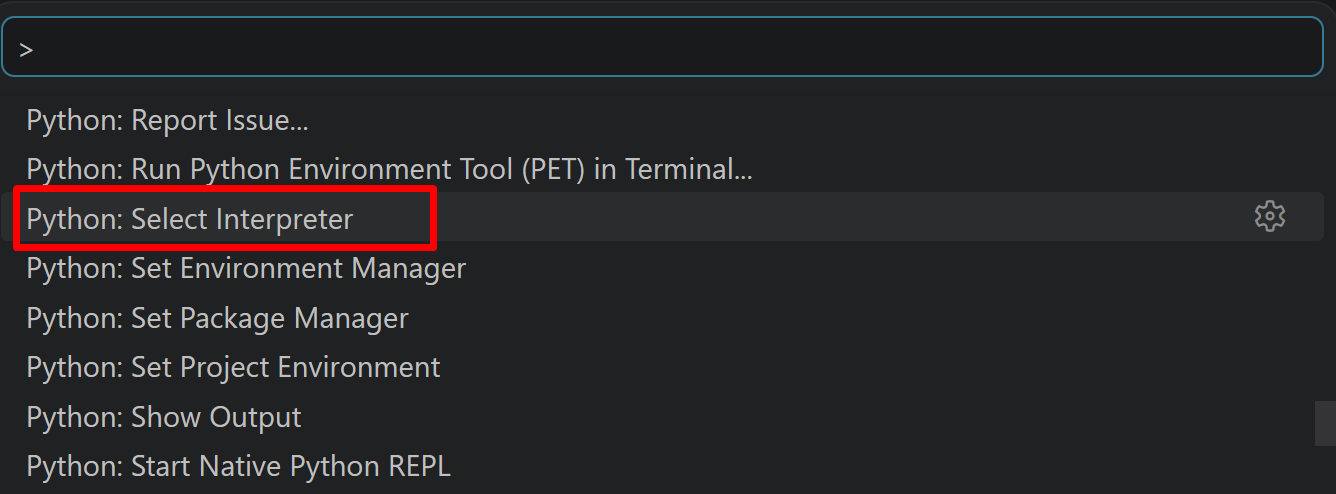
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.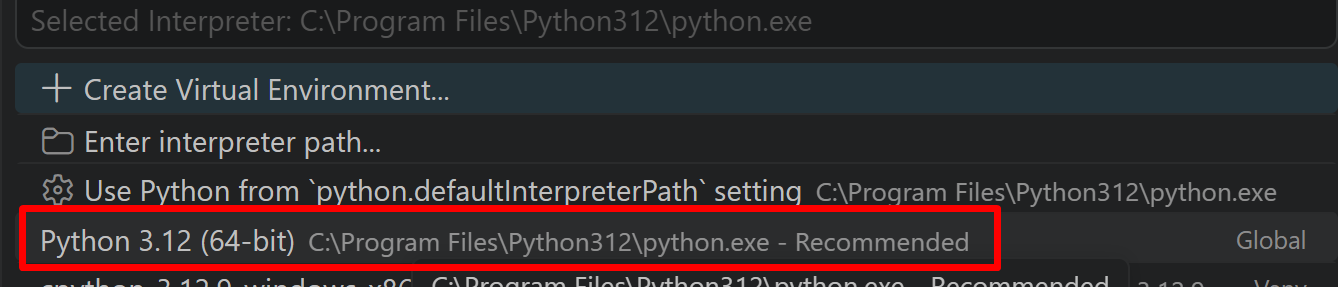
必要なライブラリをシステム領域にインストール
管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
起動したコマンドプロンプトで、次のコマンドを実行する。--no-user は、ユーザ領域ではなくシステム領域へインストールするための指定である。
pip install --no-user numpy pyaudio pedalboard
第4章 Pedalboard によるエレクトロボイス生成プログラム
概要
本プログラムは、音声信号処理により、入力音声をエレクトロボイスに変換する。マイクからの音声入力を連続的に取得し、複数のデジタル信号処理エフェクトを適用することで、ロボット音声のような音響効果を生成する。音声ファイルを入力として、ファイル全体をまとめて変換することもできる。
主要技術
- Pedalboard(音声エフェクト処理ライブラリ)
Spotify社が開発した音声エフェクトのPythonライブラリである[1]。本プログラムでは、PitchShift、Distortion、Chorus 等のエフェクトをチェーン化して使用している。 - PyAudio(リアルタイム音声入出力)
PortAudioライブラリのPythonバインディングである。音声ストリーム処理を実現する[2]。コールバック方式により、音声データの取得と再生を非同期で処理している。
技術的特徴
マイク入力時は、音声を 1024 サンプルごとの小さなかたまり(チャンク)に区切って処理する。このとき、エフェクトの内部状態をチャンクの境界で初期化してしまうと、音が途切れて雑音が入る。そこで本プログラムでは、エフェクト適用時に reset=False を指定し、チャンクをまたいでエフェクトの内部状態を引き継いでいる。
また、無音のときは RMS(信号の実効値。音量の大きさを表す指標)による判定でエフェクト処理を飛ばし、無駄な処理と雑音の増幅を避けている。
参考文献
[1] Sobot, P. (2021). Pedalboard. Zenodo. https://doi.org/10.5281/zenodo.7817838(公式リポジトリ: https://github.com/spotify/pedalboard)
[2] Bencina, R., & Burk, P. (2001). PortAudio - an Open Source Cross Platform Audio API. In Proceedings of the International Computer Music Conference (pp. 263-266).
ソースコード
# プログラム名: Pedalboard によるエレクトロボイス生成プログラム
# 特徴技術名: Pedalboard(Spotify Audio Intelligence Lab 製オーディオエフェクトライブラリ)
# 出典: Sobot, P. (2021). Pedalboard. Zenodo. https://doi.org/10.5281/zenodo.7817838
# 特徴機能: エフェクトチェーンによる音声変換(リアルタイム処理とファイル処理に対応)
# 学習済みモデル: 使用なし(DSPベースのエフェクト処理)
# 方式設計:
#   - 関連利用技術: NumPy(配列演算)、PyAudio(音声入出力)、pedalboard.io.AudioFile(音声ファイル読み書き)
#   - 入力と出力: 入力: マイク/音声ファイル、出力: エレクトロボイスに変換された音声
#   - 処理手順: 1.入力ソース選択 2.音声取得 3.NoiseGateでノイズ除去 4.PitchShiftでピッチ変更 5.Distortionでロボット感付与 6.Chorusで金属的響き追加 7.Gainで音量調整 8.Compressorで最終調整 9.出力
#   - 前処理、後処理: 前処理: ノイズゲート、後処理: クリッピング防止のための振幅制限
#   - 追加処理: RMSベースの無音検出による処理バイパス(マイク入力時のみ)
#   - 調整を必要とする設定値: PITCH_SHIFT_SEMITONES(ピッチシフト量、-12〜12半音)、DISTORTION_DRIVE_DB(歪み量、0〜20dB)、NOISE_GATE_THRESHOLD_DB(ノイズゲート閾値、-60〜-20dB)、SILENCE_THRESHOLD(無音判定閾値、0.0001〜0.01)
# 将来方策: PITCH_SHIFT_SEMITONES を MIDI コントローラーで制御可能にすることで、演奏中のリアルタイム音程変化を実現
# その他の重要事項: マイク入力時は遅延を抑えるため CHUNK サイズを 1024 サンプルに設定。チャンク間でエフェクトの内部状態を引き継ぐため reset=False を指定。ファイル処理時は全体を一括処理
# 前準備: pip install --no-user numpy pyaudio pedalboard

import numpy as np
import pyaudio
from pedalboard import Pedalboard, PitchShift, Distortion, Chorus, NoiseGate, Gain, Compressor
from pedalboard.io import AudioFile
import threading
import urllib.request
import tempfile
import os
import time
from datetime import datetime

# 音声パラメータ
RATE = 44100
CHUNK = 1024
CHANNELS = 1
FORMAT = pyaudio.paFloat32

# サンプル音声URL
SAMPLE_AUDIO_URL = 'https://github.com/librosa/librosa-test-data/raw/main/test1_44100.wav'

# エフェクトパラメータ(調整可能な設定値)
PITCH_SHIFT_SEMITONES = -5.0   # ピッチシフト量(-12〜12半音、負値で低音化)
DISTORTION_DRIVE_DB = 12.0     # 歪み量(0〜20dB)
CHORUS_RATE_HZ = 1.5           # コーラス速度(0.1〜10Hz)
CHORUS_DEPTH = 0.3             # コーラス深度(0.0〜1.0)
CHORUS_MIX = 0.5               # コーラスミックス量(0.0〜1.0)
NOISE_GATE_THRESHOLD_DB = -40.0 # ノイズゲート閾値(-60〜-20dB)
GAIN_DB = -6.0                 # 最終ゲイン調整(歪み後の音量調整)

# コンプレッサーパラメータ
COMPRESSOR_THRESHOLD_DB = -15.0  # コンプレッサー閾値
COMPRESSOR_RATIO = 3.0            # コンプレッサー比率
COMPRESSOR_ATTACK_MS = 5.0        # アタック時間(ミリ秒)
COMPRESSOR_RELEASE_MS = 50.0      # リリース時間(ミリ秒)

# 無音検出・処理パラメータ
SILENCE_THRESHOLD = 0.001      # 無音判定閾値
CLIPPING_LIMIT = 0.95          # クリッピング防止の最大値

# 処理停止フラグと録音バッファ
stop_processing = False
recording_buffer = []

# エフェクトチェーンの構築
effect_board = Pedalboard([
    NoiseGate(                                               # ノイズゲート
        threshold_db=NOISE_GATE_THRESHOLD_DB,
        ratio=10.0,
        attack_ms=1.0,
        release_ms=100.0
    ),
    PitchShift(semitones=PITCH_SHIFT_SEMITONES),           # ピッチシフト
    Distortion(drive_db=DISTORTION_DRIVE_DB),              # 歪み
    Chorus(                                                 # コーラス(金属的響き)
        rate_hz=CHORUS_RATE_HZ,
        depth=CHORUS_DEPTH,
        mix=CHORUS_MIX
    ),
    Gain(gain_db=GAIN_DB),                                  # ゲイン調整
    Compressor(                                             # 最終段コンプレッサー
        threshold_db=COMPRESSOR_THRESHOLD_DB,
        ratio=COMPRESSOR_RATIO,
        attack_ms=COMPRESSOR_ATTACK_MS,
        release_ms=COMPRESSOR_RELEASE_MS
    )
])

def audio_callback(in_data, frame_count, time_info, status):
    global stop_processing, recording_buffer

    if stop_processing:
        return (None, pyaudio.paComplete)

    # 入力データをnumpy配列に変換
    audio_data = np.frombuffer(in_data, dtype=np.float32)

    # 無音検出(RMS計算)
    rms = np.sqrt(np.mean(audio_data**2))

    # 無音時は適切なサイズのバッファを返す
    if rms < SILENCE_THRESHOLD:
        silence_buffer = np.zeros(frame_count, dtype=np.float32)
        # 無音も録音バッファに追加
        recording_buffer.append(silence_buffer.copy())
        return (silence_buffer.tobytes(), pyaudio.paContinue)

    # Pedalboardでエフェクト処理(reset=Falseでチャンク間のエフェクト状態を保持)
    processed_audio = effect_board(audio_data, sample_rate=RATE, reset=False)

    # クリッピング防止
    processed_audio = np.clip(processed_audio, -CLIPPING_LIMIT, CLIPPING_LIMIT)

    # 録音バッファに追加
    recording_buffer.append(processed_audio.copy())

    # 処理済みデータを返す
    return (processed_audio.astype(np.float32).tobytes(), pyaudio.paContinue)

def process_audio_file(input_path, output_path):
    """音声ファイル全体を処理"""
    print(f'音声ファイルを読み込み中: {input_path}')

    with AudioFile(input_path, 'r') as input_file:
        audio = input_file.read(input_file.frames)
        sample_rate = input_file.samplerate

    # モノラルに変換
    if audio.ndim > 1:
        audio = np.mean(audio, axis=0)

    print('音声処理中...')

    # エフェクト処理
    processed_audio = effect_board(audio, sample_rate)

    # クリッピング防止
    processed_audio = np.clip(processed_audio, -CLIPPING_LIMIT, CLIPPING_LIMIT)

    # ファイルに保存
    with AudioFile(output_path, 'w', samplerate=sample_rate, num_channels=1) as output_file:
        output_file.write(processed_audio)

    print(f'処理済み音声を保存しました: {output_path}')

    return output_path, sample_rate

def play_audio_file(file_path, sample_rate=None):
    """音声ファイルを再生"""
    with AudioFile(file_path, 'r') as f:
        audio = f.read(f.frames)
        file_sample_rate = f.samplerate
    if audio.ndim > 1:
        audio = np.mean(audio, axis=0)

    # サンプルレートの決定(引数が指定されていればそれを使用、なければファイルのレートを使用)
    playback_rate = sample_rate if sample_rate is not None else file_sample_rate

    p = pyaudio.PyAudio()
    stream = p.open(format=pyaudio.paFloat32,
                    channels=1,
                    rate=int(playback_rate),
                    output=True)

    # 小さなチャンクで再生
    chunk_size = 1024
    for i in range(0, len(audio), chunk_size):
        chunk = audio[i:i + chunk_size]
        stream.write(chunk.astype(np.float32).tobytes())

    stream.stop_stream()
    stream.close()
    p.terminate()

def download_sample_audio():
    """サンプル音声をダウンロード"""
    print('サンプル音声をダウンロード中...')
    with tempfile.NamedTemporaryFile(delete=False, suffix='.wav') as tmp_file:
        urllib.request.urlretrieve(SAMPLE_AUDIO_URL, tmp_file.name)
        return tmp_file.name

def keyboard_monitor():
    """キーボード入力を監視するスレッド"""
    global stop_processing
    while not stop_processing:
        user_input = input()
        if user_input.lower() == 'q':
            stop_processing = True
            break
        time.sleep(0.1)

def realtime_microphone_processing():
    """マイクからのリアルタイム処理(録音機能付き)"""
    global stop_processing, recording_buffer
    stop_processing = False
    recording_buffer = []

    print('\nマイク入力のリアルタイム処理を開始します')
    print('処理済み音声をリアルタイムで再生中...')
    print("終了するには 'q' を入力して Enter を押してください")
    print('-' * 60)

    # キーボード監視スレッドを開始
    keyboard_thread = threading.Thread(target=keyboard_monitor, daemon=True)
    keyboard_thread.start()

    p = pyaudio.PyAudio()

    stream = p.open(format=FORMAT,
                    channels=CHANNELS,
                    rate=RATE,
                    input=True,
                    output=True,
                    frames_per_buffer=CHUNK,
                    stream_callback=audio_callback)

    stream.start_stream()

    # メインループ
    while stream.is_active() and not stop_processing:
        time.sleep(0.1)

    stream.stop_stream()
    stream.close()
    p.terminate()

    # 録音データの保存
    if len(recording_buffer) > 0:
        print('\n' + '-' * 60)
        save_choice = input('録音した音声を保存しますか?(y/n): ').strip().lower()
        if save_choice == 'y':
            # タイムスタンプ付きファイル名
            timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
            output_filename = f'electro_voice_recording_{timestamp}.wav'

            # カスタムファイル名の入力オプション
            custom_name = input(f'ファイル名を入力してください(Enterでデフォルト: {output_filename}): ').strip()
            if custom_name:
                if not custom_name.endswith('.wav'):
                    custom_name += '.wav'
                output_filename = custom_name

            # 録音データを結合
            full_audio = np.concatenate(recording_buffer)

            # ファイルに保存
            with AudioFile(output_filename, 'w', samplerate=RATE, num_channels=1) as f:
                f.write(full_audio)

            print(f'録音を保存しました: {output_filename}')

            # 再生オプション
            play_choice = input('保存した音声を再生しますか?(y/n): ').strip().lower()
            if play_choice == 'y':
                play_audio_file(output_filename, RATE)

    print('\nマイク処理を終了しました')

# メイン処理
print('=' * 60)
print('エレクトロボイス生成システム')
print('=' * 60)
print()
print('【処理設定】')
print(f'・ピッチシフト: {PITCH_SHIFT_SEMITONES}半音')
print(f'・歪み: {DISTORTION_DRIVE_DB}dB')
print(f'・ノイズゲート: {NOISE_GATE_THRESHOLD_DB}dB')
print()
print('【入力ソース選択】')
print('0: 音声ファイル')
print('1: マイク(リアルタイム処理・録音可能)')
print('2: サンプル音声ファイル')
print('-' * 60)

choice = input('選択 (0/1/2): ').strip()

if choice == '0':
    # ユーザ指定の音声ファイル
    input_path = input('ファイルパスを入力してください: ').strip()
    if not os.path.exists(input_path):
        print('ファイルが見つかりません')
        exit()

    output_path = input('出力ファイル名を入力してください(例: output.wav): ').strip()
    if not output_path.endswith('.wav'):
        output_path += '.wav'

    output_path, sr = process_audio_file(input_path, output_path)

    # 再生オプション
    play_choice = input('処理済み音声を再生しますか?(y/n): ').strip().lower()
    if play_choice == 'y':
        play_audio_file(output_path, sr)

elif choice == '1':
    # マイク入力(リアルタイム処理)
    realtime_microphone_processing()

elif choice == '2':
    # サンプル音声ファイル
    sample_path = download_sample_audio()
    output_path = 'electro_voice_output.wav'

    output_path, sr = process_audio_file(sample_path, output_path)

    # 一時ファイルを削除
    os.remove(sample_path)

    # 再生オプション
    play_choice = input('処理済み音声を再生しますか?(y/n): ').strip().lower()
    if play_choice == 'y':
        play_audio_file(output_path, sr)

else:
    print('無効な選択です')
    exit()

print('\nエレクトロボイス生成システムを終了しました')