Pedalboard による音声明瞭化(ソースコードと実行結果)
【概要】
Pedalboard を用いて音声の明瞭度を向上させるプログラムを、ソースコードと実行結果とともに紹介する。マイク入力、音声ファイル、動画ファイルを入力として扱い、周波数特性の調整だけで聞き取りやすさを改善する。学習済みモデルは使用しない。
【目次】
第1章 Python開発環境,ライブラリ類
ここでは、最低限の事前準備について説明する。機械学習や深層学習を行う場合は、NVIDIA CUDA、Visual Studio、Cursor などを追加でインストールすると便利である。これらについては別ページ https://www.kkaneko.jp/cc/dev/aiassist.html で解説しているので、必要に応じて参照すること。
第2章 Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
第3章 Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する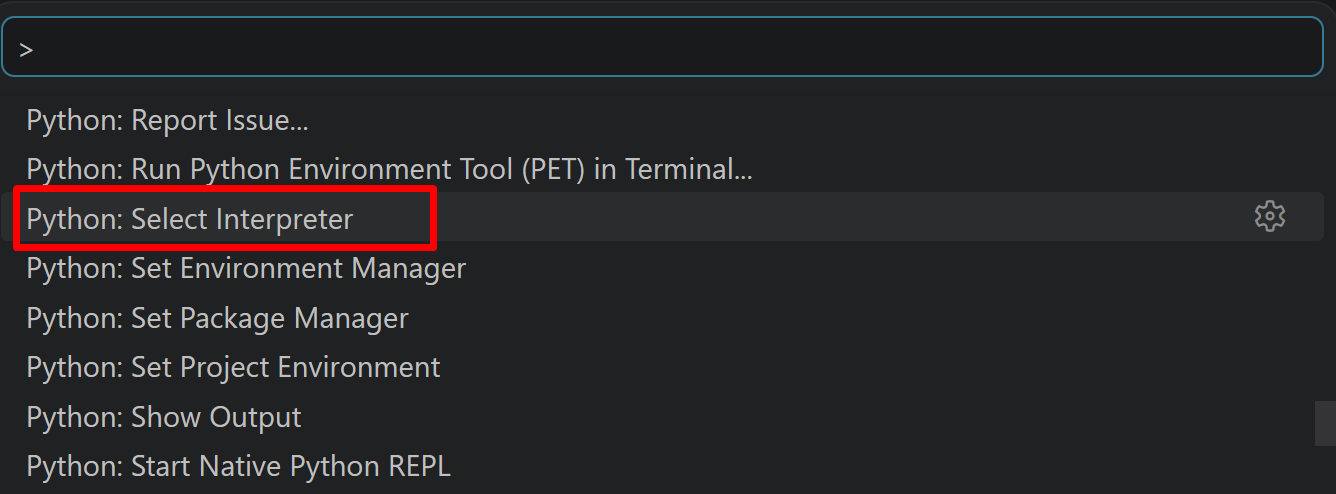
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.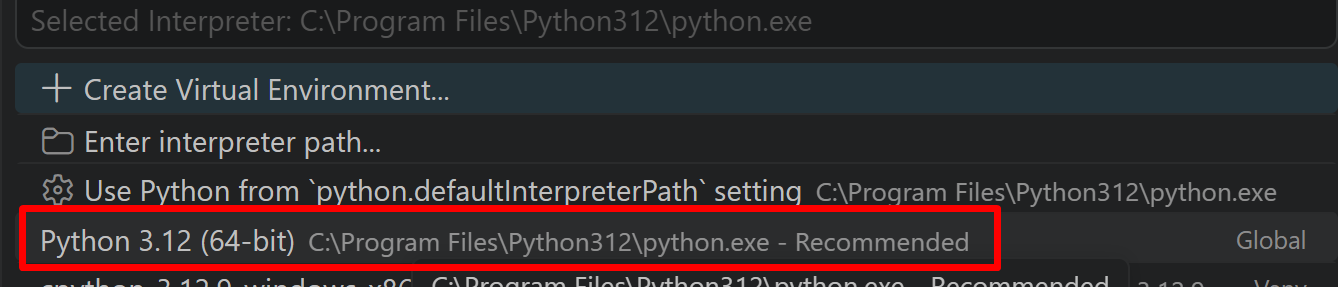
必要なライブラリをシステム領域にインストール
管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
起動したコマンドプロンプトで、次のコマンドを実行する。--no-user は、ユーザ領域ではなくシステム領域へインストールするための指定である。
pip install --no-user numpy pyaudio pedalboard moviepy scipy
第4章 Pedalboard による音声明瞭化プログラム
概要
本プログラムは、人間の音声の明瞭度を向上させる。マイクから入力された音声信号の周波数特性を分析し、子音帯域(3kHz付近)を選択的に強調することで、音声の聞き取りやすさを改善する。周波数特性のみの調整を行うため、雑音そのものを取り除く処理は行わない。
主要技術
- Pedalboard(音声エフェクト処理ライブラリ)
Spotify社が開発した音声エフェクトのPythonライブラリである[1]。本プログラムでは、PeakFilter を使用して特定周波数帯域を強調している。
- デジタル信号処理(DSP)による周波数選択的強調
PeakFilter は、中心周波数、ゲイン、Q値(帯域幅の狭さを表す値。値が大きいほど狭い範囲だけを強調する)を指定して特定の周波数帯域を強調する[2]。本プログラムでは3kHz付近を4dB強調することで、日本語の無声子音(か行、さ行、た行など)の明瞭度を向上させている。
技術的特徴
マイク入力時は、音声を 2048 サンプルごとの小さなかたまり(チャンク)に区切って処理する。このとき、エフェクトの内部状態をチャンクの境界で初期化してしまうと、音が途切れて雑音が入る。そこで本プログラムでは、エフェクト適用時に reset=False を指定し、チャンクをまたいでエフェクトの内部状態を引き継いでいる。
処理の効果を確かめられるように、子音帯域(2kHz〜4kHz)のエネルギーが全体に占める割合を明瞭度指標として計算し、処理前後の値を比較して表示する。
参考文献
[1] Sobot, P. (2021). Pedalboard. Zenodo. https://doi.org/10.5281/zenodo.7817838(公式リポジトリ: https://github.com/spotify/pedalboard)
[2] Zölzer, U. (2011). DAFX: Digital Audio Effects (2nd ed.). John Wiley & Sons.
ソースコード
# プログラム名: マルチソース対応音声明瞭化システム
# 特徴技術名: Pedalboard(Spotify Audio Intelligence Lab 製オーディオエフェクトライブラリ)+ マルチバンド処理
# 出典: Sobot, P. (2021). Pedalboard. Zenodo. https://doi.org/10.5281/zenodo.7817838
# 特徴機能: マルチバンド周波数強調とノイズゲートによる音声明瞭化
# 学習済みモデル: 使用なし(DSPベースのエフェクト処理)
# 方式設計:
#   - 関連利用技術: NumPy、PyAudio、moviepy、urllib、scipy
#   - 入力と出力: マイク/音声ファイル/動画ファイルから入力、処理済みファイル保存または再生
#   - 処理手順: 1.入力選択 2.マルチバンド処理 3.出力(保存/再生)
#   - 前処理、後処理: ノイズゲート、クリッピング防止
#   - 調整を必要とする設定値: 各周波数帯域のゲイン値
#   - その他の重要事項: マイク入力時はチャンク間でエフェクトの内部状態を引き継ぐため reset=False を指定
# 前準備: pip install --no-user numpy pyaudio pedalboard moviepy scipy

import numpy as np
import pyaudio
from pedalboard import Pedalboard, PeakFilter, NoiseGate
from pedalboard.io import AudioFile
import threading
import time
import os
import urllib.request
import tempfile
from pathlib import Path
import queue
from datetime import datetime
from scipy import signal

# 音声パラメータ
RATE = 44100
CHUNK = 2048
CHANNELS = 1
FORMAT = pyaudio.paFloat32

# サンプル音声URL
SAMPLE_AUDIO_URL = 'https://github.com/librosa/librosa-test-data/raw/main/test1_44100.wav'

# マルチバンド処理パラメータ(ITU-T P.862 PESQ音声品質評価基準参考)
BAND_LOW_FREQ = 200.0      # 低域中心周波数
BAND_LOW_GAIN = -2.0       # 低域ゲイン(濁音抑制)
BAND_MID_FREQ = 1500.0     # 中域中心周波数
BAND_MID_GAIN = 2.0        # 中域ゲイン(母音明瞭度)
BAND_HIGH_FREQ = 3000.0    # 高域中心周波数
BAND_HIGH_GAIN = 4.0       # 高域ゲイン(子音強調)
NOISE_GATE_THRESHOLD = -40.0  # ノイズゲート閾値(dB)

# 処理パラメータ
SILENCE_THRESHOLD = 0.001
SMOOTHING_FACTOR = 0.7

# 明瞭度計測パラメータ
CLARITY_FREQ_LOW = 2000    # 明瞭度評価用の周波数帯域(下限)
CLARITY_FREQ_HIGH = 4000   # 明瞭度評価用の周波数帯域(上限)
STATS_UPDATE_INTERVAL = 2.0 # 統計更新間隔

# グローバル変数
previous_rms = 0.0
processing_active = True
realtime_stats = {
    'total_time': 0.0,
    'active_time': 0.0,
    'input_level_sum': 0.0,
    'output_level_sum': 0.0,
    'input_clarity_sum': 0.0,
    'output_clarity_sum': 0.0,
    'clarity_samples': 0,  # 明瞭度計算回数を追跡
    'noise_reduced_frames': 0,
    'total_frames': 0,
    'active_frames': 0
}
stats_lock = threading.Lock()
start_time = None
last_stats_time = time.time()
stop_queue = queue.Queue()
recorded_audio = []  # 録音データ保存用

# マルチバンド明瞭化エフェクトチェーン
clarity_board = Pedalboard([
    NoiseGate(threshold_db=NOISE_GATE_THRESHOLD, ratio=10, attack_ms=1.0, release_ms=100.0),
    PeakFilter(cutoff_frequency_hz=BAND_LOW_FREQ, gain_db=BAND_LOW_GAIN, q=0.7),
    PeakFilter(cutoff_frequency_hz=BAND_MID_FREQ, gain_db=BAND_MID_GAIN, q=0.8),
    PeakFilter(cutoff_frequency_hz=BAND_HIGH_FREQ, gain_db=BAND_HIGH_GAIN, q=0.8),
])

def calculate_clarity_index(audio_data, sample_rate):
    """明瞭度指標を計算(子音帯域のエネルギー比)"""
    # 窓関数を適用
    window = np.hanning(len(audio_data))
    windowed_data = audio_data * window

    # 窓関数のパワー正規化
    window_power = np.sum(window**2)

    # FFT実行
    fft = np.fft.rfft(windowed_data)
    freqs = np.fft.rfftfreq(len(windowed_data), 1/sample_rate)

    # パワースペクトル密度の計算(片側スペクトルの正しい補正)
    power_spectrum = np.abs(fft)**2 / (sample_rate * window_power)

    # DC成分とナイキスト周波数以外を2倍(片側スペクトル補正)
    if len(power_spectrum) > 1:
        power_spectrum[1:-1] *= 2
        if len(power_spectrum) % 2 == 0:
            # 偶数長の場合、最後の要素がナイキスト周波数
            power_spectrum[-1] *= 1
        else:
            # 奇数長の場合、最後の要素は2倍
            power_spectrum[-1] *= 2

    # 子音帯域のエネルギー
    clarity_mask = (freqs >= CLARITY_FREQ_LOW) & (freqs <= CLARITY_FREQ_HIGH)
    clarity_energy = np.sum(power_spectrum[clarity_mask])

    # 全体のエネルギー(DC成分を除く)
    total_energy = np.sum(power_spectrum[1:])

    if total_energy > 1e-10:
        return clarity_energy / total_energy
    return 0.0

def download_sample_audio():
    """サンプル音声をダウンロード"""
    print('サンプル音声をダウンロード中...')
    with tempfile.NamedTemporaryFile(delete=False, suffix='.wav') as tmp_file:
        urllib.request.urlretrieve(SAMPLE_AUDIO_URL, tmp_file.name)
        return tmp_file.name

def process_audio_file(input_path, save_result=True, target_sample_rate=None):
    """音声ファイルを処理"""
    print(f'音声ファイルを読み込み中: {input_path}')

    with AudioFile(input_path, 'r') as input_file:
        audio = input_file.read(input_file.frames)
        sample_rate = input_file.samplerate
        original_sample_rate = sample_rate

    # モノラルに変換
    if audio.ndim > 1:
        audio = np.mean(audio, axis=0)

    # ターゲットサンプルレートが指定されている場合はリサンプリング
    if target_sample_rate and target_sample_rate != sample_rate:
        num_samples = int(len(audio) * target_sample_rate / sample_rate)
        audio = signal.resample(audio, num_samples)
        sample_rate = target_sample_rate

    print('音声処理中...')

    # 処理前の明瞭度計算
    input_clarity = calculate_clarity_index(audio[:min(len(audio), CHUNK*10)], sample_rate)

    # マルチバンド処理
    processed_audio = clarity_board(audio, sample_rate)

    # 処理後の明瞭度計算
    output_clarity = calculate_clarity_index(processed_audio[:min(len(processed_audio), CHUNK*10)], sample_rate)

    # クリッピング防止
    max_val = np.max(np.abs(processed_audio))
    if max_val > 0.99:
        processed_audio = processed_audio * (0.99 / max_val)

    # 改善効果の計算
    input_rms = np.sqrt(np.mean(audio**2))
    output_rms = np.sqrt(np.mean(processed_audio**2))

    print('\n【処理結果】')
    print(f'・音量変化: {20*np.log10(output_rms/(input_rms+1e-10)):+.1f}dB')
    print(f'・明瞭度改善: {((output_clarity-input_clarity)/max(input_clarity,0.01))*100:+.1f}%')

    # 保存オプション
    output_path = None
    if save_result:
        print('\n' + '-' * 60)
        save_choice = input('処理済み音声を保存しますか?(y/n): ').strip().lower()
        if save_choice == 'y':
            # タイムスタンプ付きファイル名
            timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
            output_path = f'processed_{timestamp}.wav'

            with AudioFile(output_path, 'w', samplerate=sample_rate, num_channels=1) as output_file:
                output_file.write(processed_audio)

            print(f'処理済み音声を保存しました: {output_path}')

    return output_path, sample_rate, processed_audio, original_sample_rate

def process_video_file(input_path):
    """動画ファイルから音声を抽出、処理、再合成"""
    from moviepy import VideoFileClip, AudioFileClip

    print(f'動画ファイルを読み込み中: {input_path}')
    video = VideoFileClip(input_path)

    if video.audio is None:
        print('動画に音声トラックがありません')
        return None

    # 元の音声のサンプルレートを取得(int型に変換)
    original_fps = int(video.audio.fps)

    # 音声を一時ファイルに抽出
    temp_audio = 'temp_audio.wav'
    temp_processed = 'temp_processed.wav'

    print('音声トラックを抽出中...')
    video.audio.write_audiofile(temp_audio, logger=None)

    # 音声処理(元のサンプルレートを維持)
    _, sr, processed_audio, _ = process_audio_file(temp_audio, save_result=False, target_sample_rate=original_fps)

    # 処理済み音声を一時ファイルに保存(元のサンプルレートで)
    with AudioFile(temp_processed, 'w', samplerate=original_fps, num_channels=1) as f:
        f.write(processed_audio)

    print('処理済み音声を動画に合成中...')

    # 処理済み音声を読み込み
    processed_audio_clip = AudioFileClip(temp_processed)

    # 動画に新しい音声を設定
    final_video = video.with_audio(processed_audio_clip)

    # 保存オプション
    output_path = None
    print('\n' + '-' * 60)
    save_choice = input('処理済み動画を保存しますか?(y/n): ').strip().lower()
    if save_choice == 'y':
        timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
        output_path = f'processed_video_{timestamp}.mp4'
        final_video.write_videofile(output_path, codec='libx264', audio_codec='aac', logger=None)
        print(f'処理済み動画を保存しました: {output_path}')

    # 一時ファイル削除
    os.remove(temp_audio)
    os.remove(temp_processed)
    video.close()
    processed_audio_clip.close()
    final_video.close()

    return output_path

def play_audio_file(file_path, sample_rate=None):
    """音声ファイルを再生"""
    with AudioFile(file_path, 'r') as f:
        audio = f.read(f.frames)
        file_sample_rate = f.samplerate
    if audio.ndim > 1:
        audio = np.mean(audio, axis=0)

    # サンプルレートの決定(引数が指定されていればそれを使用、なければファイルのレートを使用)
    playback_rate = sample_rate if sample_rate is not None else file_sample_rate

    p = pyaudio.PyAudio()
    stream = p.open(format=pyaudio.paFloat32,
                    channels=1,
                    rate=int(playback_rate),
                    output=True)

    # 小さなチャンクで再生
    chunk_size = 1024
    for i in range(0, len(audio), chunk_size):
        chunk = audio[i:i + chunk_size]
        stream.write(chunk.astype(np.float32).tobytes())

    stream.stop_stream()
    stream.close()
    p.terminate()

def keyboard_monitor():
    """キーボード入力を監視するスレッド"""
    global processing_active
    while processing_active:
        user_input = input()
        if user_input.lower() == 'q':
            processing_active = False
            stop_queue.put(True)
            break
        time.sleep(0.1)

def realtime_microphone_processing():
    """マイクからのリアルタイム処理(録音機能付き)"""
    global previous_rms, processing_active, start_time, last_stats_time, recorded_audio

    # 録音データをリセット
    recorded_audio = []

    def audio_callback(in_data, frame_count, time_info, status):
        global previous_rms, last_stats_time

        if not processing_active:
            return (None, pyaudio.paComplete)

        audio_data = np.frombuffer(in_data, dtype=np.float32)

        # RMS計算と平滑化
        current_rms = np.sqrt(np.mean(audio_data**2))
        smoothed_rms = SMOOTHING_FACTOR * previous_rms + (1 - SMOOTHING_FACTOR) * current_rms
        previous_rms = smoothed_rms

        # 統計収集
        with stats_lock:
            realtime_stats['total_frames'] += 1

            # 無音判定
            if smoothed_rms < SILENCE_THRESHOLD:
                realtime_stats['noise_reduced_frames'] += 1
                # 無音でも処理を実行して録音データの一貫性を保つ
                processed_audio = clarity_board(audio_data, sample_rate=RATE, reset=False)
                recorded_audio.append(processed_audio.copy())
                return (processed_audio.astype(np.float32).tobytes(), pyaudio.paContinue)

            realtime_stats['active_frames'] += 1

        # 明瞭度計算(定期的に、有音時のみ)
        current_time = time.time()
        calc_clarity = (current_time - last_stats_time) >= STATS_UPDATE_INTERVAL

        if calc_clarity:
            input_clarity = calculate_clarity_index(audio_data, RATE)

        # マルチバンド処理(reset=Falseでチャンク間のエフェクト状態を保持)
        processed_audio = clarity_board(audio_data, sample_rate=RATE, reset=False)

        # クリッピング防止
        max_val = np.max(np.abs(processed_audio))
        if max_val > 0.99:
            processed_audio = processed_audio * (0.99 / max_val)

        # 録音データに処理済み音声を追加
        recorded_audio.append(processed_audio.copy())

        # 統計更新
        output_rms = np.sqrt(np.mean(processed_audio**2))

        with stats_lock:
            realtime_stats['input_level_sum'] += current_rms
            realtime_stats['output_level_sum'] += output_rms

            if calc_clarity:
                output_clarity = calculate_clarity_index(processed_audio, RATE)
                realtime_stats['input_clarity_sum'] += input_clarity
                realtime_stats['output_clarity_sum'] += output_clarity
                realtime_stats['clarity_samples'] += 1
                last_stats_time = current_time

        return (processed_audio.astype(np.float32).tobytes(), pyaudio.paContinue)

    print('\nマイク入力のリアルタイム処理を開始します')
    print('処理済み音声をリアルタイムで再生中...')
    print("終了するには 'q' を入力して Enter を押してください")
    print('-' * 60)

    # 統計リセット
    with stats_lock:
        for key in realtime_stats:
            realtime_stats[key] = 0.0 if 'sum' in key or 'time' in key else 0

    # フラグリセット
    processing_active = True
    previous_rms = 0.0

    # キューをクリア
    while not stop_queue.empty():
        stop_queue.get()

    start_time = time.time()

    # キーボード監視スレッドを開始
    keyboard_thread = threading.Thread(target=keyboard_monitor, daemon=True)
    keyboard_thread.start()

    p = pyaudio.PyAudio()

    stream = p.open(format=FORMAT,
                    channels=CHANNELS,
                    rate=RATE,
                    input=True,
                    output=True,
                    frames_per_buffer=CHUNK,
                    stream_callback=audio_callback)

    stream.start_stream()

    # 定期的な状態表示
    last_display_time = time.time()

    while stream.is_active() and processing_active:
        # 終了チェック
        if not stop_queue.empty():
            stop_queue.get()
            processing_active = False
            break

        current_time = time.time()
        if current_time - last_display_time >= 5.0:  # 5秒ごとに簡易表示
            with stats_lock:
                if realtime_stats['active_frames'] > 0:
                    avg_input = realtime_stats['input_level_sum'] / realtime_stats['active_frames']
                    avg_output = realtime_stats['output_level_sum'] / realtime_stats['active_frames']
                    if avg_input > 1e-10:
                        print(f"処理中... 音量変化: {20*np.log10(avg_output/avg_input):+.1f}dB ('q' + Enter で終了)")
            last_display_time = current_time

        time.sleep(0.1)

    stream.stop_stream()
    stream.close()
    p.terminate()

    # 処理時間計算
    end_time = time.time()
    total_duration = end_time - start_time

    # 最終統計表示
    print('\n' + '=' * 60)
    print('【リアルタイム処理の改善効果】')
    print('=' * 60)

    with stats_lock:
        if realtime_stats['active_frames'] > 0:
            # 平均値計算
            avg_input_level = realtime_stats['input_level_sum'] / realtime_stats['active_frames']
            avg_output_level = realtime_stats['output_level_sum'] / realtime_stats['active_frames']

            # 明瞭度(実際に計算されたサンプル数を使用)
            if realtime_stats['clarity_samples'] > 0 and realtime_stats['input_clarity_sum'] > 0:
                avg_input_clarity = realtime_stats['input_clarity_sum'] / realtime_stats['clarity_samples']
                avg_output_clarity = realtime_stats['output_clarity_sum'] / realtime_stats['clarity_samples']
                clarity_improvement = ((avg_output_clarity - avg_input_clarity) / max(avg_input_clarity, 0.01)) * 100
            else:
                clarity_improvement = 0.0

            # 音量変化
            if avg_input_level > 1e-10:
                volume_change = 20 * np.log10(avg_output_level / avg_input_level)
            else:
                volume_change = 0.0

            # ノイズ除去率
            if realtime_stats['total_frames'] > 0:
                noise_reduction_rate = (realtime_stats['noise_reduced_frames'] / realtime_stats['total_frames']) * 100
                active_rate = (realtime_stats['active_frames'] / realtime_stats['total_frames']) * 100
            else:
                noise_reduction_rate = 0.0
                active_rate = 0.0

            print(f'処理時間: {total_duration:.1f}秒')
            print(f'処理フレーム数: {realtime_stats["total_frames"]:,}フレーム')
            print()
            print('【音声改善指標】')
            print(f'・音量変化: {volume_change:+.1f}dB')
            print(f'・明瞭度向上: {clarity_improvement:+.1f}%')
            print(f'・無音判定率: {noise_reduction_rate:.1f}%')
            print(f'・音声検出率: {active_rate:.1f}%')
            print()
            print('【レベル統計】')
            print(f'・平均入力レベル: {20*np.log10(avg_input_level+1e-10):.1f}dB')
            print(f'・平均出力レベル: {20*np.log10(avg_output_level+1e-10):.1f}dB')
        else:
            print('有効な音声データがありませんでした')

    # 録音データの保存
    if len(recorded_audio) > 0:
        print('\n' + '-' * 60)
        save_choice = input('録音した音声を保存しますか?(y/n): ').strip().lower()
        if save_choice == 'y':
            # タイムスタンプ付きファイル名
            timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
            output_filename = f'recorded_{timestamp}.wav'

            # 録音データを結合
            full_audio = np.concatenate(recorded_audio)

            # ファイルに保存
            with AudioFile(output_filename, 'w', samplerate=RATE, num_channels=1) as f:
                f.write(full_audio)

            print(f'録音を保存しました: {output_filename}')

            # 再生オプション
            play_choice = input('保存した音声を再生しますか?(y/n): ').strip().lower()
            if play_choice == 'y':
                play_audio_file(output_filename, RATE)

    print('\nマイク処理を終了しました')

def main():
    """メイン処理"""
    # 起動時のガイダンス表示
    print('=' * 60)
    print('マルチソース対応音声明瞭化システム')
    print('=' * 60)
    print('\n【概要説明】')
    print('このシステムは音声の明瞭度を向上させるための処理を行います。')
    print('マルチバンド周波数処理により、音声の聞き取りやすさを改善します。')
    print('\n【操作方法】')
    print('・メニューから入力ソースを選択してください')
    print("・マイク処理中は 'q' + Enter で終了できます")
    print('・処理結果は保存オプションで保存できます')
    print('\n【注意事項】')
    print('・マイク使用時は適切な入力デバイスが接続されていることを確認してください')
    print('-' * 60)
    input('Enterキーを押して開始...')

    while True:
        print('=' * 60)
        print('マルチソース対応音声明瞭化システム')
        print('=' * 60)
        print()
        print('【処理設定】')
        print(f'・ノイズゲート: {NOISE_GATE_THRESHOLD}dB')
        print(f'・低域(200Hz): {BAND_LOW_GAIN:+.1f}dB (濁音抑制)')
        print(f'・中域(1.5kHz): {BAND_MID_GAIN:+.1f}dB (母音明瞭度)')
        print(f'・高域(3kHz): {BAND_HIGH_GAIN:+.1f}dB (子音強調)')
        print()
        print('【入力ソース選択】')
        print('0: 音声ファイル・動画ファイル')
        print('1: マイク(リアルタイム処理・録音可能)')
        print('2: サンプル音声ファイル')
        print('-' * 60)

        try:
            choice = input('選択 (0/1/2): ').strip()

            if choice == '0':
                file_path = input('ファイルパスを入力してください: ').strip()
                if not os.path.exists(file_path):
                    print('ファイルが見つかりません')
                    input('\nEnterキーを押してメニューに戻ります...')
                    continue

                # 拡張子で判別
                ext = Path(file_path).suffix.lower()
                if ext in ['.mp4', '.avi', '.mov', '.mkv']:
                    process_video_file(file_path)
                else:
                    output_path, sr, audio, _ = process_audio_file(file_path)
                    if output_path is not None:
                        # 再生オプション
                        play_choice = input('処理済み音声を再生しますか?(y/n): ').strip().lower()
                        if play_choice == 'y':
                            play_audio_file(output_path, sr)

                input('\nEnterキーを押してメニューに戻ります...')

            elif choice == '1':
                realtime_microphone_processing()
                input('\nEnterキーを押してメニューに戻ります...')

            elif choice == '2':
                sample_path = download_sample_audio()
                output_path, sr, audio, _ = process_audio_file(sample_path)
                if output_path is not None:
                    # 再生オプション
                    play_choice = input('処理済み音声を再生しますか?(y/n): ').strip().lower()
                    if play_choice == 'y':
                        play_audio_file(output_path, sr)
                os.remove(sample_path)

                input('\nEnterキーを押してメニューに戻ります...')

            else:
                print('無効な選択です')
                input('\nEnterキーを押してメニューに戻ります...')

        except KeyboardInterrupt:
            print('\n\nプログラムを終了します')
            break

if __name__ == '__main__':
    main()