
XGBoost機械学習体験
【概要】
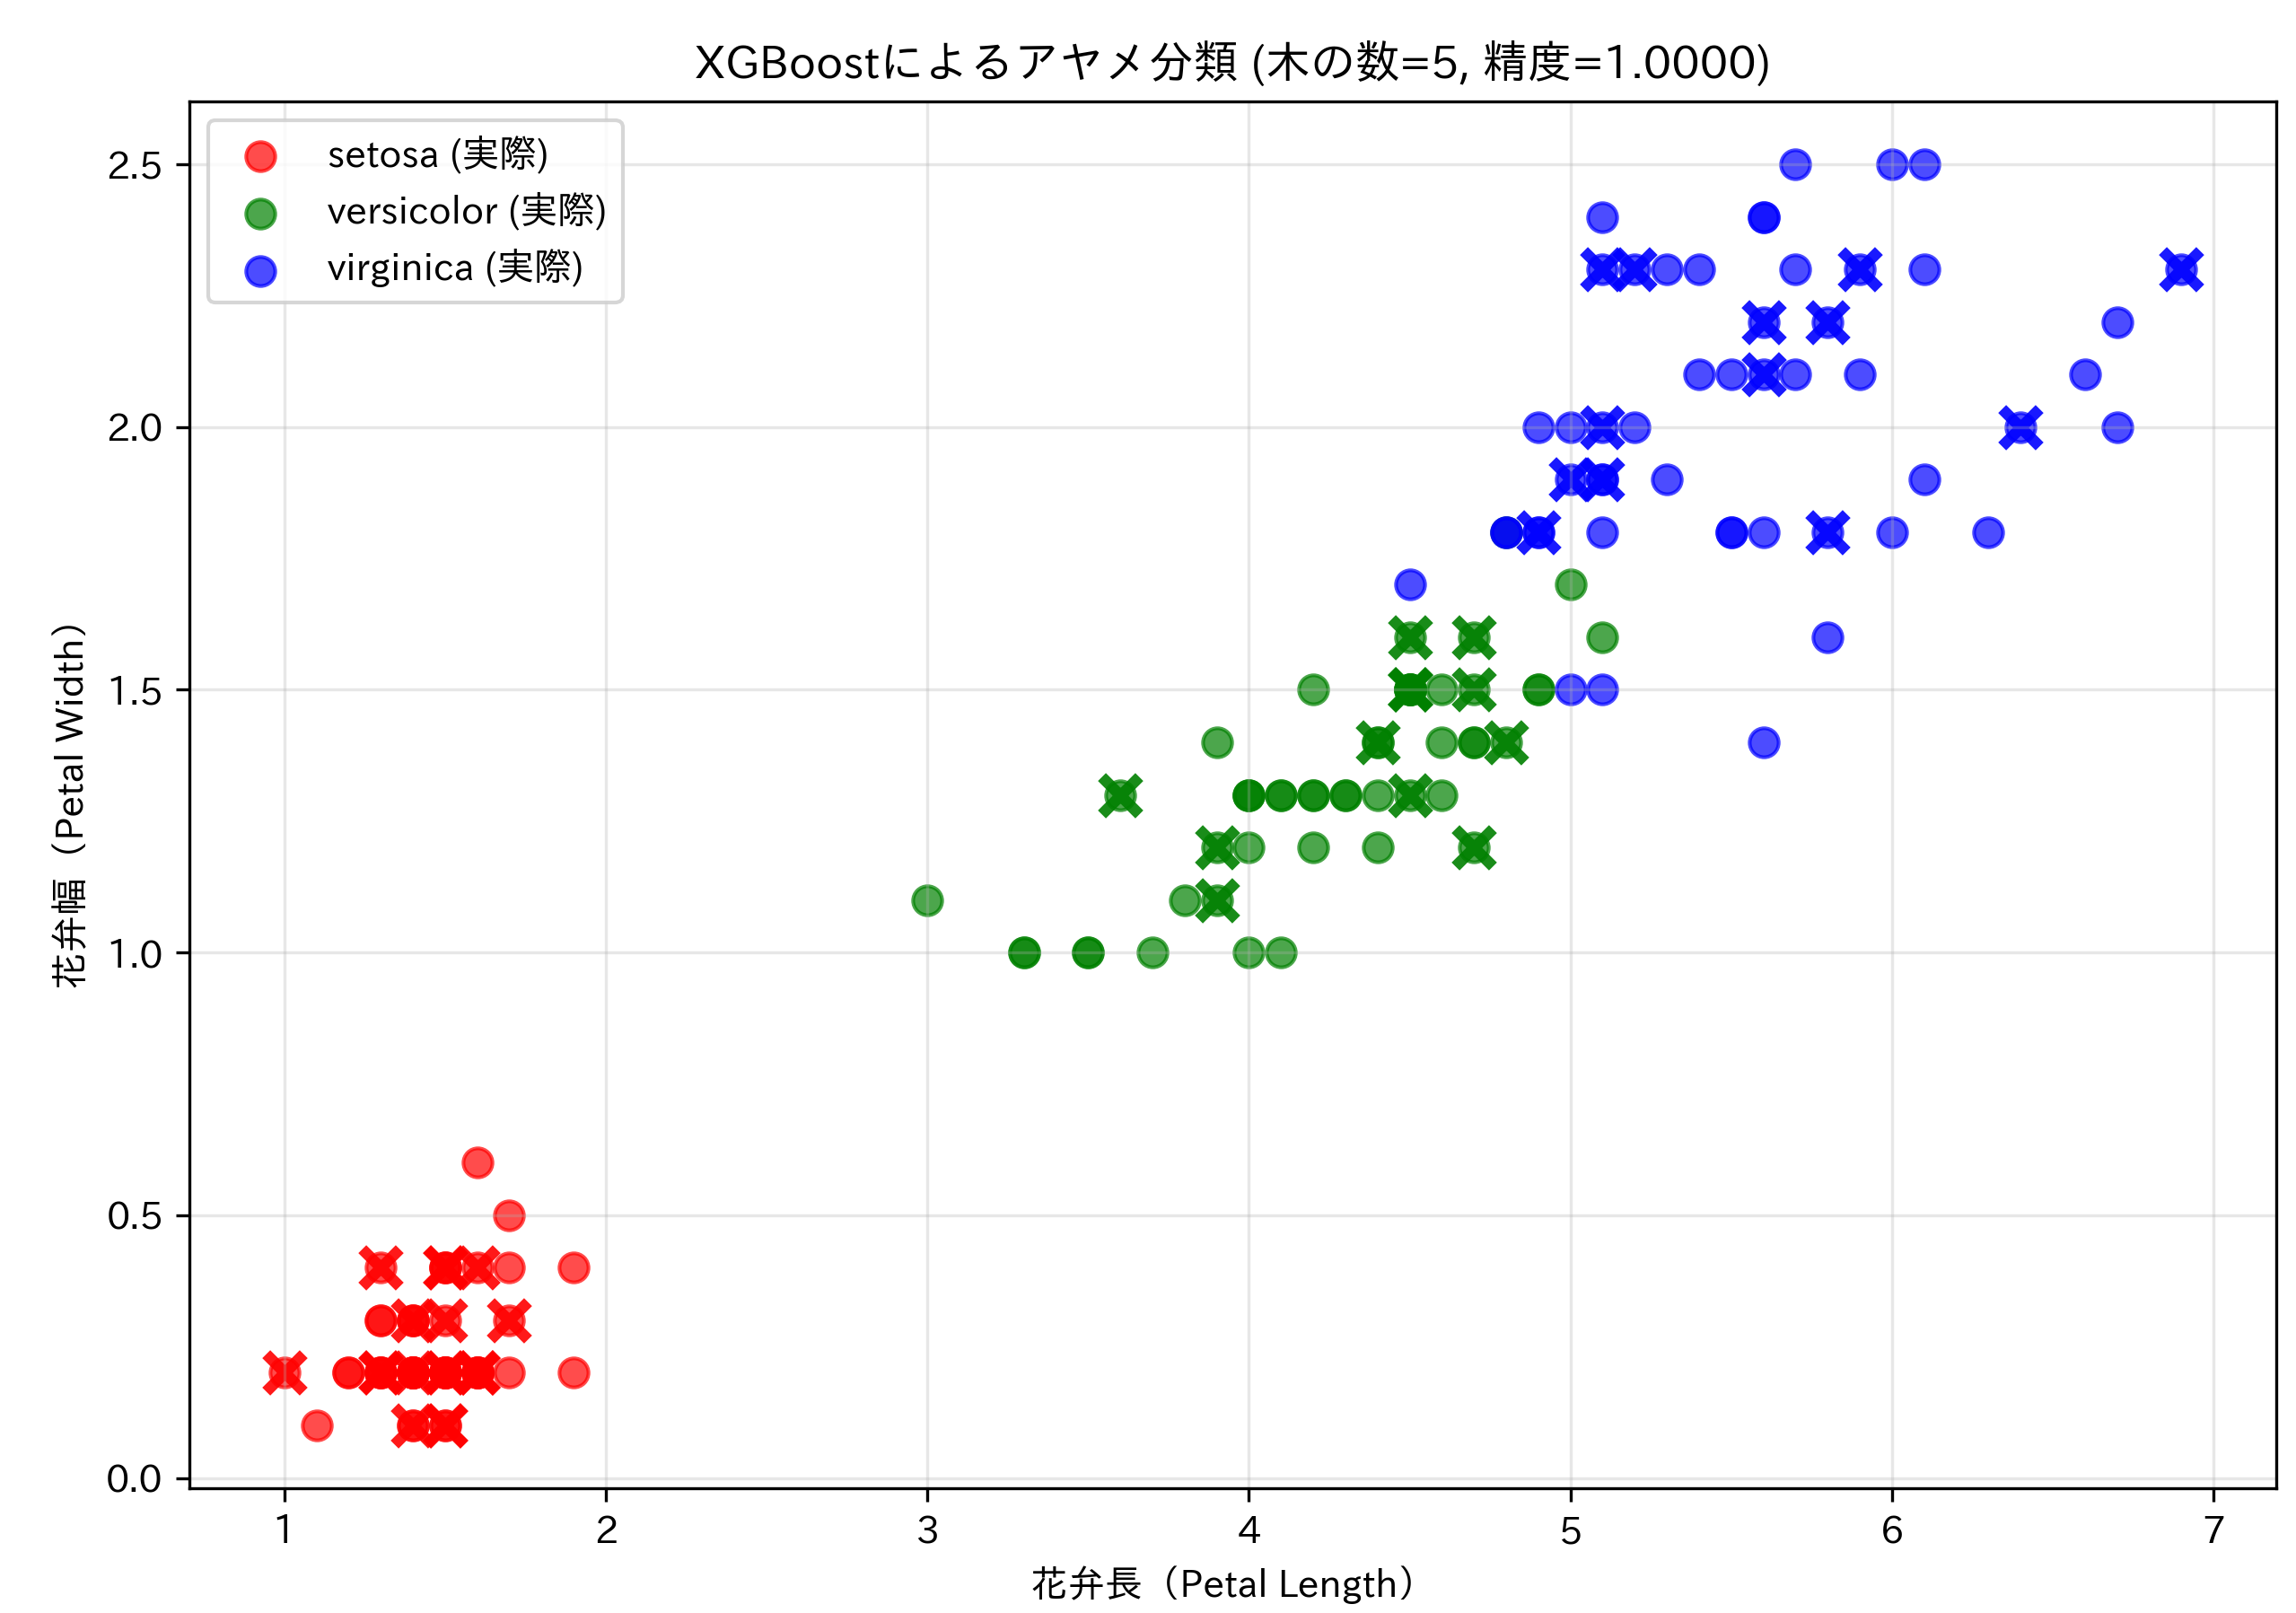
XGBoostによるIrisデータセットの分類を行う。決定木の数を変更して正解率の変化を観察し、機械学習の弱学習器を組み合わせる考え方を体験する。
機械学習基礎概念:機械学習では、過学習(モデルが訓練データに過度に適合し、新しいデータで性能が低下する現象)を防ぐため、正則化(モデルの複雑さに対するペナルティ)を導入する。アンサンブル学習(複数の学習器を組み合わせる手法)により、単一モデルより高い正解率を実現する。
主要技術:XGBoost(eXtreme Gradient Boosting)は、勾配ブースティング決定木(複数の弱い決定木を順次組み合わせる手法)の拡張アルゴリズムである。従来手法からの主な改良点は、正則化による過学習抑制、二次近似による高速化、列サンプリングによる精度向上である。
論文:Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD international conference on knowledge discovery and data mining (pp. 785-794).
応用例:金融リスク評価、医療診断支援、マーケティング顧客分析、画像認識の後処理分類器
学習目標:決定木の数を変更することで正解率の変化を観察し、アンサンブル学習の考え方を理解する。Irisデータセットを用いた3クラス分類により、分類結果の形成過程を体験する。
【目次】
1. 事前準備
ここでは、最低限の事前準備について説明する。機械学習や深層学習を行う場合は、NVIDIA CUDA、Visual Studio、Cursorなどを追加でインストールすると便利である。これらについては別ページ https://www.kkaneko.jp/cc/dev/aiassist.html で解説しているので、必要に応じて参照する。
2. Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
3. Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する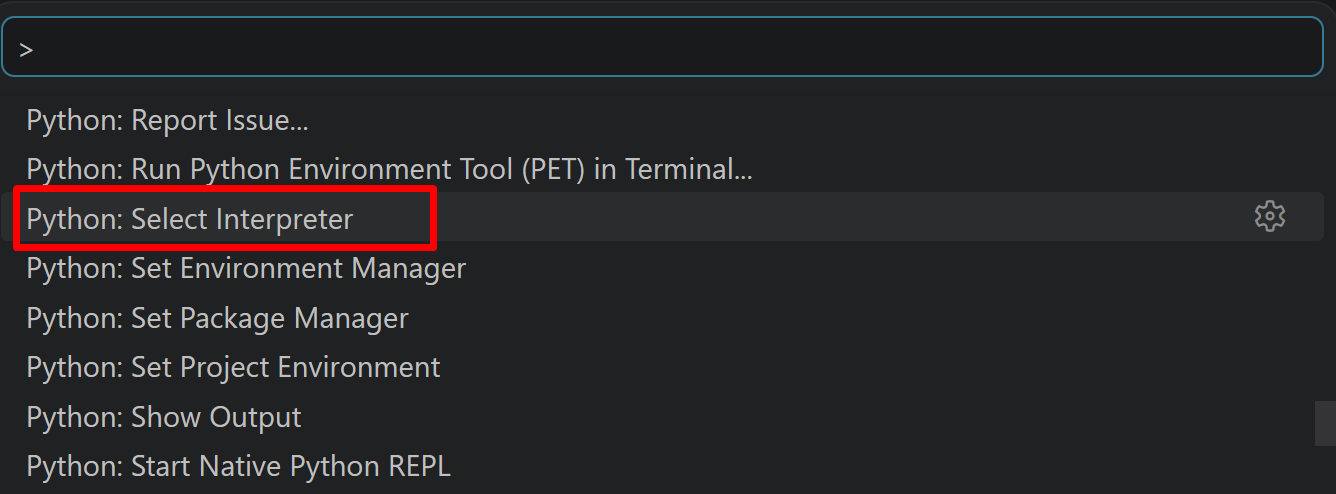
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.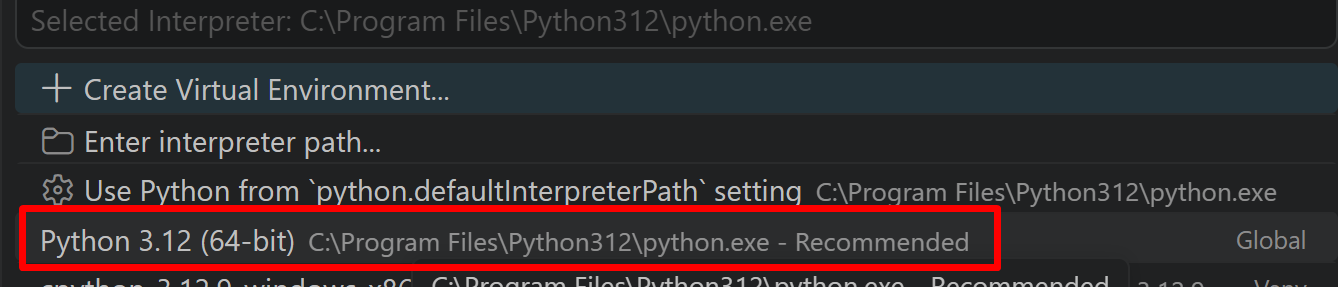
必要なライブラリをシステム領域にインストール
管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
次のコマンドを実行する。
set "PYTHON_PATH=C:\Program Files\Python312"
"%PYTHON_PATH%\Scripts\pip" install -U --no-user numpy xgboost scikit-learn matplotlib matplotlib-fontja
4. プログラムコード
概要
このプログラムは、XGBoostアルゴリズムを使用してIrisデータセット(アヤメの品種データ)の分類を行う。Irisデータセットに含まれる3種類のアヤメ(setosa、versicolor、virginica)を分類し、結果を花弁の長さと幅の2次元平面上に表示する。プログラム内でモデルの学習から評価、結果の可視化までを一貫して実行する。
主要技術
XGBoost(eXtreme Gradient Boosting)
XGBoostは、Chen と Guestrin によって2016年に発表された勾配ブースティング決定木アルゴリズムである[1]。このアルゴリズムは、複数の弱学習器(決定木)を逐次的に学習させる手法を採用している。各決定木は前の木の予測誤差に着目して学習を行い、最終的な予測はすべての木の出力を統合して生成される。正則化項の導入により過学習を抑制し、並列処理による計算効率の向上を実現している[1]。
技術的特徴
- 過学習防止機構:
max_depth=2という浅い決定木を使用することで、モデルの複雑さを制限し、過学習を防ぐ - 再現性の確保:
random_state=42を固定することで、実行ごとに同一の結果を得られるようにしている - パラメータ調整機能:
n_estimators(ブースティング木の数)を対話的に設定でき、モデルの複雑さを調整できる - データ分割:scikit-learnの
train_test_split関数を使用し、データの70%を訓練用、30%をテスト用に分割[2]
実装の特色
- 2画面並列可視化:matplotlibの
subplots機能を活用し、訓練データとテストデータの分類結果を左右に並べて表示する。これにより、過学習の有無を視覚的に確認できる - 結果表示:花弁長(Petal Length)と花弁幅(Petal Width)の2次元散布図で結果を表示する。実際のクラスを円形マーカー、予測結果を×マーカーで区別し、分類の成否を判断できるようにしている
- 色分けによる品種識別:3種類のアヤメを赤(setosa)、緑(versicolor)、青(virginica)で色分けする
- 処理結果の保存:実行時刻、パラメータ設定、正解率の評価結果を
result.txtファイルに保存し、実験の記録に利用できるようにしている
性能評価
プログラムは訓練データとテストデータの両方で正解率を算出し、モデルの汎化性能を評価する。scikit-learnのaccuracy_score関数を使用して正解率を計算する[2]。n_estimatorsを適切に設定した場合、テストデータで90%以上の正解率が得られる。
参考文献
[1] Chen, T., & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785-794). ACM. https://doi.org/10.1145/2939672.2939785
[2] Pedregosa, F., et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.org/papers/v12/pedregosa11a.html
ソースコード
# プログラム名: XGBoostによるIrisデータセット分類
# 特徴技術名: XGBoost(eXtreme Gradient Boosting)
# 出典: Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785-794). ACM.
# 特徴機能: 勾配ブースティング決定木による分類。前の木の予測誤差を次の木で修正する逐次学習により、単一の決定木より高い正解率を実現
# 学習済みモデル: なし(プログラム内でIrisデータセットを用いて学習)
# 方式設計:
#   - 関連利用技術: scikit-learn(データセット読み込み、データ分割、評価指標)、matplotlib(結果可視化)、matplotlib-fontja(日本語表示)、numpy(数値計算)
#   - 入力と出力: 入力: なし(内蔵データセット使用)、出力: 分類結果の可視化グラフとテキスト
#   - 処理手順: 1)Irisデータセット読み込み、2)訓練・テストデータ分割、3)XGBoostモデル学習、4)テストデータで予測、5)正解率評価、6)結果可視化
#   - 前処理、後処理: 前処理: train_test_splitによるデータ分割(過学習防止)、後処理: 花弁長・幅による2次元可視化(理解しやすさ向上)
#   - 追加処理: ブースティング木の概念説明表示(教育効果向上)、図の読み方説明表示(結果解釈支援)
#   - 調整を必要とする設定値: n_estimators(ブースティング木の数、デフォルト5、範囲1-100推奨)
# 将来方策: グリッドサーチによる最適n_estimators自動探索機能の実装(交差検証による正解率最大化)
# その他の重要事項: max_depth=2で浅い木を使用(過学習防止)、乱数シード固定で再現性確保
# 前準備: pip install -U --no-user numpy xgboost scikit-learn matplotlib matplotlib-fontja

import matplotlib.pyplot as plt
import matplotlib_fontja
import numpy as np
from sklearn.datasets import load_iris
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from xgboost import XGBClassifier
import time

# 定数定義
RANDOM_SEED = 42  # 再現性のための乱数シード
DEFAULT_N_ESTIMATORS = 5
TEST_SIZE = 0.3
MAX_DEPTH = 2

# 可視化用定数
COLORS = ['red', 'green', 'blue']
TARGET_NAMES = ['setosa', 'versicolor', 'virginica']

# プログラム開始時の概要表示
print('=' * 60)
print('XGBoostによるIrisデータセット分類プログラム')
print('=' * 60)
print('概要: XGBoostを使用してアヤメの品種を分類します')
print('特徴: 勾配ブースティング決定木による分類')
print('入力: Irisデータセット(プログラム内蔵)')
print('出力: 分類結果の可視化と正解率評価')
print('=' * 60)

# 結果記録用リスト
results = []

print('\n【ブースティング木とは】')
print('複数の弱い決定木を順次学習し、前の木の誤りを次の木で修正する手法')
print('・各木は前の木の予測誤差に注目して学習')
print('・最終予測は全ての木の予測を重み付き平均で統合')
print('・単一の木より高い正解率、過学習しにくい特性')
print('=' * 60)

# パラメータ設定
inp = input(f'\nn_estimators(ブースティング木の数、デフォルト{DEFAULT_N_ESTIMATORS})を入力してください: ')
if inp.strip() and inp.strip().isdigit() and int(inp.strip()) > 0:
    n_estimators = int(inp.strip())
else:
    n_estimators = DEFAULT_N_ESTIMATORS

# 処理開始
start_time = time.time()
results.append(f'処理開始時刻: {time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())}')
results.append(f'設定パラメータ: n_estimators={n_estimators}')

# データ読み込み
print('\nデータ読み込み中...')
X, y = load_iris(return_X_y=True)
results.append(f'データサイズ: {X.shape[0]}サンプル, {X.shape[1]}特徴量')

# データ分割
print('データ分割中...')
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=TEST_SIZE, random_state=RANDOM_SEED)
results.append(f'訓練データ: {X_train.shape[0]}サンプル')
results.append(f'テストデータ: {X_test.shape[0]}サンプル')

# モデル学習
print('モデル学習中...')
model = XGBClassifier(
    n_estimators=n_estimators,
    max_depth=MAX_DEPTH,
    random_state=RANDOM_SEED
)
model.fit(X_train, y_train)
results.append('モデル学習完了')

# 予測と評価
print('予測実行中...')
# 訓練データの予測
train_preds = model.predict(X_train)
train_accuracy = accuracy_score(y_train, train_preds)

# テストデータの予測
test_preds = model.predict(X_test)
test_accuracy = accuracy_score(y_test, test_preds)

results.append(f'訓練データ正解率: {train_accuracy:.4f}')
results.append(f'テストデータ正解率: {test_accuracy:.4f}')
print(f'訓練データ正解率: {train_accuracy:.4f}')
print(f'テストデータ正解率: {test_accuracy:.4f}')

# 処理時間計算
elapsed = time.time() - start_time
results.append(f'処理時間: {elapsed:.2f}秒')

# 結果出力
print()
print('=' * 60)
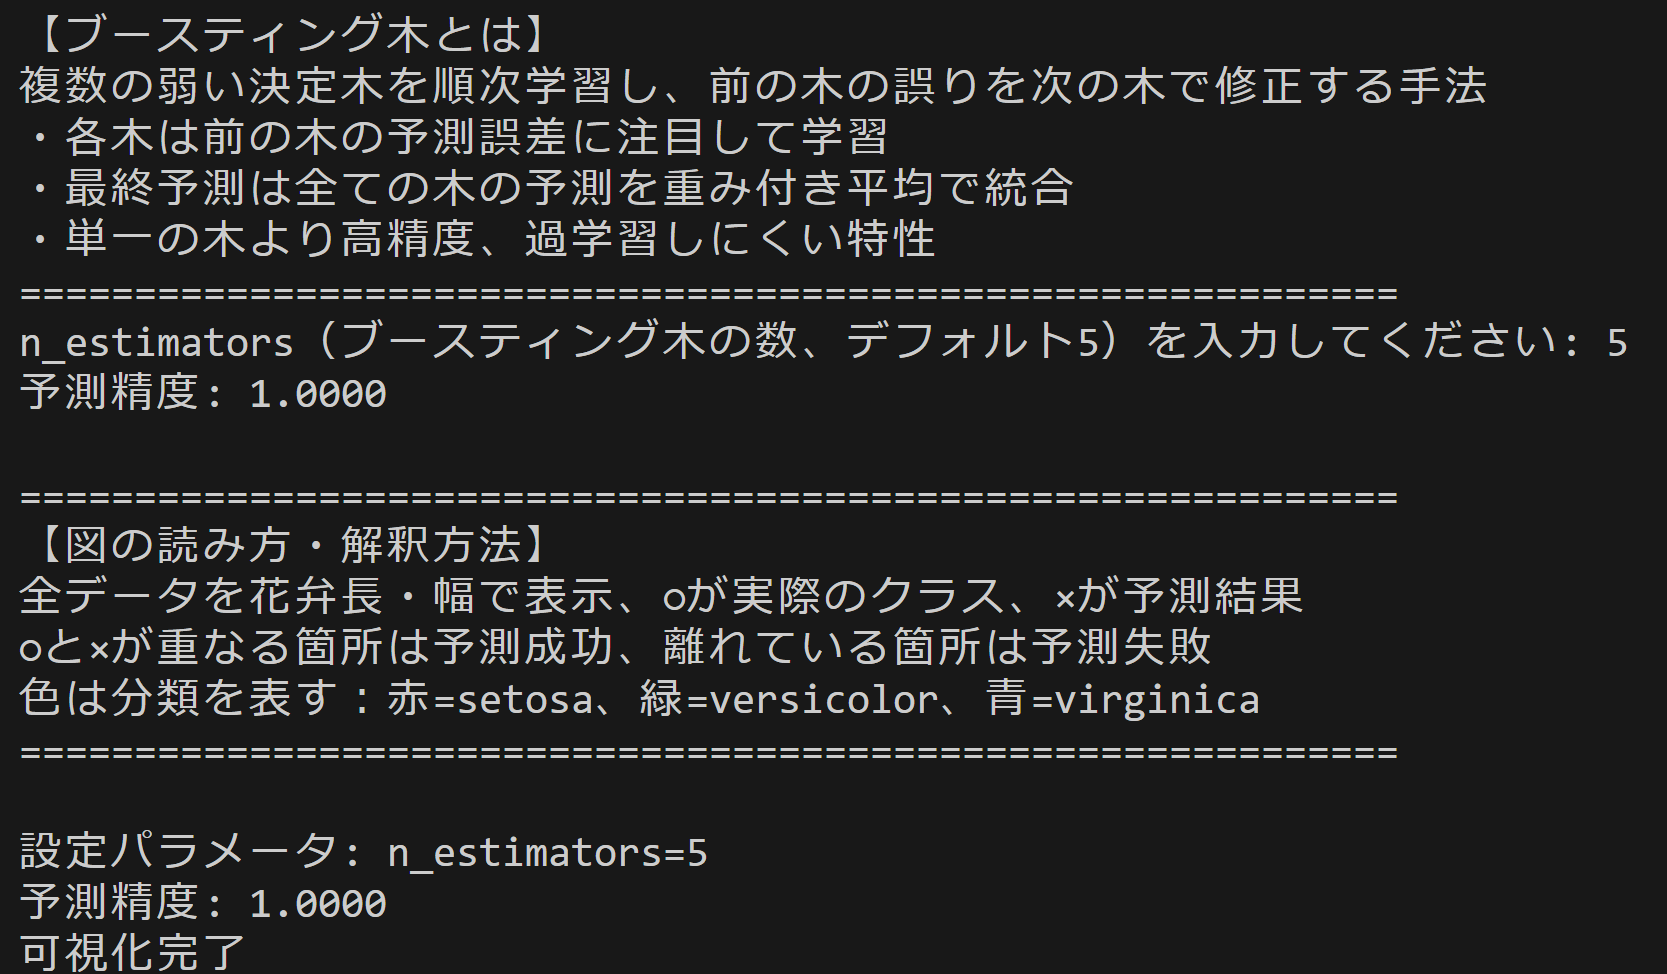
print('【図の読み方・解釈方法】')
print('花弁長・幅で2次元表示、○が実際のクラス、×が予測結果')
print('○と×が重なる箇所は予測成功、離れている箇所は予測失敗')
print('色は分類を表す:赤=setosa、緑=versicolor、青=virginica')
print('左図:訓練データ、右図:テストデータ')
print('=' * 60)

# 可視化(2画面表示)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))

# 訓練データの可視化
ax1.set_title(f'訓練データ (正解率={train_accuracy:.4f})')
for i, (color, name) in enumerate(zip(COLORS, TARGET_NAMES)):
    # 実際のクラス
    train_mask_actual = y_train == i
    if np.any(train_mask_actual):
        ax1.scatter(X_train[train_mask_actual, 2], X_train[train_mask_actual, 3],
                    c=color, marker='o', label=f'{name} (実際)', alpha=0.5, s=100)

    # 予測結果
    train_mask_pred = train_preds == i
    if np.any(train_mask_pred):
        ax1.scatter(X_train[train_mask_pred, 2], X_train[train_mask_pred, 3],
                    c=color, marker='x', label=f'{name} (予測)', s=150, linewidth=3, alpha=0.9)

ax1.set_xlabel('花弁長(Petal Length)')
ax1.set_ylabel('花弁幅(Petal Width)')
ax1.legend(loc='upper left', fontsize=9)
ax1.grid(True, alpha=0.3)

# テストデータの可視化
ax2.set_title(f'テストデータ (正解率={test_accuracy:.4f})')
for i, (color, name) in enumerate(zip(COLORS, TARGET_NAMES)):
    # 実際のクラス
    test_mask_actual = y_test == i
    if np.any(test_mask_actual):
        ax2.scatter(X_test[test_mask_actual, 2], X_test[test_mask_actual, 3],
                    c=color, marker='o', label=f'{name} (実際)', alpha=0.5, s=100)

    # 予測結果
    test_mask_pred = test_preds == i
    if np.any(test_mask_pred):
        ax2.scatter(X_test[test_mask_pred, 2], X_test[test_mask_pred, 3],
                    c=color, marker='x', label=f'{name} (予測)', s=150, linewidth=3, alpha=0.9)

ax2.set_xlabel('花弁長(Petal Length)')
ax2.set_ylabel('花弁幅(Petal Width)')
ax2.legend(loc='upper left', fontsize=9)
ax2.grid(True, alpha=0.3)

plt.suptitle(f'XGBoostによるアヤメ分類 (木の数={n_estimators})', fontsize=14)
plt.tight_layout()
plt.show()

# 最終結果表示
print(f'\n設定パラメータ: n_estimators={n_estimators}')
print(f'訓練データ正解率: {train_accuracy:.4f}')
print(f'テストデータ正解率: {test_accuracy:.4f}')
print('可視化完了')

# 結果をファイルに保存
with open('result.txt', 'w', encoding='utf-8') as f:
    f.write('\n'.join(results) + '\n')
print('result.txtに保存しました')
5. 使用方法と評価
- プログラム実行:上記のプログラムを実行する。
- パラメータ入力:
n_estimators(ブースティング木の数)の入力を求められる。数値を入力するか、Enterキーでデフォルト値(5)を使用する。 - 結果確認:正解率が数値で表示され、続いてグラフが表示される。
- グラフ解釈:花弁長・花弁幅の2次元プロット上で、○印が実際のクラス、×印が予測結果を示す。
評価手法と解釈:訓練データとテストデータを分離することで、モデルの汎化性能(未知データに対する予測の正しさ)を評価する。XGBoostは複雑なモデルであるが、特徴量重要度により各特徴量の予測への寄与度を把握できる。
ハイパーパラメータの調整:n_estimators(木の数)は多いほど複雑なパターンを学習するが、過学習のリスクも増加する。max_depth(木の深さ)は深いほど詳細な分岐が可能になるが、計算コストと過学習のリスクが増加する。learning_rate(学習率)は小さいほど安定した学習を行うが、収束に時間を要する。
6. 実験・探求のアイデア
基本実験
n_estimators:1、5、10、50、100での正解率の変化の観察max_depth:1、2、3、5での分類結果の変化learning_rate:0.1、0.3、1.0での学習の進み方と正解率のトレードオフ
モデル比較とデータ処理
XGBClassifier、RandomForestClassifier(複数の決定木を並列に学習)、DecisionTreeClassifier(単一決定木)の性能比較- 特徴量の前処理:標準化や正規化による性能への影響の観察
- 特徴量重要度分析:
model.feature_importances_による4つの特徴量(萼片長・幅、花弁長・幅)の重要度ランキングの可視化
発展的探求
- パラメータ効果検証:
n_estimatorsを1から100まで段階的に変更し、正解率が頭打ちになる点を見つける。 - ハイパーパラメータ最適化:格子探索(グリッドサーチ)による交差検証を使用して最適なパラメータの組み合わせを自動探索し、手動調整との違いを比較する。