
YOLOv8による物体検出(Open Images V7)(ソースコードと説明と利用ガイド)
【概要】
YOLOv8とOpen Images V7データセットを用いたリアルタイム物体検出プログラムである。Open Images V7の学習済みモデルは601クラスを識別でき、動画ファイルやカメラ映像から物体を検出・追跡する。CLAHE前処理により低照度環境での視認性を高め、ByteTrackにより、オクルージョン(物体の一時的な隠れ)が生じた場合も追跡を継続する。TTAにより検出漏れを抑える。5種類のモデルサイズ(n, s, m, l, x)から選択でき、検出結果をテキストファイルに保存する。
【目次】
第1章 プログラム利用ガイド
このプログラムの利用シーン
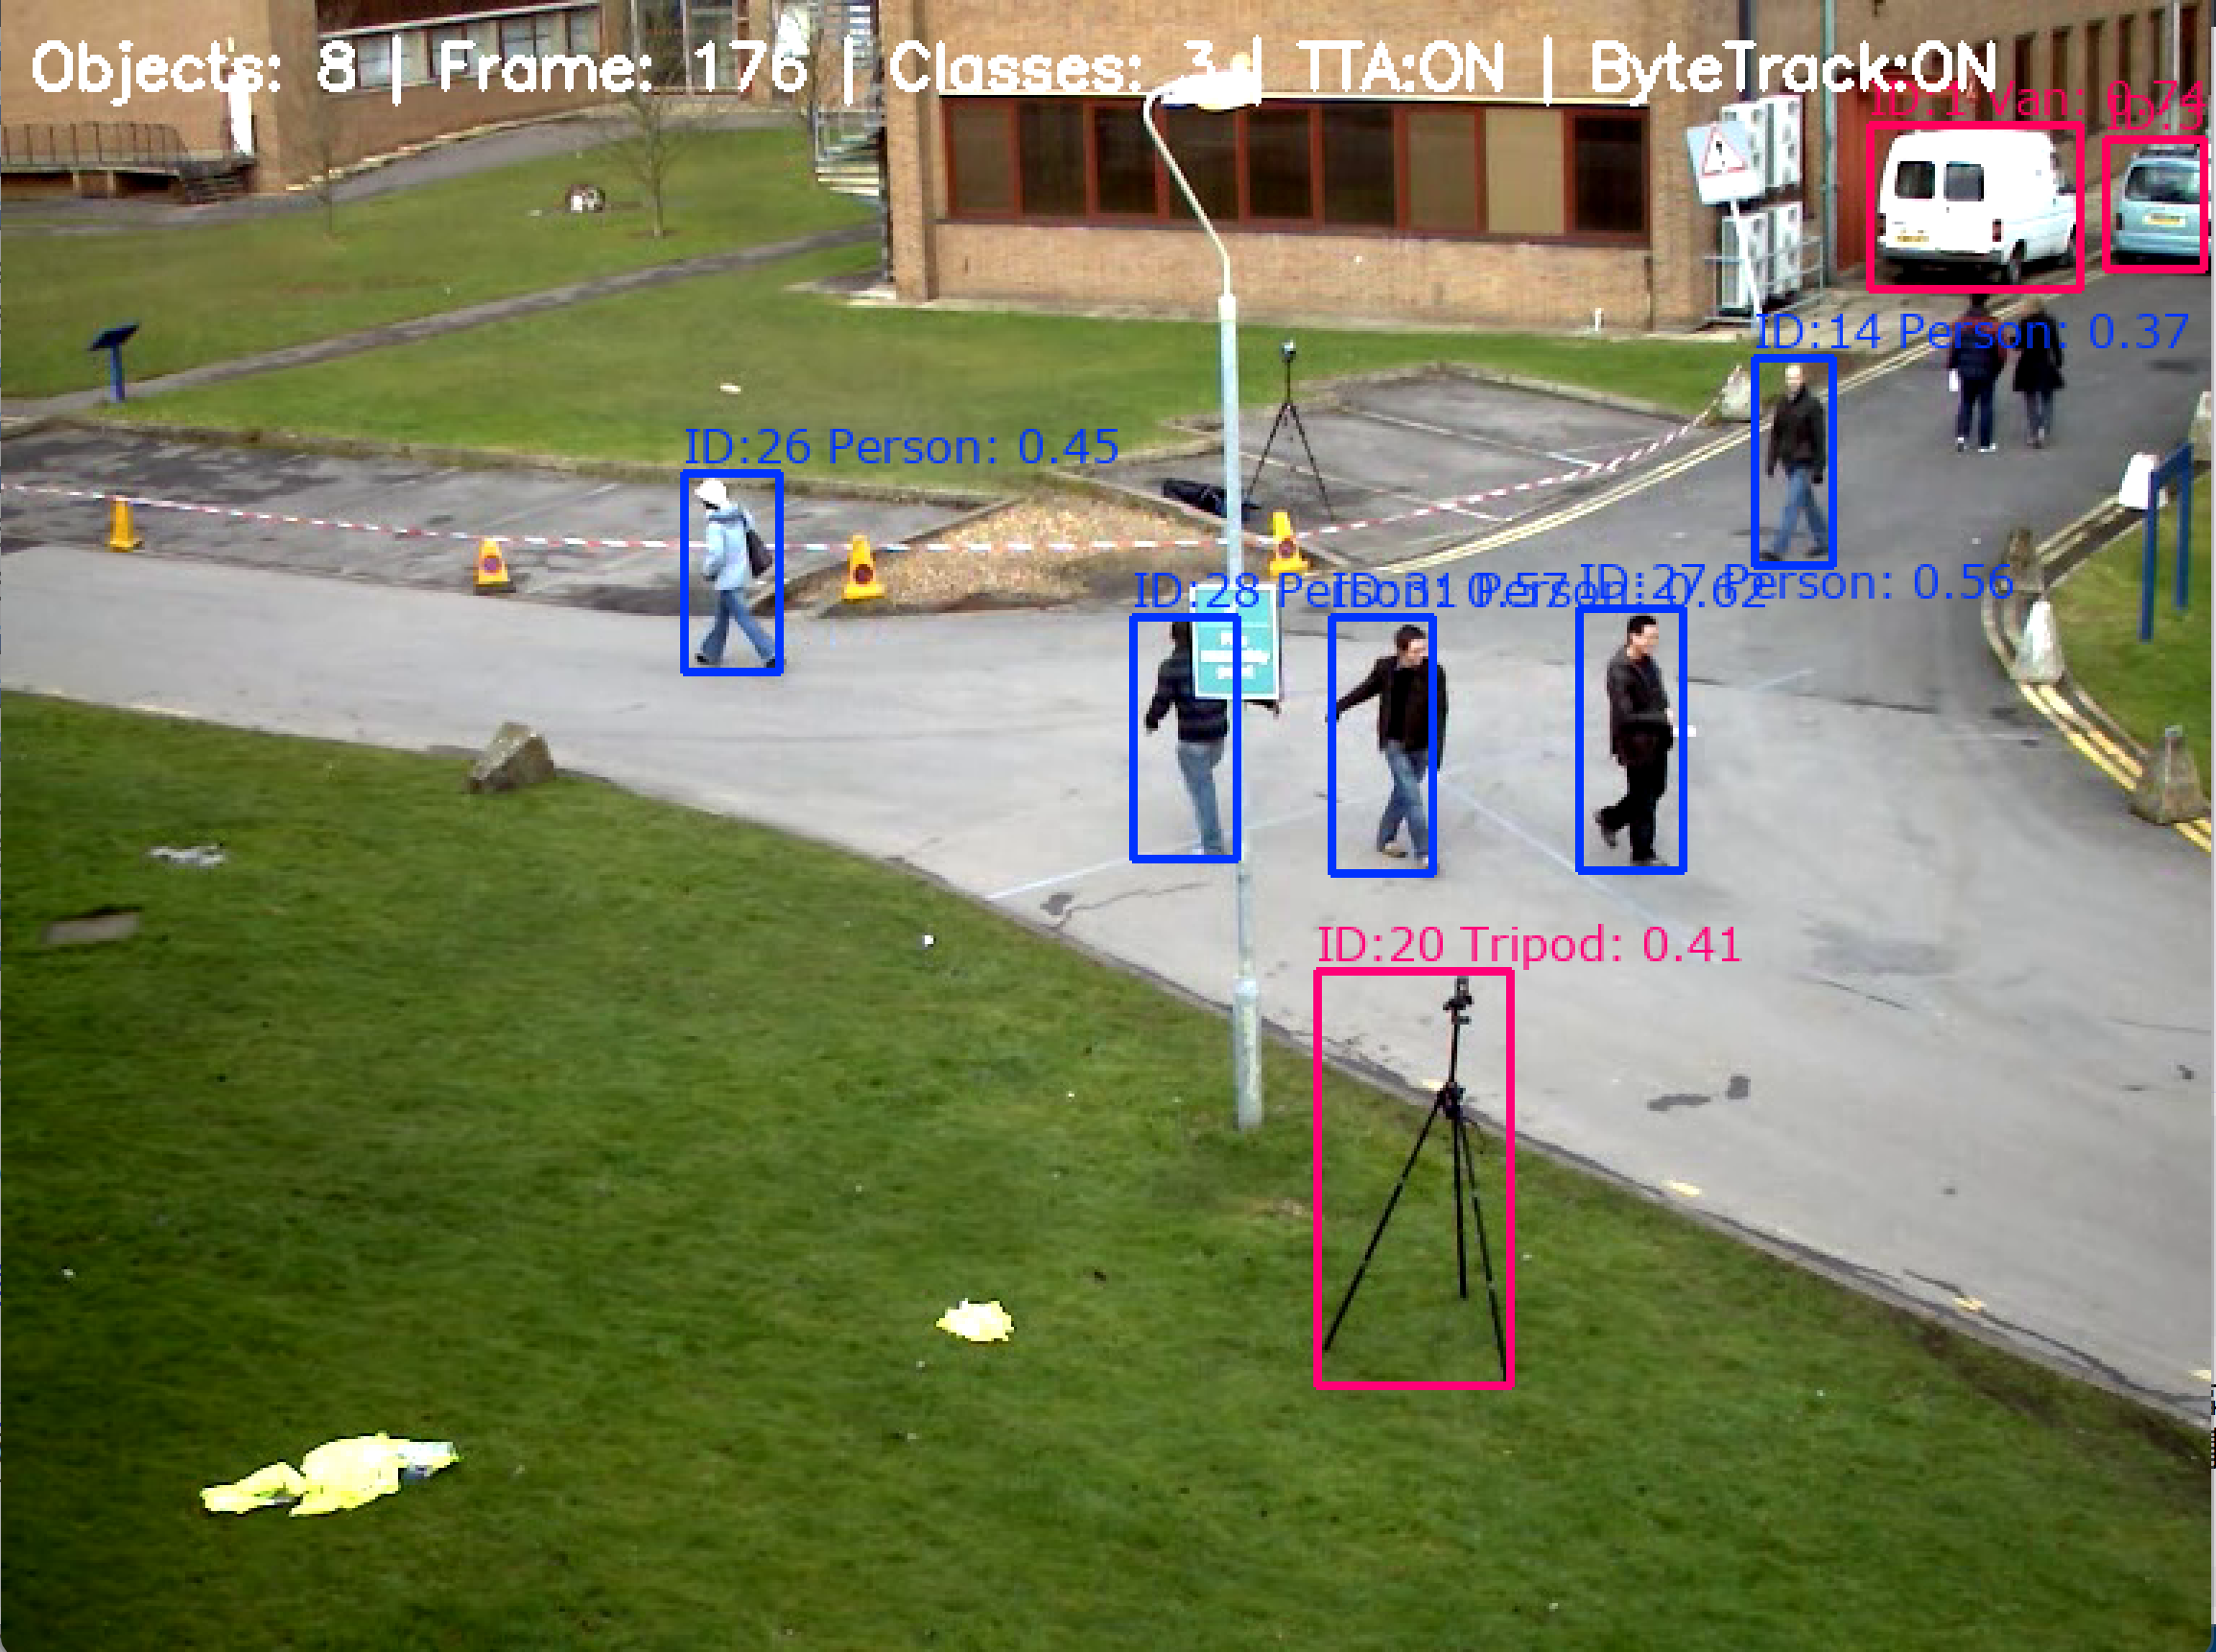
動画ファイルやカメラ映像に映る多種多様な物体を、リアルタイムで識別し、追跡するためのツールである。交通量調査、店舗内の人物動線分析、スポーツ映像の解析といった場面で利用される。
主な機能
- リアルタイム物体検出・追跡: 映像内の物体を検出し、それぞれに固有のID(追跡番号)を割り当てて追跡する。
- モデル選択機能: 処理速度と精度のバランスが異なる5種類のモデル(n, s, m, l, x)から、用途に応じて選択できる。
- 入力ソースの選択: ローカルの動画ファイル、カメラ、サンプル動画の3種類から入力映像を選択できる。
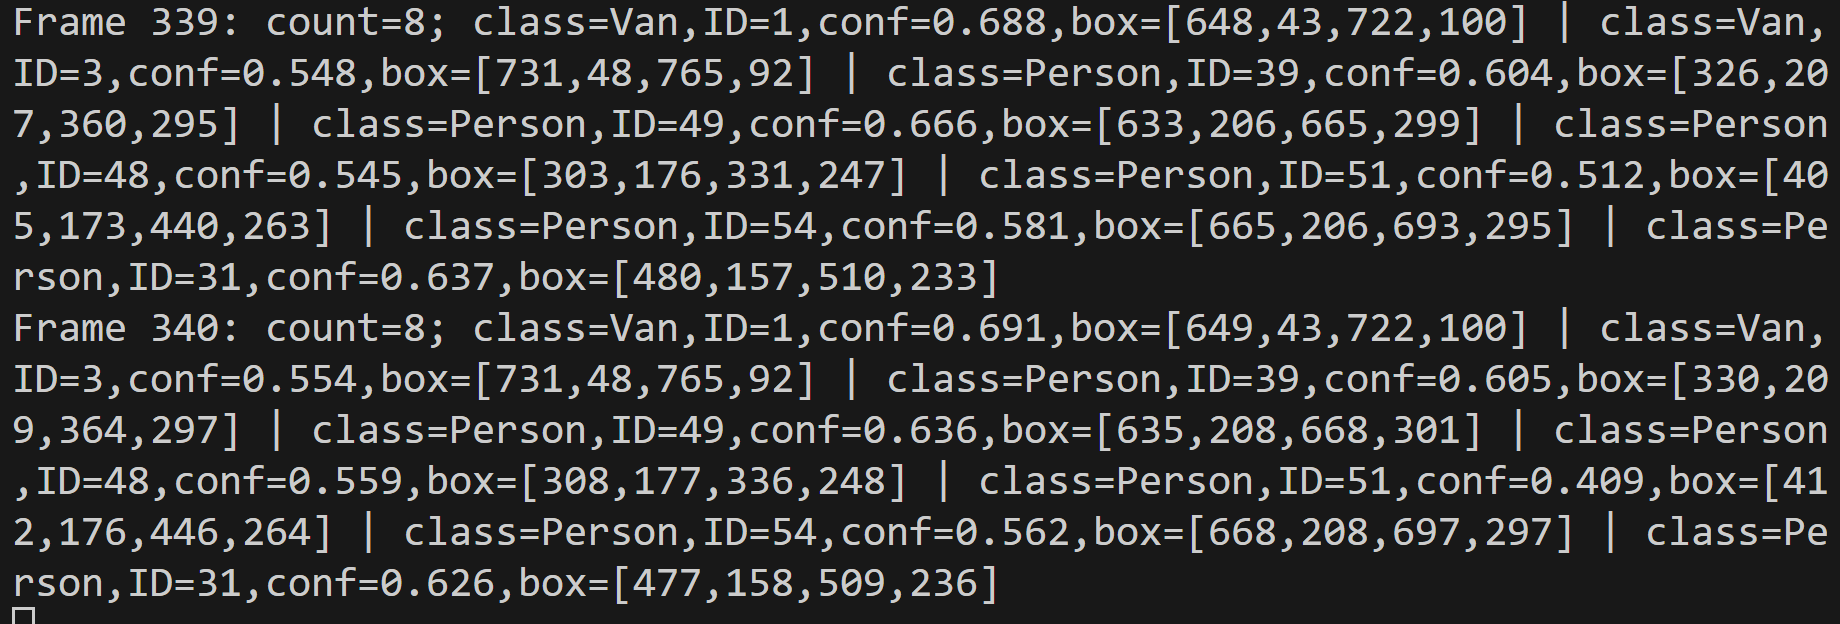
- 結果の可視化と保存: 検出した物体の位置、クラス名、追跡IDを画面に表示し、全てのフレームの処理結果を終了時にテキストファイル(result.txt)へ保存する。
基本的な使い方
-
プログラムの起動:
コンソールでプログラムを実行する。
-
モデルの選択:
最初に表示される指示に従い、使用するモデルのキー(n, s, m, l, x のいずれか)を入力し、Enterキーを押す。何も入力せずEnterキーを押すと s が選ばれる。
-
入力ソースの選択:
次に表示される指示に従い、入力ソースの番号(0: 動画ファイル, 1: カメラ, 2: サンプル動画)を入力し、Enterキーを押す。0を選んだ場合は、ファイル選択ダイアログが開く。
-
結果の確認:
処理結果が描画されたウィンドウが開き、リアルタイムで検出・追跡の様子を確認できる。コンソールにも各フレームの検出情報が出力される。
-
プログラムの終了:
結果表示ウィンドウが選択された状態で、キーボードの q キーを押すとプログラムが終了する。
便利な機能
- 精度向上のための内部処理: 暗い場所での検出精度を上げるCLAHEと、検出漏れを減らすTTAが、標準で有効になっている。
- 詳細なログファイル: プログラム終了後、カレントディレクトリ(プログラムを実行したディレクトリ)に生成される result.txt には、使用した設定やフレームごとの検出結果が記録されており、後の分析に利用できる。
第2章 事前準備
ここでは、最低限の事前準備について説明する。機械学習や深層学習を行う場合は、NVIDIA CUDA、Visual Studio、Cursorなどを追加でインストールすると便利である。これらについては別ページ https://www.kkaneko.jp/cc/dev/aiassist.html で説明しているので、必要に応じて参照する。
第3章 Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
第4章 Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する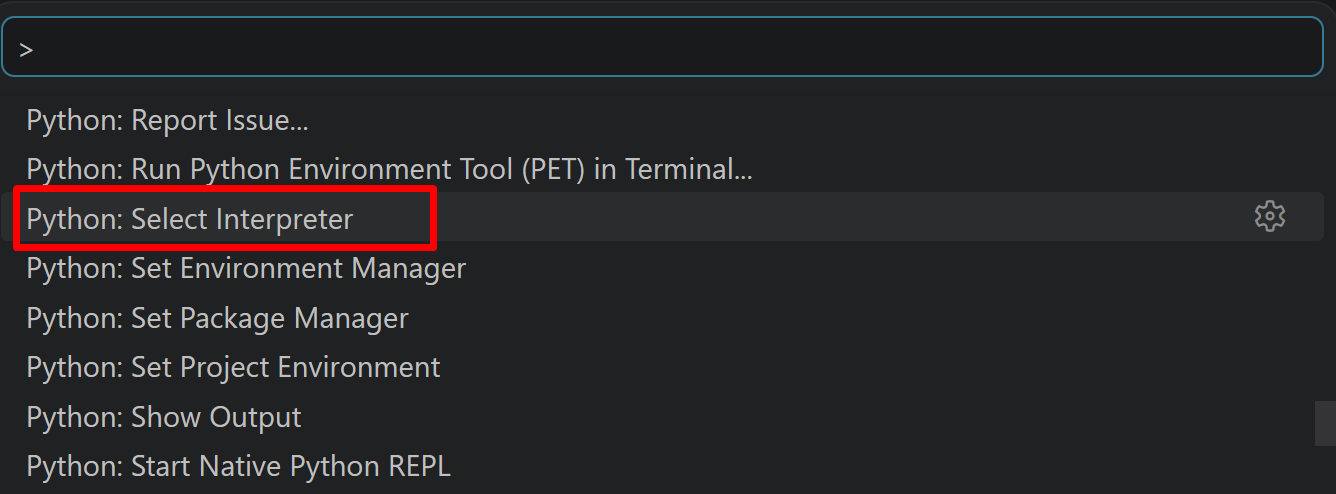
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.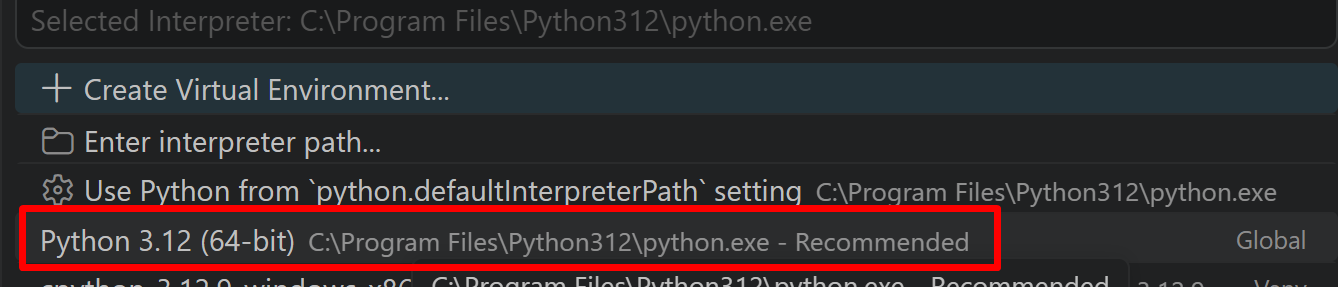
第5章 必要なパッケージのインストール
管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
REM Python 3.12 環境へインストールする
set "PYTHON_PATH=C:\Program Files\Python312"
"%PYTHON_PATH%\Scripts\pip" install --no-user -U ultralytics opencv-python numpy pillow boxmot
REM PyTorch を CUDA 12.8 対応版で上書きインストールする
"%PYTHON_PATH%\Scripts\pip" install --no-user -U numpy torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128
PyTorchのインストールを後に行うのは、CUDA 12.8 対応版のPyTorchを確実に有効にするためである。GPUを使わない場合も、このまま実行してよい(プログラムはGPUが使えないときCPUで動作する)。
第6章 YOLOv8による物体検出プログラム(Open Images V7)
概要
本プログラムは、動画やカメラ映像からリアルタイムで物体を検出し、追跡する。入力映像に対してCLAHE(Contrast Limited Adaptive Histogram Equalization、コントラスト制限適応ヒストグラム平坦化)による前処理を適用し、YOLOv8で物体検出を実行したのち、ByteTrackで個々の物体をフレーム間で追跡する。あわせてTTA(Test-Time Augmentation、推論時データ拡張)を実装し、検出漏れを抑える。
主要技術
YOLOv8
Ultralytics社が開発したリアルタイム物体検出モデルである[1]。単一のニューラルネットワークで物体のバウンディングボックス(物体を囲む矩形)とクラスを同時に予測する。
ByteTrack
検出結果の信頼度スコアに基づき、低スコアの検出結果を背景として即座に破棄せず、追跡対象との対応付けに利用する物体追跡アルゴリズムである[2]。これにより、オクルージョン(物体の一時的な隠れ)が生じた場合も追跡を継続する。
技術的特徴
-
Open Images V7 学習済みモデルの利用
Open Images V7データセットで事前学習されたYOLOv8モデルを使用する。Ultralyticsが公開する yolov8n/s/m/l/x-oiv7.pt は601クラスを識別できる[3]。
-
CLAHEによる前処理
映像をYUV色空間に変換し、輝度チャンネルにCLAHEを適用することで、低照度環境下での物体の視認性を高める。
-
TTA(Test-Time Augmentation)の実装
推論時に元の画像と水平反転した画像の2つを入力し、それぞれの検出結果をNMS(Non-Maximum Suppression、重複した検出結果の抑制)で統合することで、検出漏れを抑える。
-
動的なリソース選択
実行環境に応じて、利用可能なGPU(CUDA)またはCPUを選択し、推論に使用する。
実装の特色
本プログラムは、リアルタイムでの物体検出・追跡処理に特化しており、次の特色を持つ。
- 実行時にモデルサイズ(n, s, m, l, x)を選択できる。
- 入力ソースとして、動画ファイル、カメラ、Web上のサンプル動画の3種類に対応する。
- 検出結果(クラス名、信頼度、追跡ID)を映像上に描画し、設定と検出結果をテキストファイルに出力する。
参考文献
- [1] Ultralytics. YOLOv8. GitHub. https://github.com/ultralytics/ultralytics
- [2] Zhang, Y., et al. (2021). ByteTrack: Multi-Object Tracking by Associating Every Detection Box. arXiv preprint arXiv:2110.06864. https://arxiv.org/abs/2110.06864
- [3] Ultralytics. Open Images V7 Dataset. https://docs.ultralytics.com/datasets/detect/open-images-v7/
ソースコード
"""
プログラム名: YOLOv8による物体検出・ByteTrackによる追跡とTTAの機能付き(Open Images V7 601クラス)
特徴技術名: YOLOv8 (Ultralytics)
出典: Ultralytics. YOLOv8. GitHub. https://github.com/ultralytics/ultralytics
特徴機能: 単一ニューラルネットワークによるリアルタイム物体検出。画像全体を一度に処理し、バウンディングボックスとクラス確率を同時に予測
学習済みモデル: yolov8n/s/m/l/x-oiv7.pt - YOLOv8モデル(ユーザー選択)、Open Images V7データセット(601クラス)で事前学習済み、推論に最適化、https://docs.ultralytics.com/datasets/detect/open-images-v7/
特徴技術および学習済モデルの利用制限: AGPL-3.0ライセンス(オープンソース)。商用利用の場合はEnterprise License要取得(Ultralytics公式サイト参照)。必ず利用者自身で利用制限を確認すること。
方式設計:
  関連利用技術:
    - OpenCV: 画像・動画処理、カメラ制御
    - CLAHE (Contrast Limited Adaptive Histogram Equalization): 低照度環境での画像品質向上
    - PyTorch: ディープラーニングフレームワーク、GPU/CPU自動選択
    - ByteTrack: カルマンフィルタとハンガリアンアルゴリズムによる物体追跡(boxmotパッケージ版)
    - TTA (Test Time Augmentation): 複数の画像変換で推論し結果を統合
  入力と出力: 入力: 動画(ユーザは「0:動画ファイル,1:カメラ,2:サンプル動画」のメニューで選択.0:動画ファイルの場合はtkinterでファイル選択.1の場合はOpenCVでカメラが開く.2の場合はhttps://raw.githubusercontent.com/opencv/opencv/master/samples/data/vtest.aviを使用)、出力: OpenCV画面でリアルタイム表示、検出結果をresult.txtに保存
  処理手順: 1.動画フレーム取得→2.CLAHE前処理→3.TTA適用→4.YOLOv8推論実行→5.バウンディングボックス抽出→6.ByteTrack追跡→7.結果描画
  前処理、後処理: 前処理:CLAHE適用による画像コントラスト強化、後処理:ByteTrack追跡による検出結果の安定化とID管理
  追加処理: TTA - 水平反転による推論結果の統合
  調整を必要とする設定値: CONF_THRESH(信頼度閾値、デフォルト0.2)- 検出感度を制御、値が低いほど多くの物体を検出、TTA_ENABLED(TTAの有効/無効、デフォルトTrue)
将来方策: 信頼度閾値の自動最適化 - 検出結果の時系列分析により、シーンごとに最適な閾値を動的に学習・適用する機能
その他の重要事項: Open Images V7 の601クラス全て検出可能
前準備:
pip install --no-user -U ultralytics opencv-python numpy pillow boxmot
"""
import cv2
import numpy as np
import torch
import torchvision
from ultralytics import YOLO
import tkinter as tk
from tkinter import filedialog
import urllib.request
import time
import sys
import io
from datetime import datetime
from PIL import Image, ImageDraw, ImageFont
from boxmot import ByteTrack
import threading

sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', line_buffering=True)

# GPU/CPU自動選択
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f'デバイス: {str(device)}')

# GPU使用時の最適化
if device.type == 'cuda':
    torch.backends.cudnn.benchmark = True

MODEL_INFO = {
    'n': {'name': 'Nano', 'params': '3.5M', 'mAP': '18.4%', 'desc': '最速'},
    's': {'name': 'Small', 'params': '11.4M', 'mAP': '27.7%', 'desc': 'デフォルト'},
    'm': {'name': 'Medium', 'params': '26.2M', 'mAP': '33.6%', 'desc': '中程度'},
    'l': {'name': 'Large', 'params': '44.1M', 'mAP': '34.9%', 'desc': '高精度'},
    'x': {'name': 'Extra Large', 'params': '68.7M', 'mAP': '36.3%', 'desc': '最高精度'}
}

CONF_THRESH = 0.2
IOU_THRESH = 0.45
NMS_THRESHOLD = 0.4
IMG_SIZE = 1280
CLAHE_CLIP_LIMIT = 3.0
CLAHE_TILE_SIZE = (8, 8)
WINDOW_NAME = "Open Images V7 601-Class Detection"
TTA_ENABLED = True
TTA_CONF_BOOST = 0.05
USE_TRACKER = True

clahe = cv2.createCLAHE(clipLimit=CLAHE_CLIP_LIMIT, tileGridSize=CLAHE_TILE_SIZE)

tracker = ByteTrack() if USE_TRACKER else None


class ThreadedVideoCapture:
    """スレッド化されたVideoCapture(常に最新フレームを取得)"""
    def __init__(self, src, is_camera=False):
        if is_camera:
            self.cap = cv2.VideoCapture(src, cv2.CAP_DSHOW)
            fourcc = cv2.VideoWriter_fourcc('M', 'J', 'P', 'G')
            self.cap.set(cv2.CAP_PROP_FOURCC, fourcc)
            self.cap.set(cv2.CAP_PROP_FPS, 60)
        else:
            self.cap = cv2.VideoCapture(src)

        self.grabbed, self.frame = self.cap.read()
        self.stopped = False
        self.lock = threading.Lock()
        self.thread = threading.Thread(target=self.update, args=())
        self.thread.daemon = True
        self.thread.start()

    def update(self):
        """バックグラウンドでフレームを取得し続ける"""
        while not self.stopped:
            grabbed, frame = self.cap.read()
            with self.lock:
                self.grabbed = grabbed
                if grabbed:
                    self.frame = frame

    def read(self):
        """最新フレームを返す"""
        with self.lock:
            return self.grabbed, self.frame.copy() if self.grabbed else None

    def isOpened(self):
        return self.cap.isOpened()

    def get(self, prop):
        return self.cap.get(prop)

    def release(self):
        self.stopped = True
        self.thread.join()
        self.cap.release()


def bgr_to_rgb(color_bgr):
    return (color_bgr[2], color_bgr[1], color_bgr[0])


def generate_class_colors(num_classes):
    colors = []
    for i in range(num_classes):
        hue = int(180.0 * i / num_classes)
        hsv = np.uint8([[[hue, 255, 255]]])
        bgr = cv2.cvtColor(hsv, cv2.COLOR_HSV2BGR)[0][0]
        colors.append((int(bgr[0]), int(bgr[1]), int(bgr[2])))
    return colors


CLASS_COLORS = generate_class_colors(601)

# 日本語フォント設定
FONT_PATH = 'C:/Windows/Fonts/meiryo.ttc'
FONT_SIZE_MAIN = 16
FONT_SIZE_SMALL = 12
font_main = ImageFont.truetype(FONT_PATH, FONT_SIZE_MAIN)
font_small = ImageFont.truetype(FONT_PATH, FONT_SIZE_SMALL)

frame_count = 0
results_log = []
class_counts = {}
model = None


def initialize_model(model_choice):
    model_name = f'yolov8{model_choice}-oiv7.pt'
    model = YOLO(model_name)
    model.to(device)
    model.eval()
    return model, model_name


def run_model_inference(model, frame, conf, iou, img_size, device_obj):
    results = model(frame, conf=conf, iou=iou, imgsz=img_size, verbose=False, device=device_obj)
    return results


def normal_inference(frame, model, conf):
    results = run_model_inference(model, frame, conf, IOU_THRESH, IMG_SIZE, device)
    curr_dets = []
    for r in results:
        if r.boxes is not None:
            for box in r.boxes:
                x1, y1, x2, y2 = box.xyxy[0].cpu().numpy()
                conf_score = float(box.conf[0].cpu().numpy())
                cls = int(box.cls[0].cpu().numpy())
                name = model.names[cls]
                curr_dets.append({
                    'x1': int(x1), 'y1': int(y1),
                    'x2': int(x2), 'y2': int(y2),
                    'conf': conf_score,
                    'class': cls,
                    'name': name
                })
    return curr_dets


def apply_tta_inference(frame, model, conf):
    frame_width = frame.shape[1]

    flipped_frame = cv2.flip(frame, 1)

    results = model([frame, flipped_frame], conf=conf, iou=IOU_THRESH,
                    imgsz=IMG_SIZE, verbose=False, device=device)

    all_boxes = []
    all_confs = []
    all_classes = []

    if results[0].boxes is not None and len(results[0].boxes) > 0:
        all_boxes.append(results[0].boxes.xyxy)
        all_confs.append(results[0].boxes.conf)
        all_classes.append(results[0].boxes.cls)

    if len(results) > 1 and results[1].boxes is not None and len(results[1].boxes) > 0:
        boxes_flipped = results[1].boxes.xyxy.clone()

        # 水平反転画像での検出結果を元の画像座標系に変換
        # x1, x2 の大小関係を保つ必要がある
        x1_flipped = boxes_flipped[:, 0].clone()
        x2_flipped = boxes_flipped[:, 2].clone()
        # 元の画像座標系での新しい座標
        boxes_flipped[:, 0] = frame_width - 1 - x2_flipped  # 新しいx1(左端)
        boxes_flipped[:, 2] = frame_width - 1 - x1_flipped  # 新しいx2(右端)

        all_boxes.append(boxes_flipped)
        all_confs.append(results[1].boxes.conf)
        all_classes.append(results[1].boxes.cls)

    if len(all_boxes) == 0:
        return []

    all_boxes = torch.cat(all_boxes, dim=0)
    all_confs = torch.cat(all_confs, dim=0)
    all_classes = torch.cat(all_classes, dim=0)

    valid_indices = all_confs > conf
    if valid_indices.sum() == 0:
        return []

    all_boxes = all_boxes[valid_indices]
    all_confs = all_confs[valid_indices]
    all_classes = all_classes[valid_indices]

    nms_indices = torchvision.ops.nms(all_boxes, all_confs, iou_threshold=NMS_THRESHOLD)
    final_boxes = all_boxes[nms_indices].cpu().numpy()
    final_confs = all_confs[nms_indices].cpu().numpy()
    final_classes = all_classes[nms_indices].cpu().numpy()

    detections = []
    for i in range(len(final_confs)):
        cls = int(final_classes[i])
        detections.append({
            'x1': int(final_boxes[i][0]), 'y1': int(final_boxes[i][1]),
            'x2': int(final_boxes[i][2]), 'y2': int(final_boxes[i][3]),
            'conf': min(1.0, float(final_confs[i]) + TTA_CONF_BOOST),
            'class': cls,
            'name': model.names[cls]
        })

    return detections


def apply_tta_if_enabled(frame, model, conf):
    if not TTA_ENABLED:
        return normal_inference(frame, model, conf)
    return apply_tta_inference(frame, model, conf)


def apply_bytetrack(detections, frame):
    global tracker

    if len(detections) > 0:
        dets_array = np.array([[d['x1'], d['y1'], d['x2'], d['y2'], d['conf'], d['class']]
                               for d in detections])
    else:
        dets_array = np.empty((0, 6))

    tracks = tracker.update(dets_array, frame)

    tracked_dets = []
    for track in tracks:
        x1, y1, x2, y2, track_id, conf, cls = track[:7]
        tracked_dets.append({
            'x1': int(x1), 'y1': int(y1),
            'x2': int(x2), 'y2': int(y2),
            'track_id': int(track_id),
            'conf': float(conf),
            'class': int(cls),
            'name': model.names[int(cls)]
        })
    return tracked_dets


def apply_tracking_if_enabled(detections, frame):
    if not USE_TRACKER:
        return detections
    return apply_bytetrack(detections, frame)


def process_detection_results(detections):
    global class_counts

    for det in detections:
        name = det['name']
        if name not in class_counts:
            class_counts[name] = 0
        class_counts[name] += 1

    return detections


def draw_detection_results(frame, detections):
    for det in detections:
        color = CLASS_COLORS[det['class'] % len(CLASS_COLORS)]
        cv2.rectangle(frame, (det['x1'], det['y1']),
                      (det['x2'], det['y2']), color, 2)

    texts_to_draw = []
    for det in detections:
        color = CLASS_COLORS[det['class'] % len(CLASS_COLORS)]
        track_id = det.get('track_id', 0) if USE_TRACKER else 0
        if USE_TRACKER and track_id > 0:
            label = f"ID:{track_id} {det['name']}: {det['conf']:.2f}"
        else:
            label = f"{det['name']}: {det['conf']:.2f}"

        texts_to_draw.append({
            'text': label,
            'org': (det['x1'], det['y1']-20),
            'color': bgr_to_rgb(color),
            'font_type': 'main'
        })
    frame = draw_texts_with_pillow(frame, texts_to_draw)

    tta_status = "TTA:ON" if TTA_ENABLED else "TTA:OFF"
    tracker_status = "ByteTrack:ON" if USE_TRACKER else "ByteTrack:OFF"
    info_text = f"Objects: {len(detections)} | Frame: {frame_count} | Classes: {len(set(d['name'] for d in detections))} | {tta_status} | {tracker_status}"
    cv2.putText(frame, info_text, (10, 30),
                cv2.FONT_HERSHEY_SIMPLEX, 0.7, (255, 255, 255), 2)

    return frame


def format_detection_output(detections):
    if len(detections) == 0:
        return 'count=0'
    else:
        parts = []
        for det in detections:
            x1, y1, x2, y2 = det['x1'], det['y1'], det['x2'], det['y2']
            class_name = det['name']
            conf = det['conf']
            if USE_TRACKER and 'track_id' in det:
                parts.append(f'class={class_name},ID={det["track_id"]},conf={conf:.3f},box=[{x1},{y1},{x2},{y2}]')
            else:
                parts.append(f'class={class_name},conf={conf:.3f},box=[{x1},{y1},{x2},{y2}]')
        return f'count={len(detections)}; ' + ' | '.join(parts)


def draw_texts_with_pillow(bgr_frame, texts):
    """
    テキスト描画
    texts: list of dict with keys {text, org, color, font_type}
    """
    img_pil = Image.fromarray(cv2.cvtColor(bgr_frame, cv2.COLOR_BGR2RGB))
    draw = ImageDraw.Draw(img_pil)

    for item in texts:
        text = item['text']
        x, y = item['org']
        color = item['color']
        font_type = item.get('font_type', 'main')
        font = font_main if font_type == 'main' else font_small
        draw.text((x, y), text, font=font, fill=color)

    return cv2.cvtColor(np.array(img_pil), cv2.COLOR_RGB2BGR)


def detect_objects(frame):
    global model

    yuv_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2YUV)
    yuv_frame[:, :, 0] = clahe.apply(yuv_frame[:, :, 0])
    enh_frame = cv2.cvtColor(yuv_frame, cv2.COLOR_YUV2BGR)

    curr_dets = apply_tta_if_enabled(enh_frame, model, CONF_THRESH)

    return curr_dets


def process_video_frame(frame, timestamp_ms, is_camera):
    detections = detect_objects(frame)

    tracked_dets = apply_tracking_if_enabled(detections, frame)

    processed_dets = process_detection_results(tracked_dets)

    frame = draw_detection_results(frame, processed_dets)

    result = format_detection_output(processed_dets)

    return frame, result


def video_frame_processing(frame, timestamp_ms, is_camera):
    """動画フレーム処理(標準形式)"""
    global frame_count
    current_time = time.time()
    frame_count += 1

    processed_frame, result = process_video_frame(frame, timestamp_ms, is_camera)
    return processed_frame, result, current_time


def display_program_header():
    print('=' * 60)
    print('=== YOLOv8による物体検出プログラム ===')
    print('=' * 60)
    print('概要: CLAHEとTTAを適用し、リアルタイムで物体を検出します')
    print('機能: YOLOv8による物体検出(Open Images V7データセット601クラス)')
    print('技術: CLAHE (コントラスト強化) + ByteTrack による追跡 + TTA (Test Time Augmentation)')
    print('操作: qキーで終了')
    print('出力: 各フレームごとに処理結果を表示し、終了時にresult.txtへ保存')
    print()


display_program_header()

print("\n=== YOLOv8モデル選択 ===")
print('使用するYOLOv8モデルを選択してください:')
for key, info in MODEL_INFO.items():
    print(f'{key}: {info["name"]} ({info["params"]} params, mAP {info["mAP"]}) - {info["desc"]}')
print()

model_choice = ''
while model_choice not in MODEL_INFO:
    model_choice = input("選択 (n/s/m/l/x) [デフォルト: s]: ").strip().lower()
    if model_choice == '':
        model_choice = 's'
        break
    if model_choice not in MODEL_INFO:
        print("無効な選択です。もう一度入力してください。")

print("\nYOLOv8モデルをロード中...")
model, model_name = initialize_model(model_choice)
print(f"\n検出可能なクラス数: {len(model.names)}")
print(f"モデル情報: {MODEL_INFO[model_choice]['name']} ({MODEL_INFO[model_choice]['params']} params, mAP {MODEL_INFO[model_choice]['mAP']})")
print("モデルのロード完了")

if TTA_ENABLED:
    print("\nTest Time Augmentation (TTA): 有効")
    print("  - 水平反転による推論結果の統合")
    print(f"  - 信頼度ブースト値: {TTA_CONF_BOOST}")
    print(f"  - NMS閾値: {NMS_THRESHOLD}")
else:
    print("\nTest Time Augmentation (TTA): 無効")

if USE_TRACKER:
    print("\nByteTrack: 有効")
    print("  - カルマンフィルタによる動き予測")

print("\n=== YOLOv8リアルタイム物体検出(Open Images V7 601クラス) ===")
print("0: 動画ファイル")
print("1: カメラ")
print("2: サンプル動画")

choice = input("選択: ")

is_camera = (choice == '1')

if choice == '0':
    root = tk.Tk()
    root.withdraw()
    path = filedialog.askopenfilename()
    if not path:
        raise SystemExit(1)
    cap = cv2.VideoCapture(path)
elif choice == '1':
    cap = ThreadedVideoCapture(0, is_camera=True)
else:
    print("サンプル動画をダウンロード中...")
    SAMPLE_URL = 'https://raw.githubusercontent.com/opencv/opencv/master/samples/data/vtest.avi'
    SAMPLE_FILE = 'vtest.avi'
    urllib.request.urlretrieve(SAMPLE_URL, SAMPLE_FILE)
    cap = cv2.VideoCapture(SAMPLE_FILE)

if not cap.isOpened():
    print('動画ファイル・カメラを開けませんでした')
    raise SystemExit(1)

# フレームレートの取得とタイムスタンプ増分の計算
if is_camera:
    actual_fps = cap.get(cv2.CAP_PROP_FPS)
    print(f'カメラのfps: {actual_fps}')
    timestamp_increment = int(1000 / actual_fps) if actual_fps > 0 else 33
else:
    video_fps = cap.get(cv2.CAP_PROP_FPS)
    timestamp_increment = int(1000 / video_fps) if video_fps > 0 else 33

print('\n=== 動画処理開始 ===')
print('操作方法:')
print('  q キー: プログラム終了')

start_time = time.time()
last_info_time = start_time
info_interval = 10.0
timestamp_ms = 0
total_processing_time = 0.0

try:
    while True:
        ret, frame = cap.read()
        if not ret:
            break

        timestamp_ms += timestamp_increment

        processing_start = time.time()
        processed_frame, result, current_time = video_frame_processing(frame, timestamp_ms, is_camera)
        processing_time = time.time() - processing_start
        total_processing_time += processing_time
        cv2.imshow(WINDOW_NAME, processed_frame)

        if result:
            if is_camera:
                timestamp = datetime.fromtimestamp(current_time).strftime("%Y-%m-%d %H:%M:%S.%f")[:-3]
                print(f'{timestamp}, {result}')
            else:
                print(f'Frame {frame_count}: {result}')

            results_log.append(result)

        # 情報提供(カメラモードのみ、info_interval秒ごと)
        if is_camera:
            elapsed = current_time - last_info_time
            if elapsed >= info_interval:
                total_elapsed = current_time - start_time
                actual_fps = frame_count / total_elapsed if total_elapsed > 0 else 0
                avg_processing_time = (total_processing_time / frame_count * 1000) if frame_count > 0 else 0
                print(f'[情報] 経過時間: {total_elapsed:.1f}秒, 処理フレーム数: {frame_count}, 実測fps: {actual_fps:.1f}, 平均処理時間: {avg_processing_time:.1f}ms')
                last_info_time = current_time

        if cv2.waitKey(1) & 0xFF == ord('q'):
            break

finally:
    print('\n=== プログラム終了 ===')
    cap.release()
    cv2.destroyAllWindows()

    if results_log:
        with open('result.txt', 'w', encoding='utf-8') as f:
            f.write('=== YOLOv8物体検出結果 ===\n')
            f.write(f'処理フレーム数: {frame_count}\n')
            f.write(f'使用モデル: {model_name}\n')
            f.write(f'モデル情報: {MODEL_INFO[model_choice]["name"]} ({MODEL_INFO[model_choice]["params"]} params, mAP {MODEL_INFO[model_choice]["mAP"]})\n')
            f.write(f'使用デバイス: {str(device).upper()}\n')
            if device.type == 'cuda':
                f.write(f'GPU: {torch.cuda.get_device_name(0)}\n')
            f.write('画像処理: CLAHE適用(YUV色空間)\n')
            f.write(f'TTA (Test Time Augmentation): {"有効" if TTA_ENABLED else "無効"}\n')
            if TTA_ENABLED:
                f.write(f'  - NMS閾値: {NMS_THRESHOLD}\n')
                f.write(f'  - 信頼度ブースト: {TTA_CONF_BOOST}\n')
            f.write(f'ByteTrack: {"有効" if USE_TRACKER else "無効"}\n')
            f.write(f'信頼度閾値: {CONF_THRESH}\n')
            f.write('\n検出されたクラス一覧:\n')
            for class_name, count in sorted(class_counts.items()):
                f.write(f'  {class_name}: {count}回\n')
            f.write('\n')
            f.write('\n'.join(results_log))
        print('\n処理結果をresult.txtに保存しました')
        print(f'検出されたクラス数: {len(class_counts)}')