統計分析のPython実現ガイド
【概要】
pandas、NumPy、SciPy、Matplotlib、statsmodelsを用いた基礎的な統計分析(探索的データ解析と古典的仮説検定)のPython実装ガイドである。記述統計量、ヒストグラム、箱ひげ図、クロス集計表、相関分析、検定(t検定、一元配置分散分析、正規性検定、等分散性検定、カイ二乗独立性検定、Mann-Whitney U検定)、分散分析後の多重比較を扱う。各手法のPythonコードと実行結果を示す。
【本資料の前提】
- 実行環境はWindows PCを前提とする。
- 掲載コードはpandas、NumPy、SciPy、Matplotlib、statsmodelsの現行版の挙動に基づく。統計量・検定の数値は、以下の計算規約により他ツール(SPSS、R)と一致しない場合がある。
- 歪度・尖度:本資料では
scipy.stats.skew(..., bias=True)とscipy.stats.kurtosis(..., fisher=True, bias=True)を用いる。これはSciPyの既定と同じく、バイアス補正なし、尖度は超過尖度(正規分布で0)である。 - 標準偏差:pandasの
std()とdescribe()は既定で不偏(ddof=1)。numpy.std()は既定でddof=0。 - t検定:
stats.ttest_ind()の既定は等分散を仮定する通常のt検定(equal_var=True)。Welch検定にはequal_var=Falseを指定する(Rのt.testは既定でWelch検定)。
- 歪度・尖度:本資料では
- 各プログラム例は手法ごとに独立している。ただし、演習5と演習6はt検定とMann-Whitney U検定の比較のため、同じ乱数データを用いる。掲載の検定結果は学習用の人工データに基づく。検定はp値のみで判断せず、可視化・効果量と併せて評価する。小標本では検出力が低く、大標本では小さな差でも有意になりやすい。
【目次】
統計手法
本資料で扱う手法を内容ごとに列挙する。
- 記述統計量
- ヒストグラム
- 箱ひげ図
- クロス集計表
- 相関分析(Pearson、Spearman)
- 検定(t検定、一元配置分散分析、正規性検定、等分散性検定、カイ二乗独立性検定、Mann-Whitney U検定)
- 分散分析後の多重比較(Tukey HSD)
記述統計量
記述統計量は、データセットの特徴を数値で要約する指標である。データ全体の特性を把握し、分析手法の選択に用いる。
基本的な統計量を以下に示す。
- 平均値:データの中心傾向を示す
- 標準偏差:データのばらつきを示す
- 中央値:データの中心傾向を示す
- 四分位数:分布の位置と広がりを示す
- 最大値:データの上限値
- 最小値:データの下限値
- 分散:データのばらつきを示す
- 歪度:分布の非対称性を示す
- 尖度:分布の裾の重さを示す
用語リスト
- 記述統計量:データの特徴を数値で要約する指標の総称。平均値、標準偏差、中央値などを含む。
- 平均値:データの総和をデータ数で除した値。外れ値の影響を受けやすい。
- 標準偏差:ばらつきの指標。各データ点と平均値との差の二乗和をデータ数(不偏推定ではデータ数−1)で割り、平方根をとった値。pandasでは既定で不偏(
ddof=1)。 - 中央値:データを昇順に並べたときの中央の値。外れ値の影響を受けにくい。
- 四分位数:データを4等分する境界値。第1四分位数、中央値(第2四分位数)、第3四分位数から成る。
- 最大値・最小値:データ内の最高値・最低値。両者でデータの範囲を示す。
- 分散:各データ点と平均値の差の二乗に基づくばらつきの指標。標準偏差の二乗。
- 歪度:分布の非対称性の指標。正規分布では理論値が0であり、正値は右に裾が長い分布を示す。
scipy.stats.skew()は既定でバイアス補正を行わない。 - 尖度:分布の裾の重さを表す指標。
scipy.stats.kurtosis()は既定で超過尖度を返し(正規分布で0)、バイアス補正を行わない。 - 検定統計量:検定で算出され、帰無仮説の下での理論分布と比較する値(t値、F値、W統計量など)。この値と分布からp値を求める。
- pandas:データ分析用ライブラリ。
describeで主要統計量を一括算出する。 - データフレーム:行と列から成る2次元データ構造。pandasの中核機能。
- 外れ値:他の値から大きく離れた値。箱ひげ図や四分位範囲を用いて検出する。
- 分布:観測値がどの値をどの程度の頻度でとるかを表すもの。
- ヒストグラム:データの範囲を区間に分割し、各区間の頻度を棒で表すグラフ。
- 箱ひげ図:中央値、四分位数、最大値、最小値を一度に表示するグラフ。外れ値の検出やグループ間比較に用いる。
- クロス集計表:2つのカテゴリ変数の組み合わせごとの度数を表で示す手法。
- 相関係数:2変数間の関係の強さを示す指標。Pearsonは線形関係、Spearmanは順位に基づく単調関係を測る。
- 帰無仮説:「差がない」「効果がない」と仮定する仮説。検定ではこれを棄却できるかを判断する。
- 有意水準:帰無仮説を棄却する基準となる確率。一般に5%(0.05)または1%(0.01)。p値がこの値を下回ると有意と判断する。
- p値:帰無仮説が真のとき、観測データと同等以上に極端な結果が得られる確率。有意水準未満で有意と判断する。
- 効果量:差や関連の大きさを表す指標(Cohenのd、Cramér's Vなど)。p値とは別に効果の実質的大きさを評価する。
- t検定:2群の平均値の差を評価する検定。帰無仮説は「2群の母平均が等しい」。
- Welchのt検定:等分散を仮定しないt検定。
ttest_ind(equal_var=False)で実行する。 - 等分散性検定(Levene検定):複数群の分散が等しいかを検定する。帰無仮説は「各群の分散が等しい」。
scipy.stats.levene()。center='median'を指定した場合はBrown-Forsythe検定に相当する。 - ノンパラメトリック検定:母集団分布の形状を強く仮定しない検定。順位や符号を用いる。
- Mann-Whitney U検定:独立2群について、一方の群の値が他方より大きくなる確率が0.5と異なるかを検定するノンパラメトリック検定。Wilcoxon順位和検定と等価に扱われる。正規性を仮定できない場合のt検定の代替として用いられることがある。
scipy.stats.mannwhitneyu()。 - 一元配置分散分析:3群以上の平均値差を同時に検定する手法。
scipy.stats.f_oneway()。 - 多重比較(事後検定):分散分析で有意となった後、どの群間に差があるかを調べる手法。Tukey HSDなど。
statsmodelsで実装する。 - カイ二乗独立性検定:クロス集計表の2変数が独立かを検定する。
scipy.stats.chi2_contingency()。 - Shapiro-Wilk検定:正規性の検定。帰無仮説は「母集団が正規分布に従う」。最低3観測を要し、N>5000ではp値の精度が下がる。
scipy.stats.shapiro()。
統計処理の比較
同じ統計処理を異なるツールで実行する際のコマンドを比較する。各ツールで既定の挙動が異なる場合がある(特にt検定)。
| 処理内容 | SPSS | R | Python (pandas/scipy/statsmodels) |
|---|---|---|---|
| 記述統計量 | DESCRIPTIVES、FREQUENCIES | summary、sd、skewness、kurtosis | df.describe()、stats.skew()、stats.kurtosis() |
| 頻度表 | FREQUENCIES | table | value_counts() |
| クロス集計表 | CROSSTABS | table | pd.crosstab() |
| 集約 | AGGREGATE | aggregate | groupby().agg() |
| 相関 | CORRELATIONS | cor、cor.test | df.corr()、stats.pearsonr()、stats.spearmanr() |
| 通常のt検定 | T-TEST | t.test(..., var.equal=TRUE) | stats.ttest_ind()(既定) |
| Welchのt検定 | T-TEST | t.test(既定) | stats.ttest_ind(equal_var=False) |
| 等分散性検定 | EXAMINE | leveneTest | stats.levene() |
| 一元配置分散分析 | ONEWAY | aov、oneway.test | stats.f_oneway() |
| 多重比較(Tukey) | POSTHOC | TukeyHSD | pairwise_tukeyhsd() |
| カイ二乗独立性検定 | CROSSTABS /STATISTICS | chisq.test | stats.chi2_contingency() |
| Mann-Whitney U検定 | NPAR TESTS | wilcox.test | stats.mannwhitneyu() |
Pythonのttest_ind()は既定が通常のt検定(equal_var=True)であり、Welch検定にはequal_var=Falseを指定する。Rのt.testは既定でWelch検定を行う。
統計分析の解説とコード例
記述統計・可視化では以下の成績データを用いる。クロス集計以降の検定では、手法の説明のため例ごとに別データを用いる。ただし、演習5と演習6は同じ乱数データを用いて、t検定とMann-Whitney U検定を比較する。
| 科目 | 受講者 | 得点 |
|---|---|---|
| 国語 | A | 90 |
| 国語 | B | 80 |
| 国語 | C | 85 |
| 国語 | D | 88 |
| 国語 | E | 76 |
| 算数 | A | 95 |
| 算数 | B | 90 |
| 算数 | C | 92 |
| 算数 | D | 87 |
| 算数 | E | 85 |
| 理科 | A | 80 |
| 理科 | B | 78 |
| 理科 | C | 85 |
| 理科 | D | 82 |
| 理科 | E | 88 |
データフレームの作成
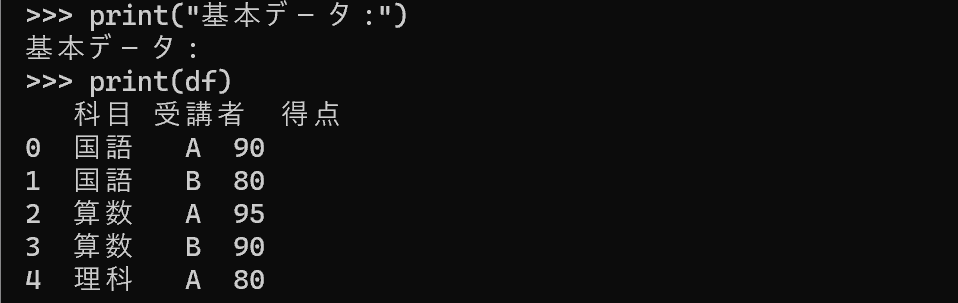
pandasのデータフレームは表形式データの基本構造である。ここでは成績データを辞書から作成し、データフレームへ変換する。
- データ作成:辞書
dataに科目、受講者、得点を格納する。 - データフレームの作成:
pd.DataFrame(data)で変換する。 - データ型の指定:
pd.Categorical(..., ordered=True)で「科目」「受講者」の表示順を固定し、「得点」は整数型(int32)にする。
個別の統計量計算
各統計量を個別に算出する。特定の統計量のみ必要な場合や、計算過程を確認したい場合に用いる。
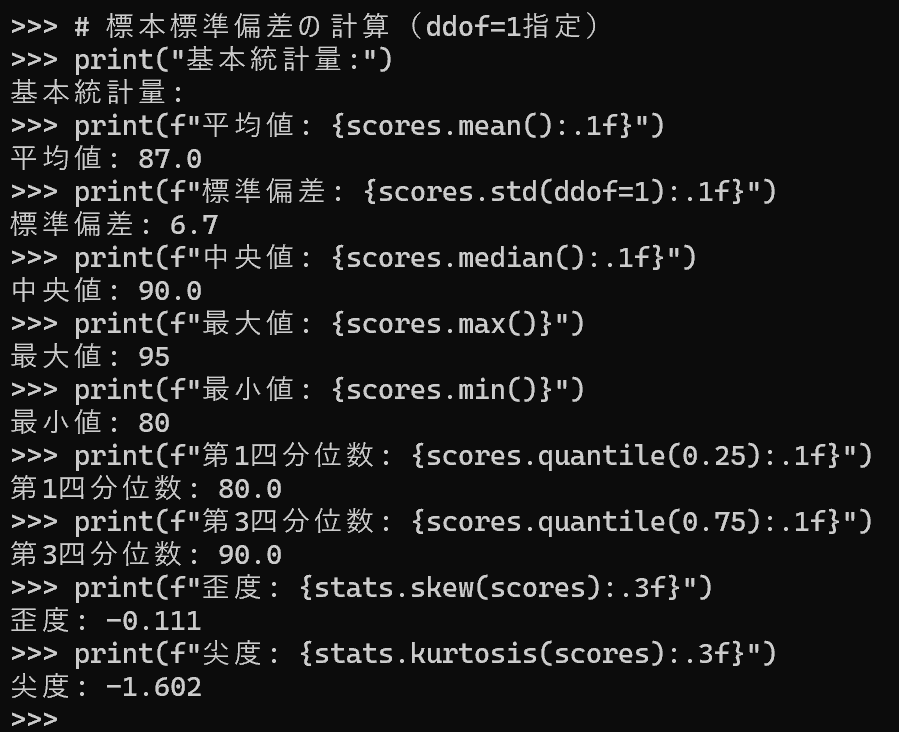
- 「得点」に対し、平均、標準偏差、中央値、最大値、最小値、四分位数、分散を算出し、SciPyで歪度と尖度を算出する。
ddof=1は分母を「データ数 − 1」とする標本標準偏差(不偏推定)を指定する。pandasのstd()は既定でddof=1だが、numpy.std()は既定でddof=0である。stats.skew(..., bias=True)とstats.kurtosis(..., fisher=True, bias=True)は、バイアス補正なし、尖度は超過尖度で計算する。
総合的な統計分析
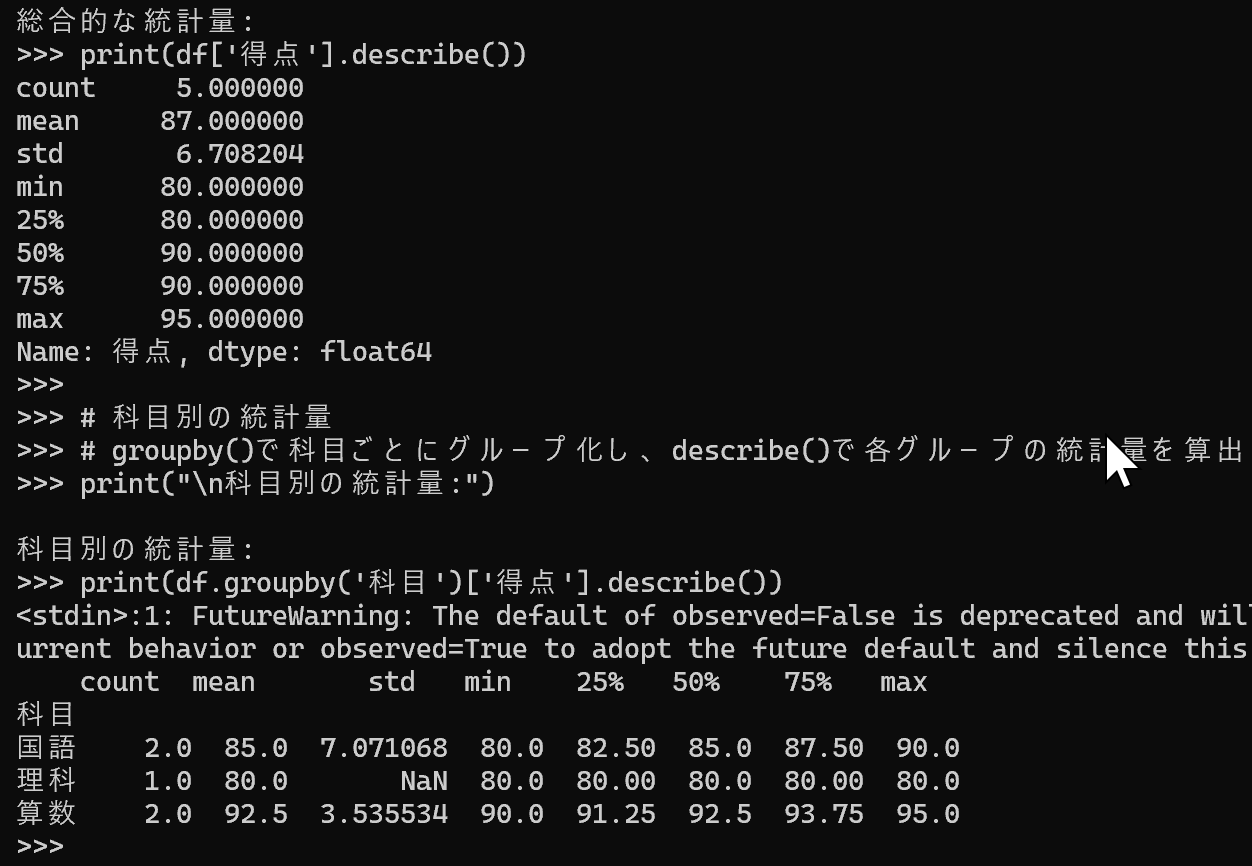
describe()は主要な記述統計量を一括算出する。stdは不偏(ddof=1)で出力される。
- 総合分析:
describe()で全体の基本統計量を一括算出する。 - カテゴリ別分析:
groupby()とdescribe()を組み合わせ、科目ごとの統計量を算出する。カテゴリ型の列でグループ化する際、出現しているカテゴリに基づいて集計することを明確にするため、本資料ではobserved=Trueを明示する。
データの可視化(箱ひげ図とヒストグラム)
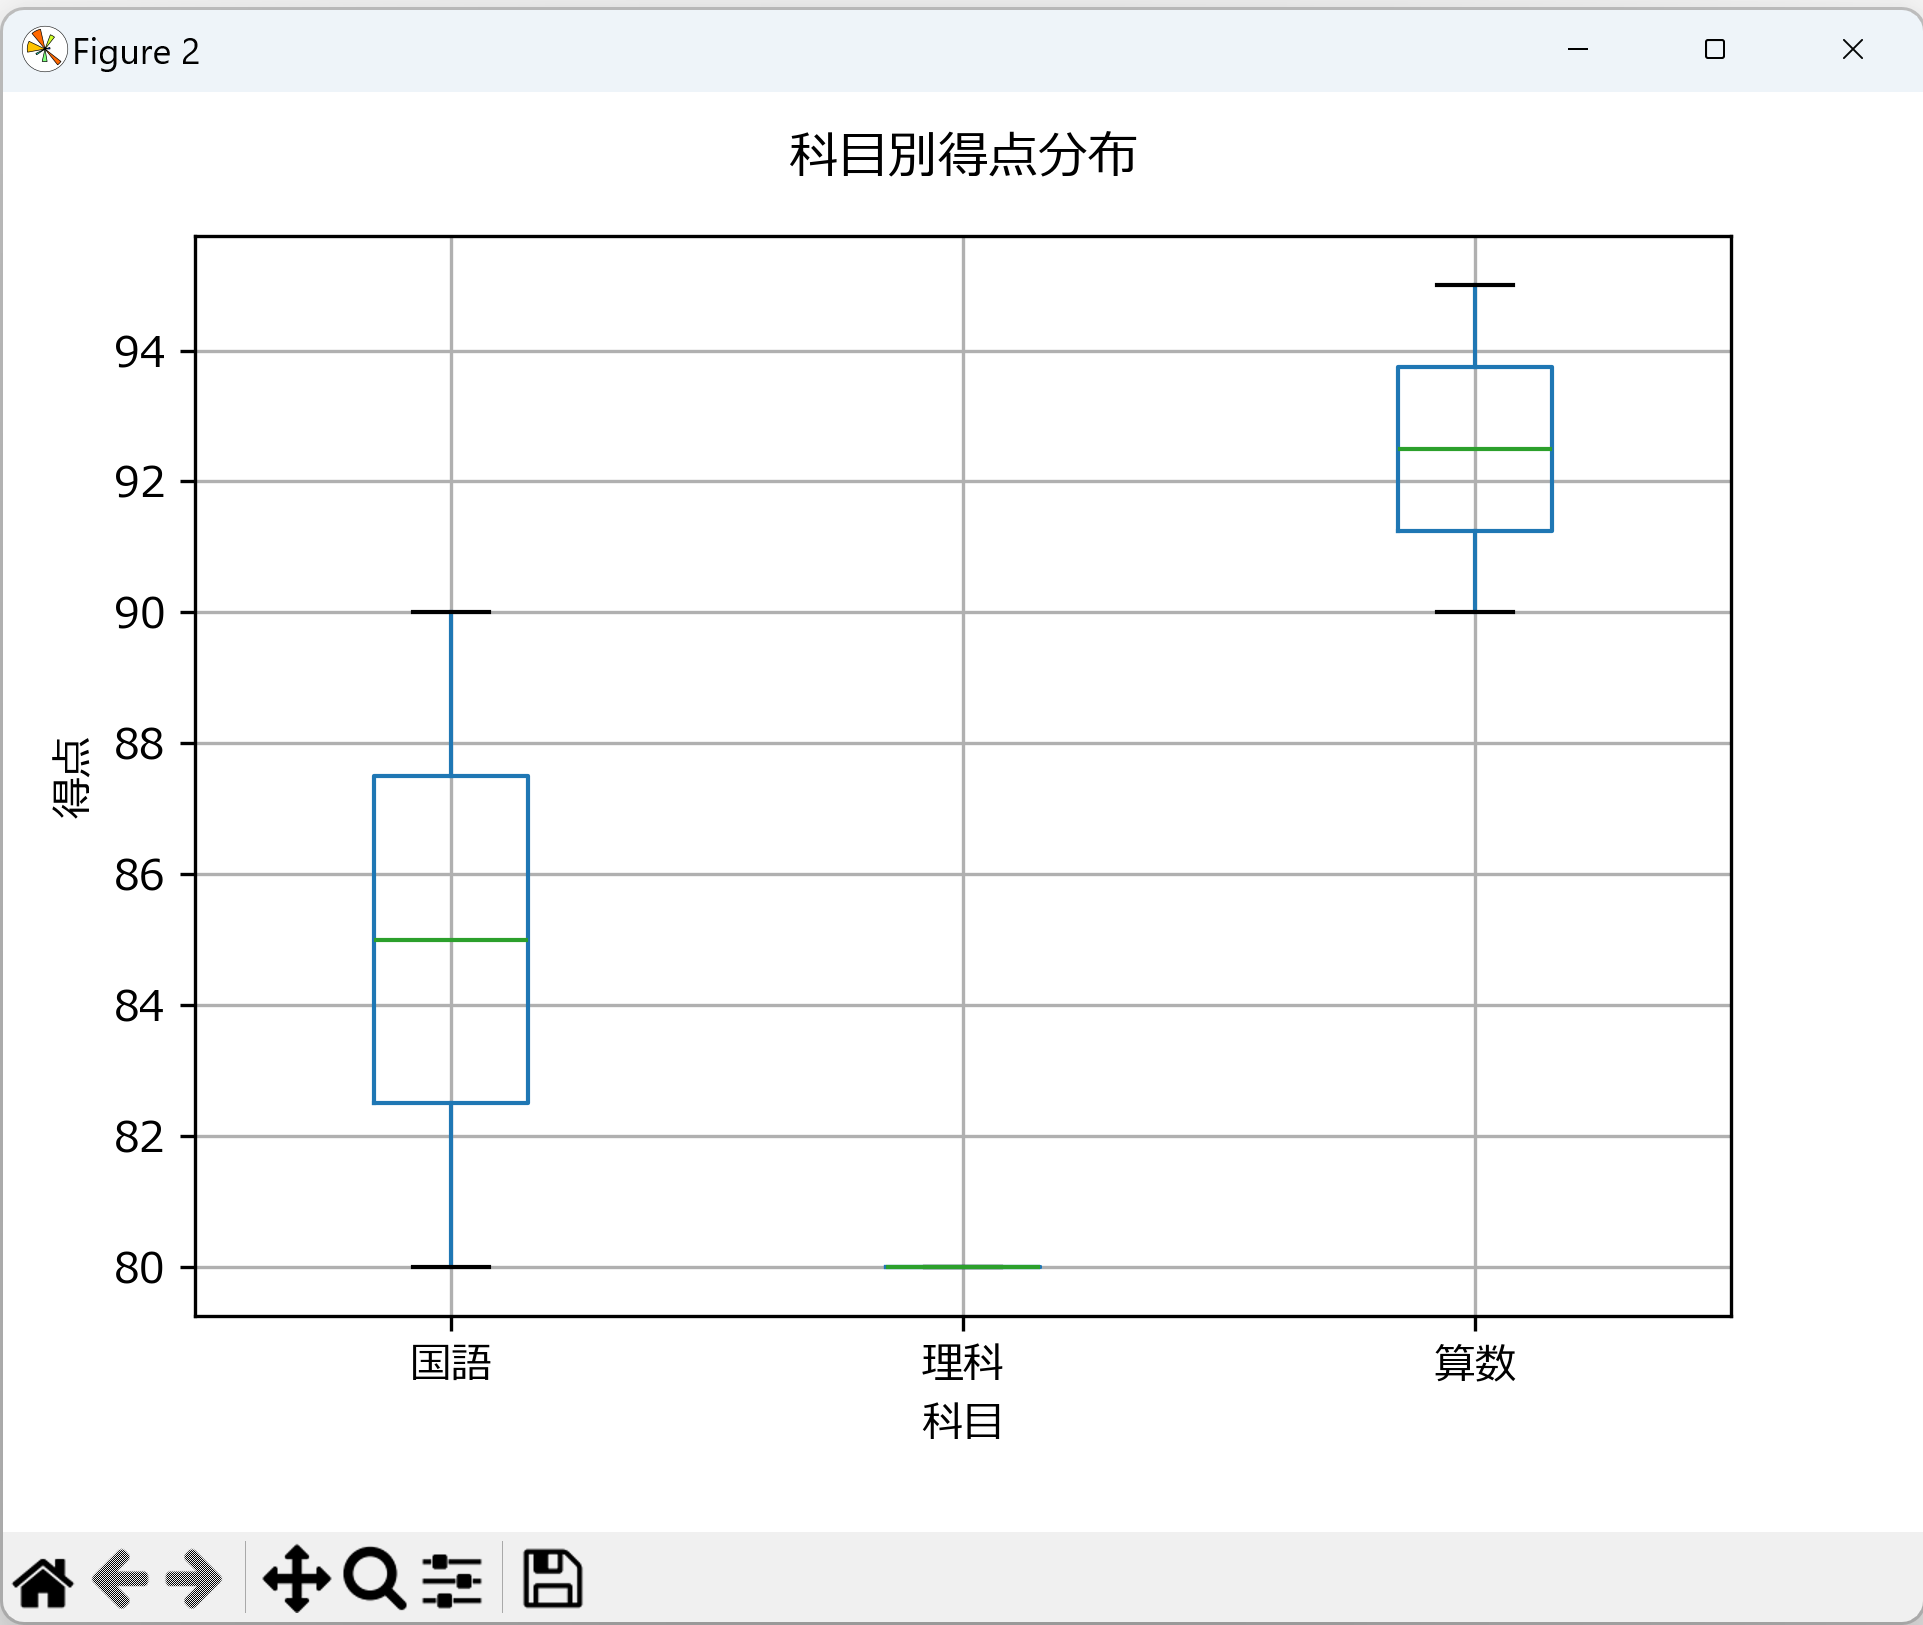
- 箱ひげ図:pandasの
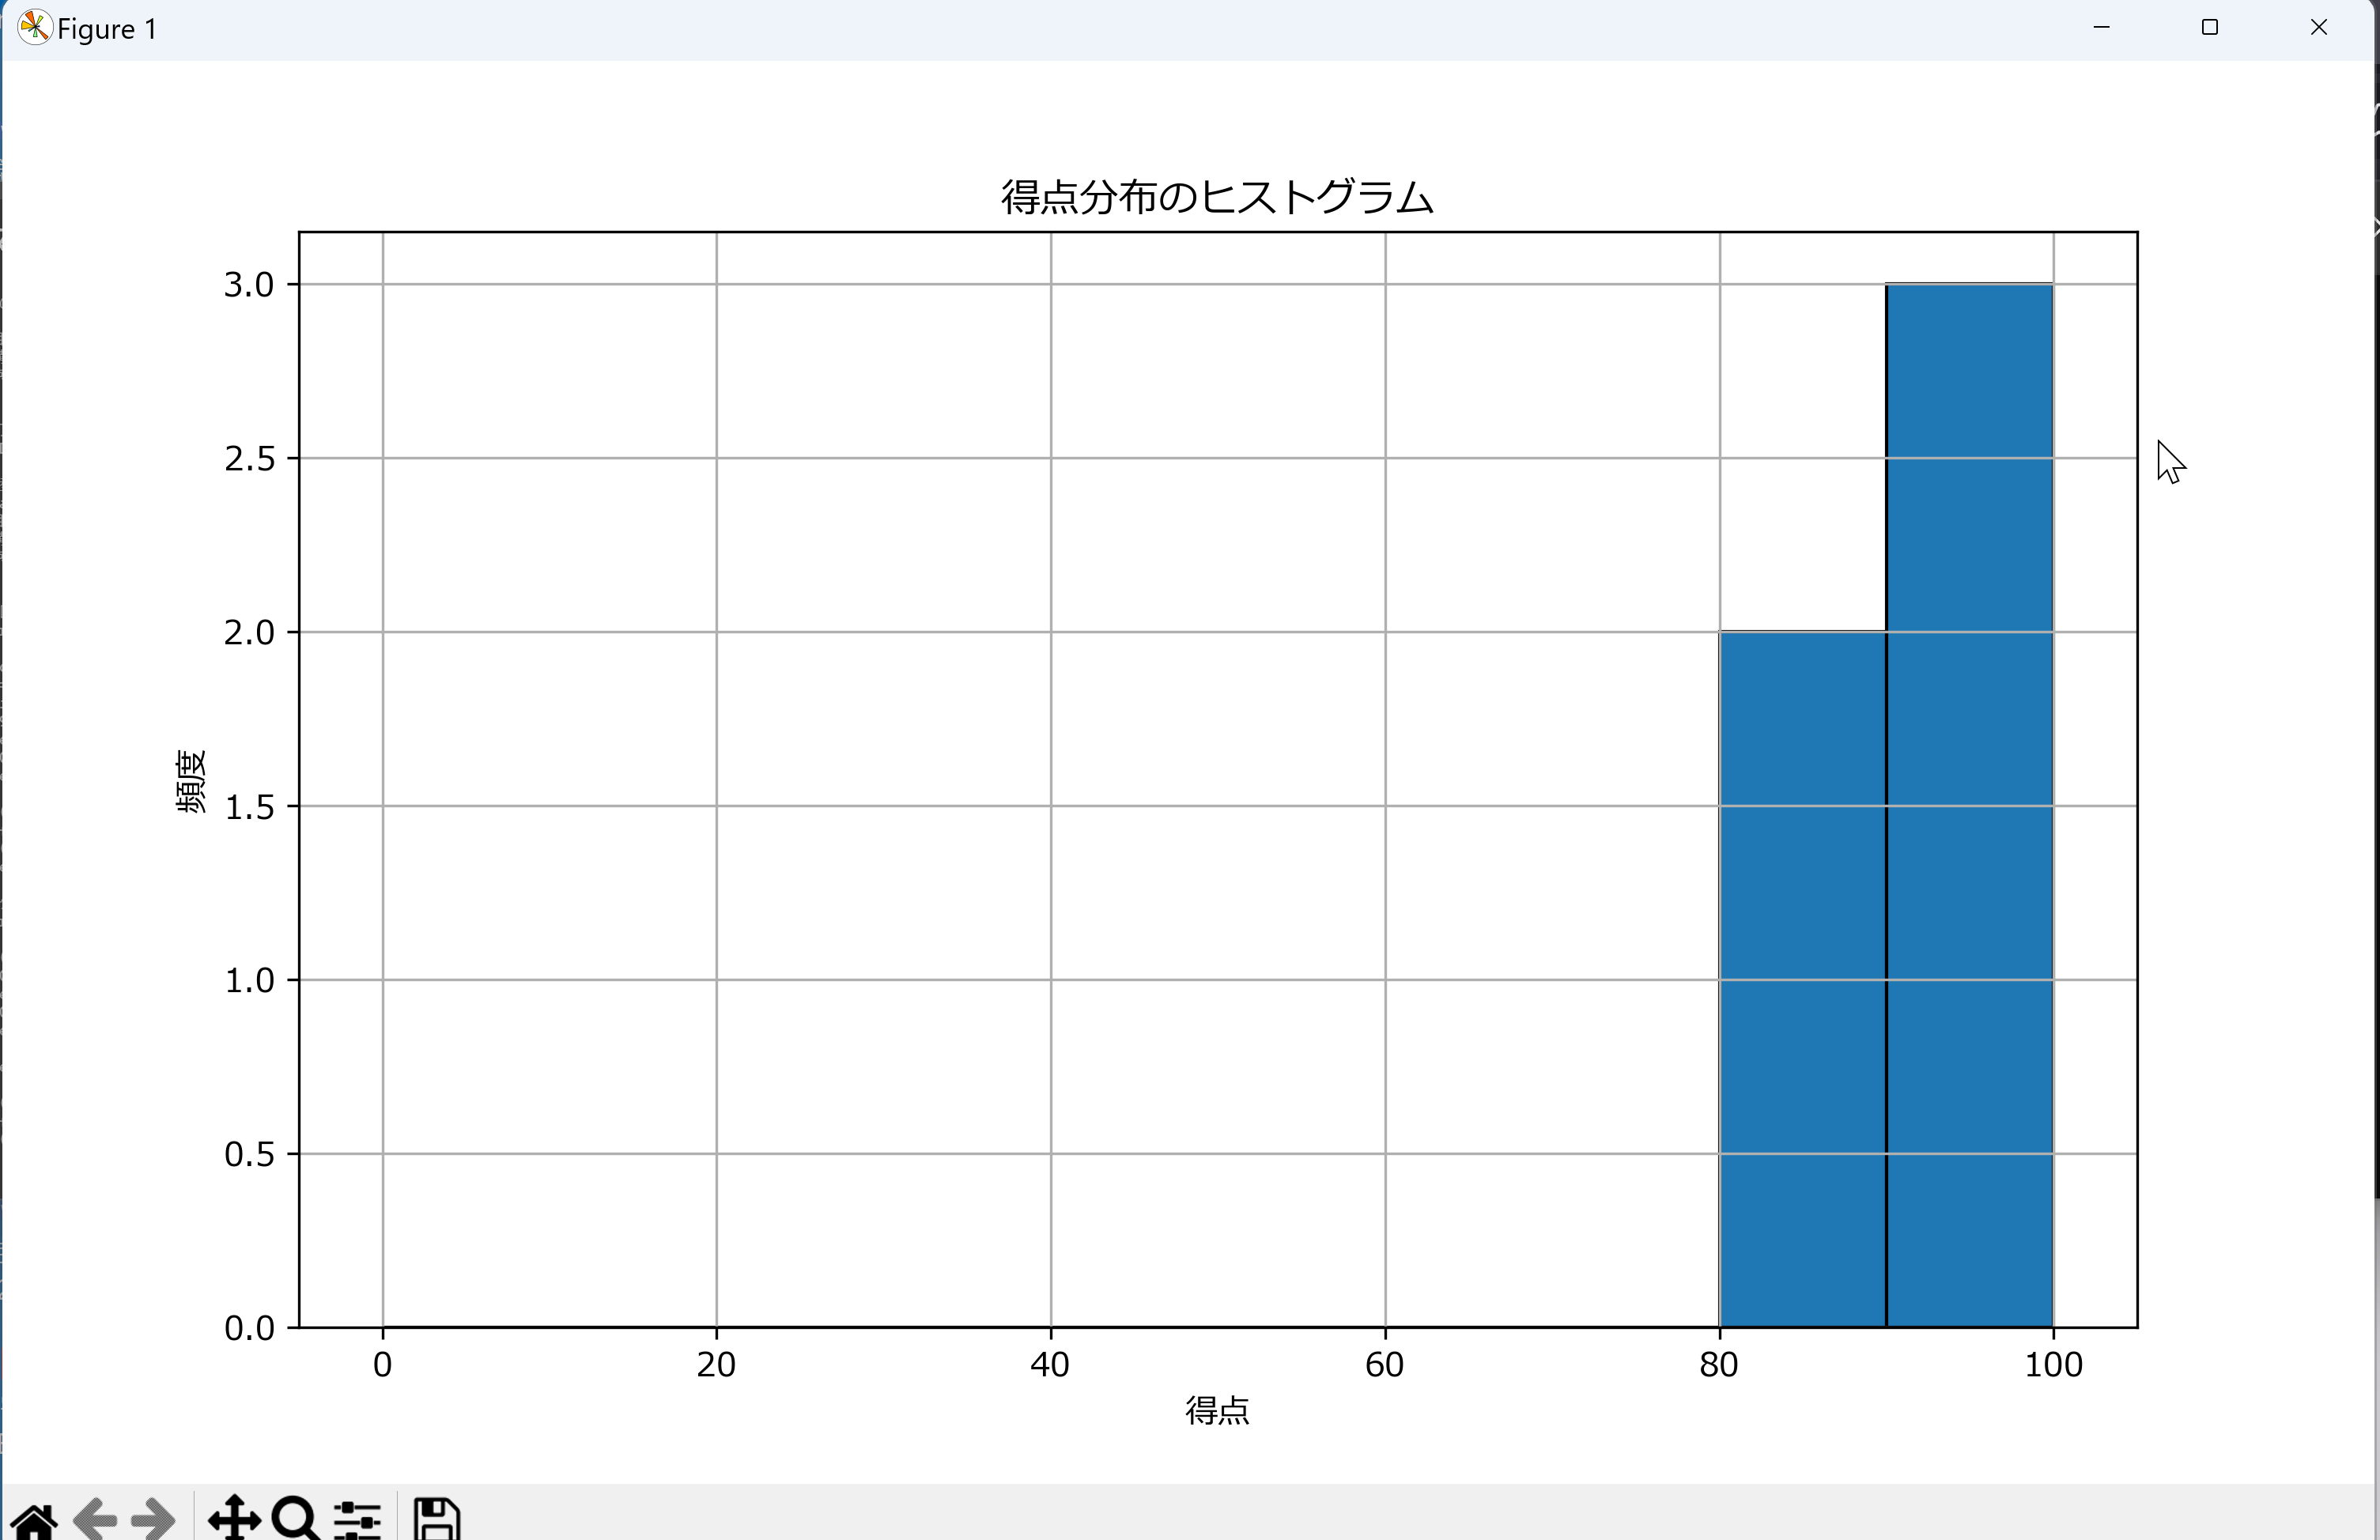
boxplotで科目別の得点分布を可視化する。中央値、四分位数、外れ値を確認できる。 - ヒストグラム:
plt.histで得点分布を表示する。binsで区間(ビン)の境界を指定する。 - 日本語表示:
rcParamsのフォント設定を描画前に行う。Windows環境では、Meiryo、Yu Gothic、MS Gothicを候補として指定する。
クロス集計表とカイ二乗独立性検定
クロス集計表は2つのカテゴリ変数の組み合わせごとの頻度を表で示す。カイ二乗検定で2変数が独立かを検定し、Cramér's Vで関連の強さ(効果量)を評価する。
- クロス集計:
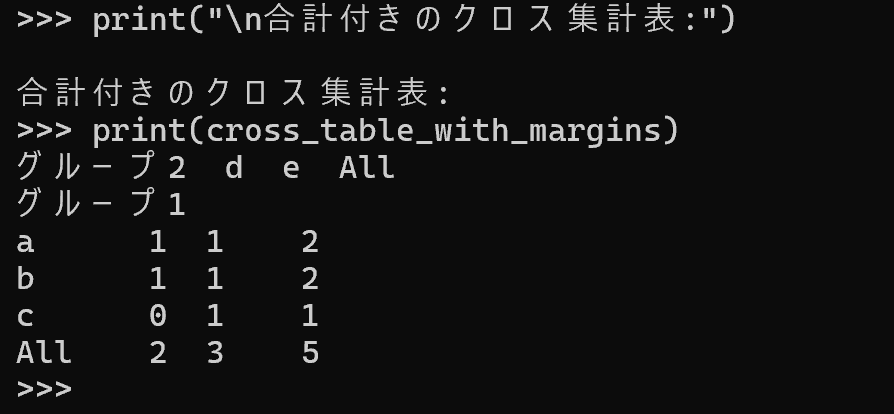
pd.crosstabの第1引数が行、第2引数が列となる。 - 合計:
margins=Trueで行・列の合計(名称はAll)が追加される。 - 独立性検定:
stats.chi2_contingencyに集計表(合計を含まないもの)を渡す。戻り値はカイ二乗統計量、p値、自由度、期待度数の順である。 - 補正:本資料ではPearsonのカイ二乗統計量を用いるため
correction=Falseを明示する。連続性補正は自由度1(2×2表)でのみ適用されるため、自由度2のこの例では結果に影響しない。 - 期待度数:この例では各セルの期待度数が5以上になるデータを用いる。
相関分析
連続変数間の関係の強さを相関係数で評価する。Pearsonは線形関係、Spearmanは順位に基づく単調関係を測る。
- 相関行列:
df.corr()で算出する(既定はPearson)。 - 個別の相関係数とp値:
stats.pearsonrとstats.spearmanrで算出する。いずれも戻り値は相関係数とp値の順である。

等分散性の検定(Levene検定)とt検定
2群の比較では、分散の状態を確認するためにLevene検定を用いることがある。ここでは分散差に比較的頑健なWelchのt検定を実装する。
- 再現性:
np.random.seed(42)で乱数のシード(乱数生成の初期値)を固定すると、実行のたびに同じ乱数列が得られる。 - 等分散性検定:
stats.levene(..., center='median')を用いる。帰無仮説は「各群の分散が等しい」。 - t検定:
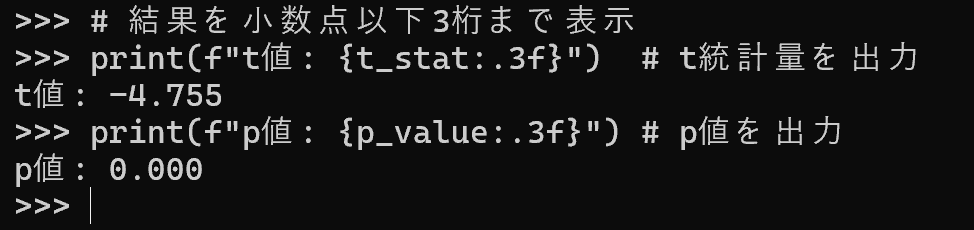
ttest_ind(equal_var=False, alternative='two-sided')で両側のWelch検定を行う。戻り値のTtestResultはstatistic、pvalue、df(自由度)を持つ。 - 解釈:p値が有意水準(一般に0.05)未満であれば、2群の平均値に有意な差があると判断する。
Mann-Whitney U検定(ノンパラメトリック)
正規性が仮定できない場合、t検定の代わりに独立2群のMann-Whitney U検定を用いることがある(Wilcoxon順位和検定と等価に扱われる)。
- 実行:
stats.mannwhitneyuに2群のデータを渡す。alternative='two-sided'は両側検定を指定する。 - 計算法:この例では標本数が各群100であるため、
method='asymptotic'を明示して漸近法でp値を求める。 - 片側検定:
alternative='greater'は、第1引数の群が第2引数の群より大きい方向の片側検定を意味する。第1引数の群が小さい方向を見る場合はalternative='less'を指定する。 - 解釈:p値が有意水準未満であれば、2群の順位分布に有意な差があると判断する。

一元配置分散分析と多重比較(Tukey HSD)
3群以上の平均値の差は一元配置分散分析で検定する。3群以上でt検定を繰り返すと第1種の過誤の確率が増大するため、この手法を用いる。有意だった場合、どの群間に差があるかをTukey HSD(多重比較)で調べる。
- 分散分析:
stats.f_oneway()を用いる。 - 事後検定:
pairwise_tukeyhsdに値(endog)と群ラベル(groups)を渡す。Tukey HSDは群内分散が等しいことを仮定する。 - 解釈:分散分析のp値が有意水準未満であれば、少なくとも1組の群間に有意な差がある。
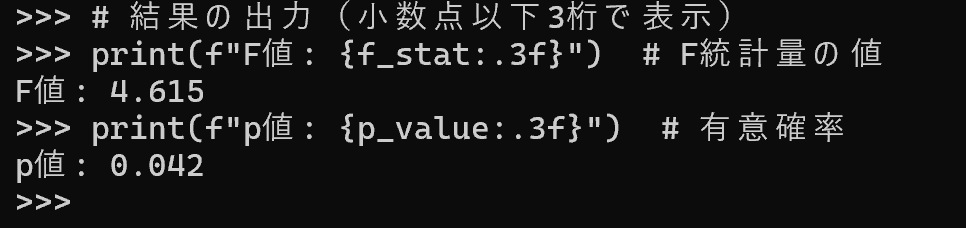
各群が3〜5個と小標本のため、結果は説明目的の参考値である。
正規性の検定(Shapiro-Wilk検定)
t検定や分散分析などのパラメトリック検定は正規性を仮定するため、事前にShapiro-Wilk検定で確認する。
- 実行:
stats.shapiro()を用いる。帰無仮説は「データは正規分布に従う」。最低3観測を要し、N>5000ではp値の精度が下がる。 - 再現性:
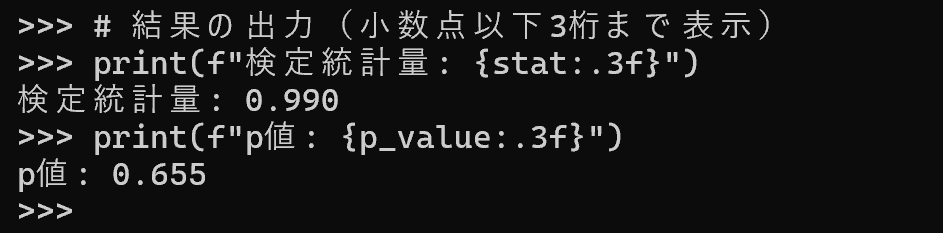
np.random.seed(42)で乱数のシードを固定する。 - 解釈:p値が有意水準(一般に0.05)以上であれば、帰無仮説を棄却できず、正規性を否定する根拠がない(正規分布に従うことの証明ではない)。有意水準未満であれば、ノンパラメトリック検定の使用を検討する。小標本では検出力が低く、大標本では小さな差でも有意になりやすいため、ヒストグラムと併せて判断する。
前準備
Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する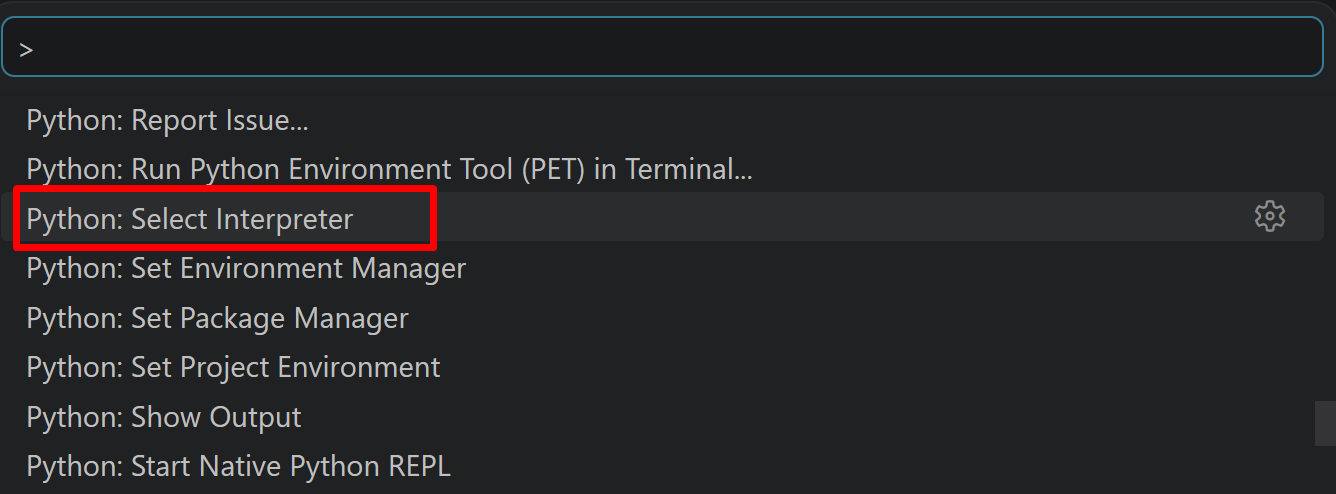
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.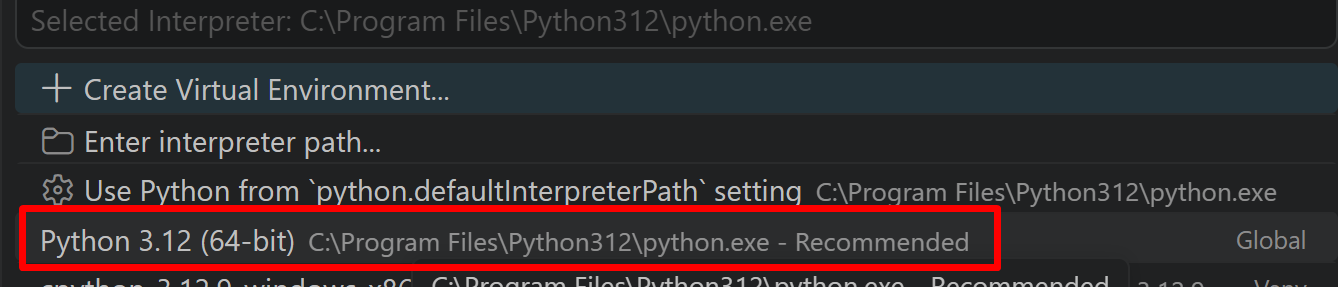
Python プログラム実行手順
[Windows での Python プログラム実行手順を見るには、ここをクリック]
Windows での Python 実行手順(Visual Studio Codeを使用)
プログラムファイルの作成と保存
- 左サイドバーの「エクスプローラー」アイコン(
Ctrl+Shift+E)をクリックする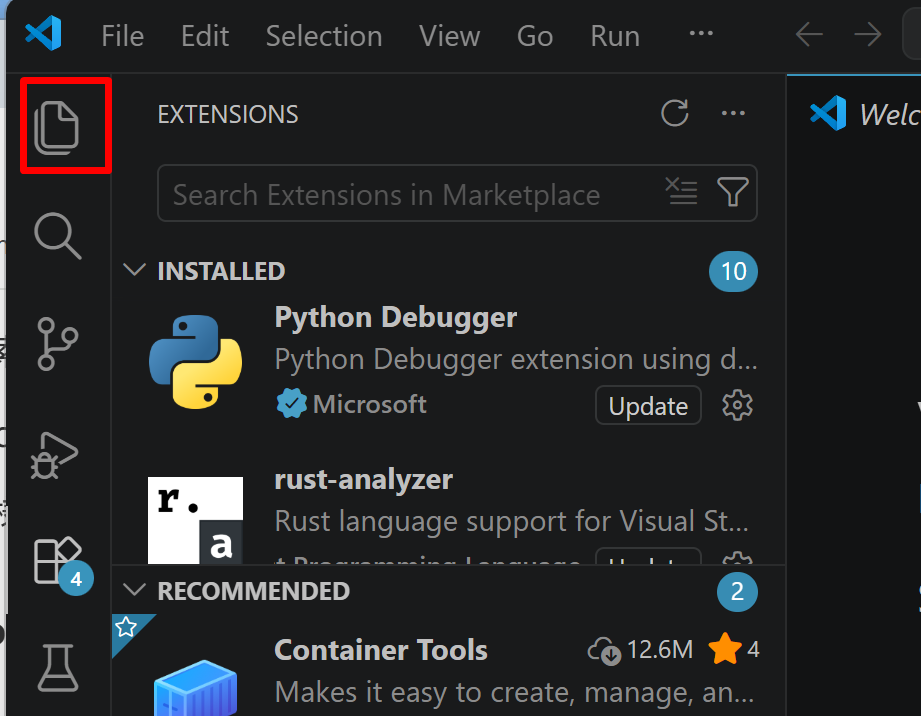
- 「NO FOLDER OPENED」(作業対象フォルダが未選択の状態)と表示される場合は,「Open Folder」をクリックし,プログラムを保存するフォルダを選択する
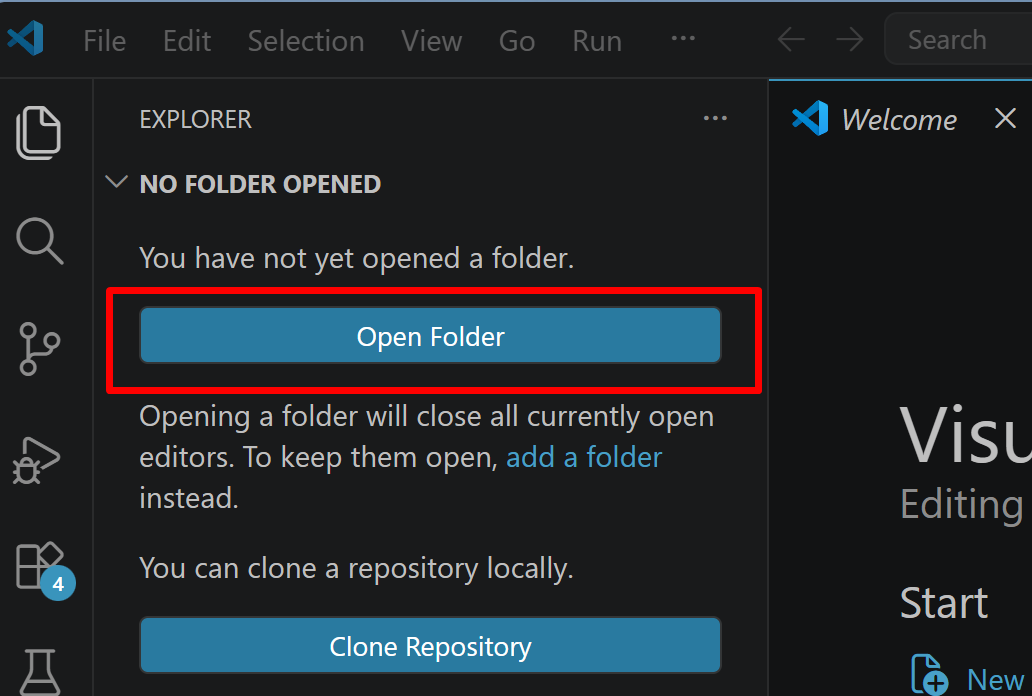
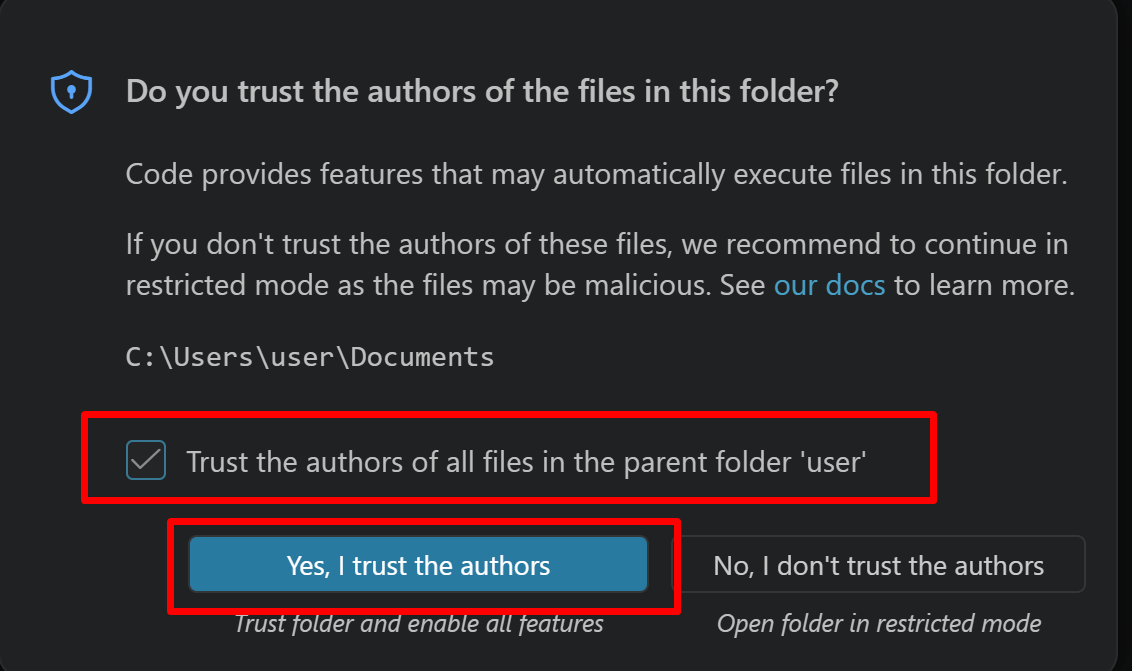
続いて「フォルダを信用するか」を確認する画面(フォルダ内のコードを実行してよいか確認する VS Code の仕組み)が表示されるので,チェックして Yes を選択する
- フォルダ名の右側に表示される「新しいファイル」アイコンをクリックする
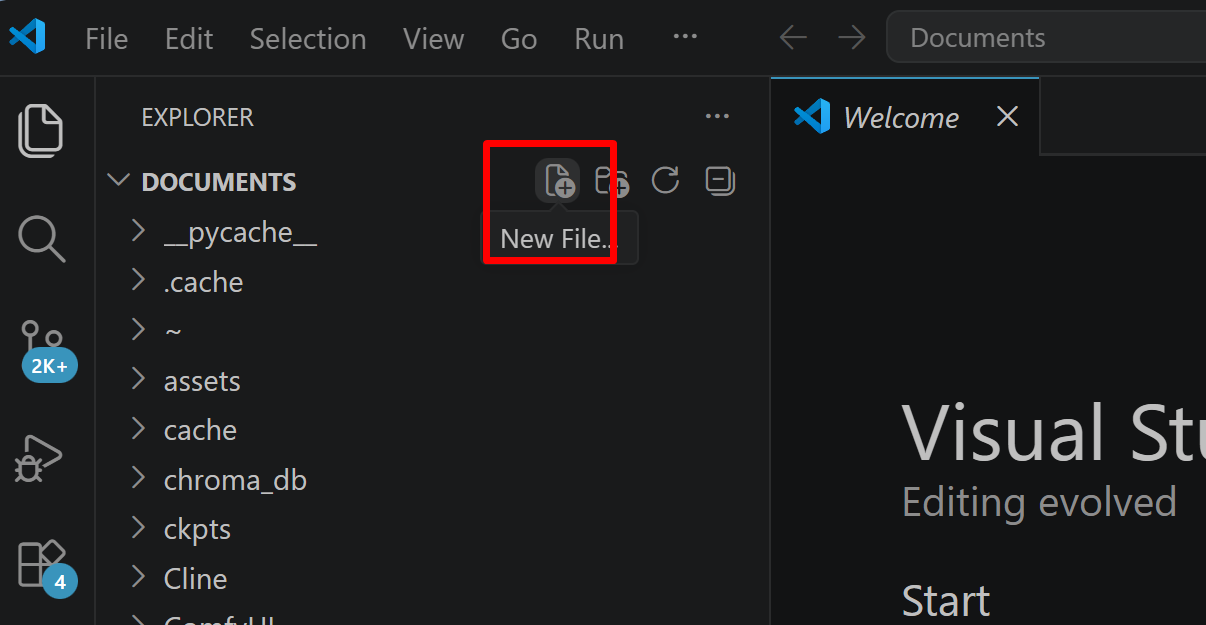
- ファイル名(例:
aitask.py.ファイル名は何でも良い)を入力しEnterを押す.拡張子は.py(Python ファイルを示す拡張子)とする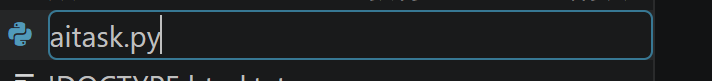
- 実行したいコードを選択し,
Ctrl+Cでコピーする.VS Code のエディタ領域にCtrl+Vで貼り付ける Ctrl+Sで保存する
プログラムの実行
- エディタ右上の三角形「▷」アイコン(Run Python File:現在開いている Python ファイルを実行するボタン)をクリックする.または,エディタ上で右クリックし「ターミナルで Python ファイルを実行」を選択する
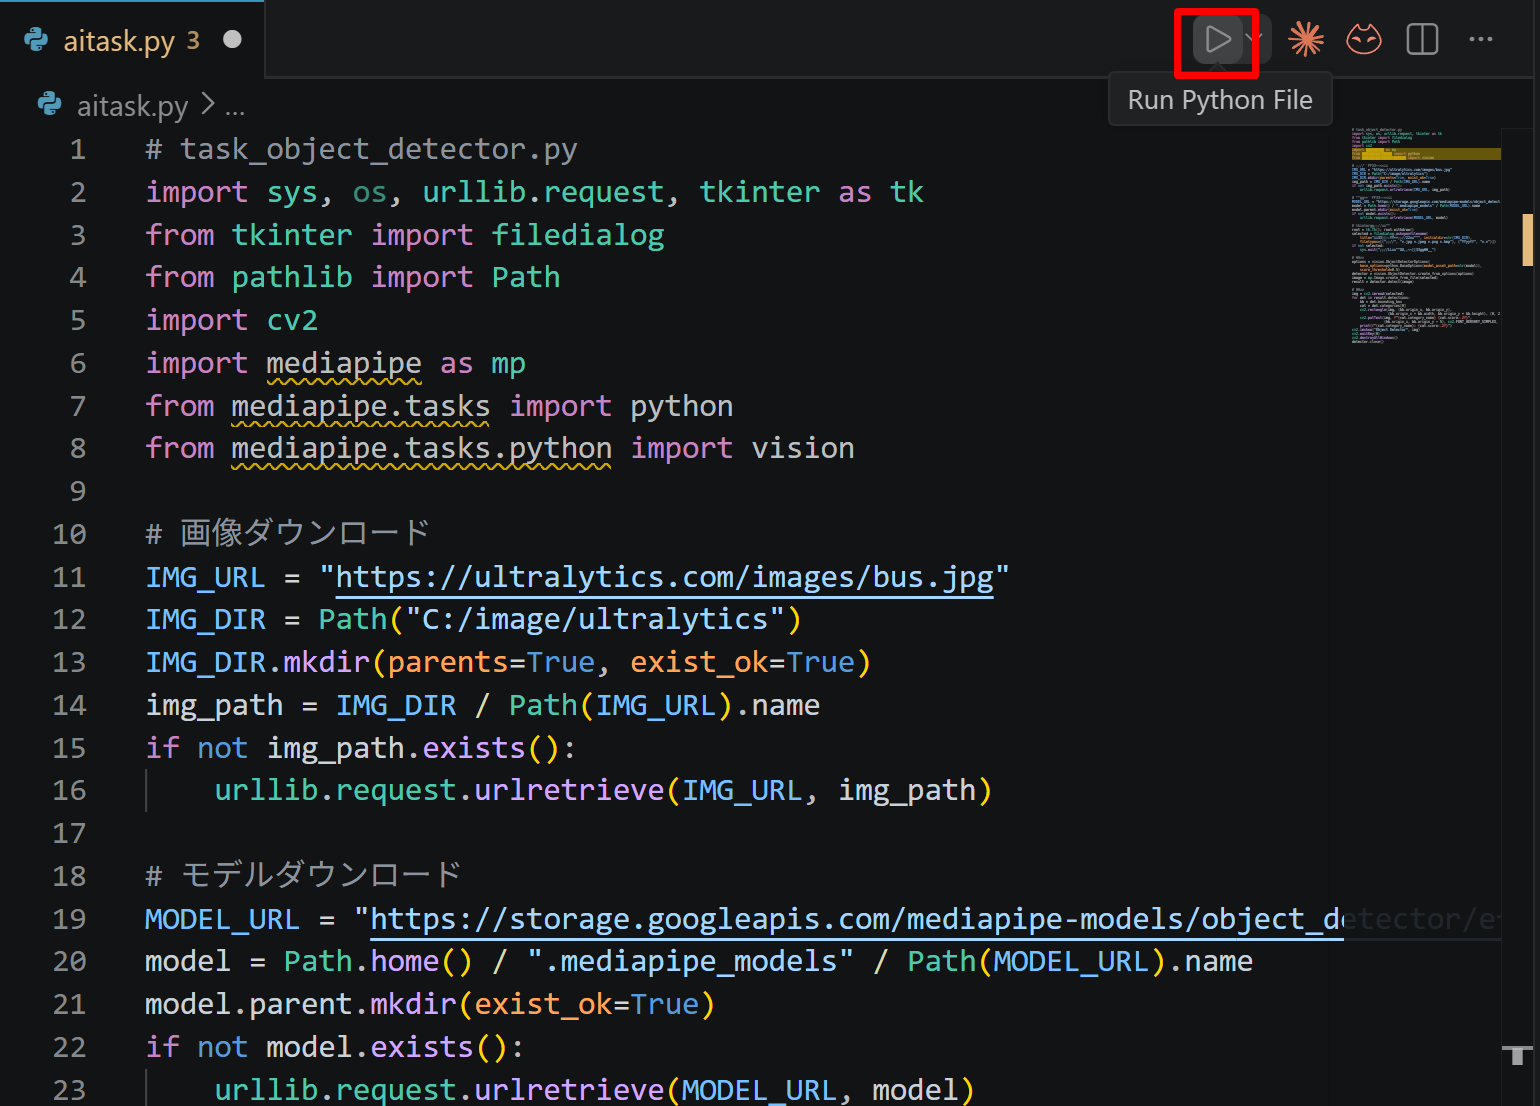
- VS Code 下部のターミナル(コマンドの入出力を表示する画面)に,実行結果(
print関数の出力等)が表示される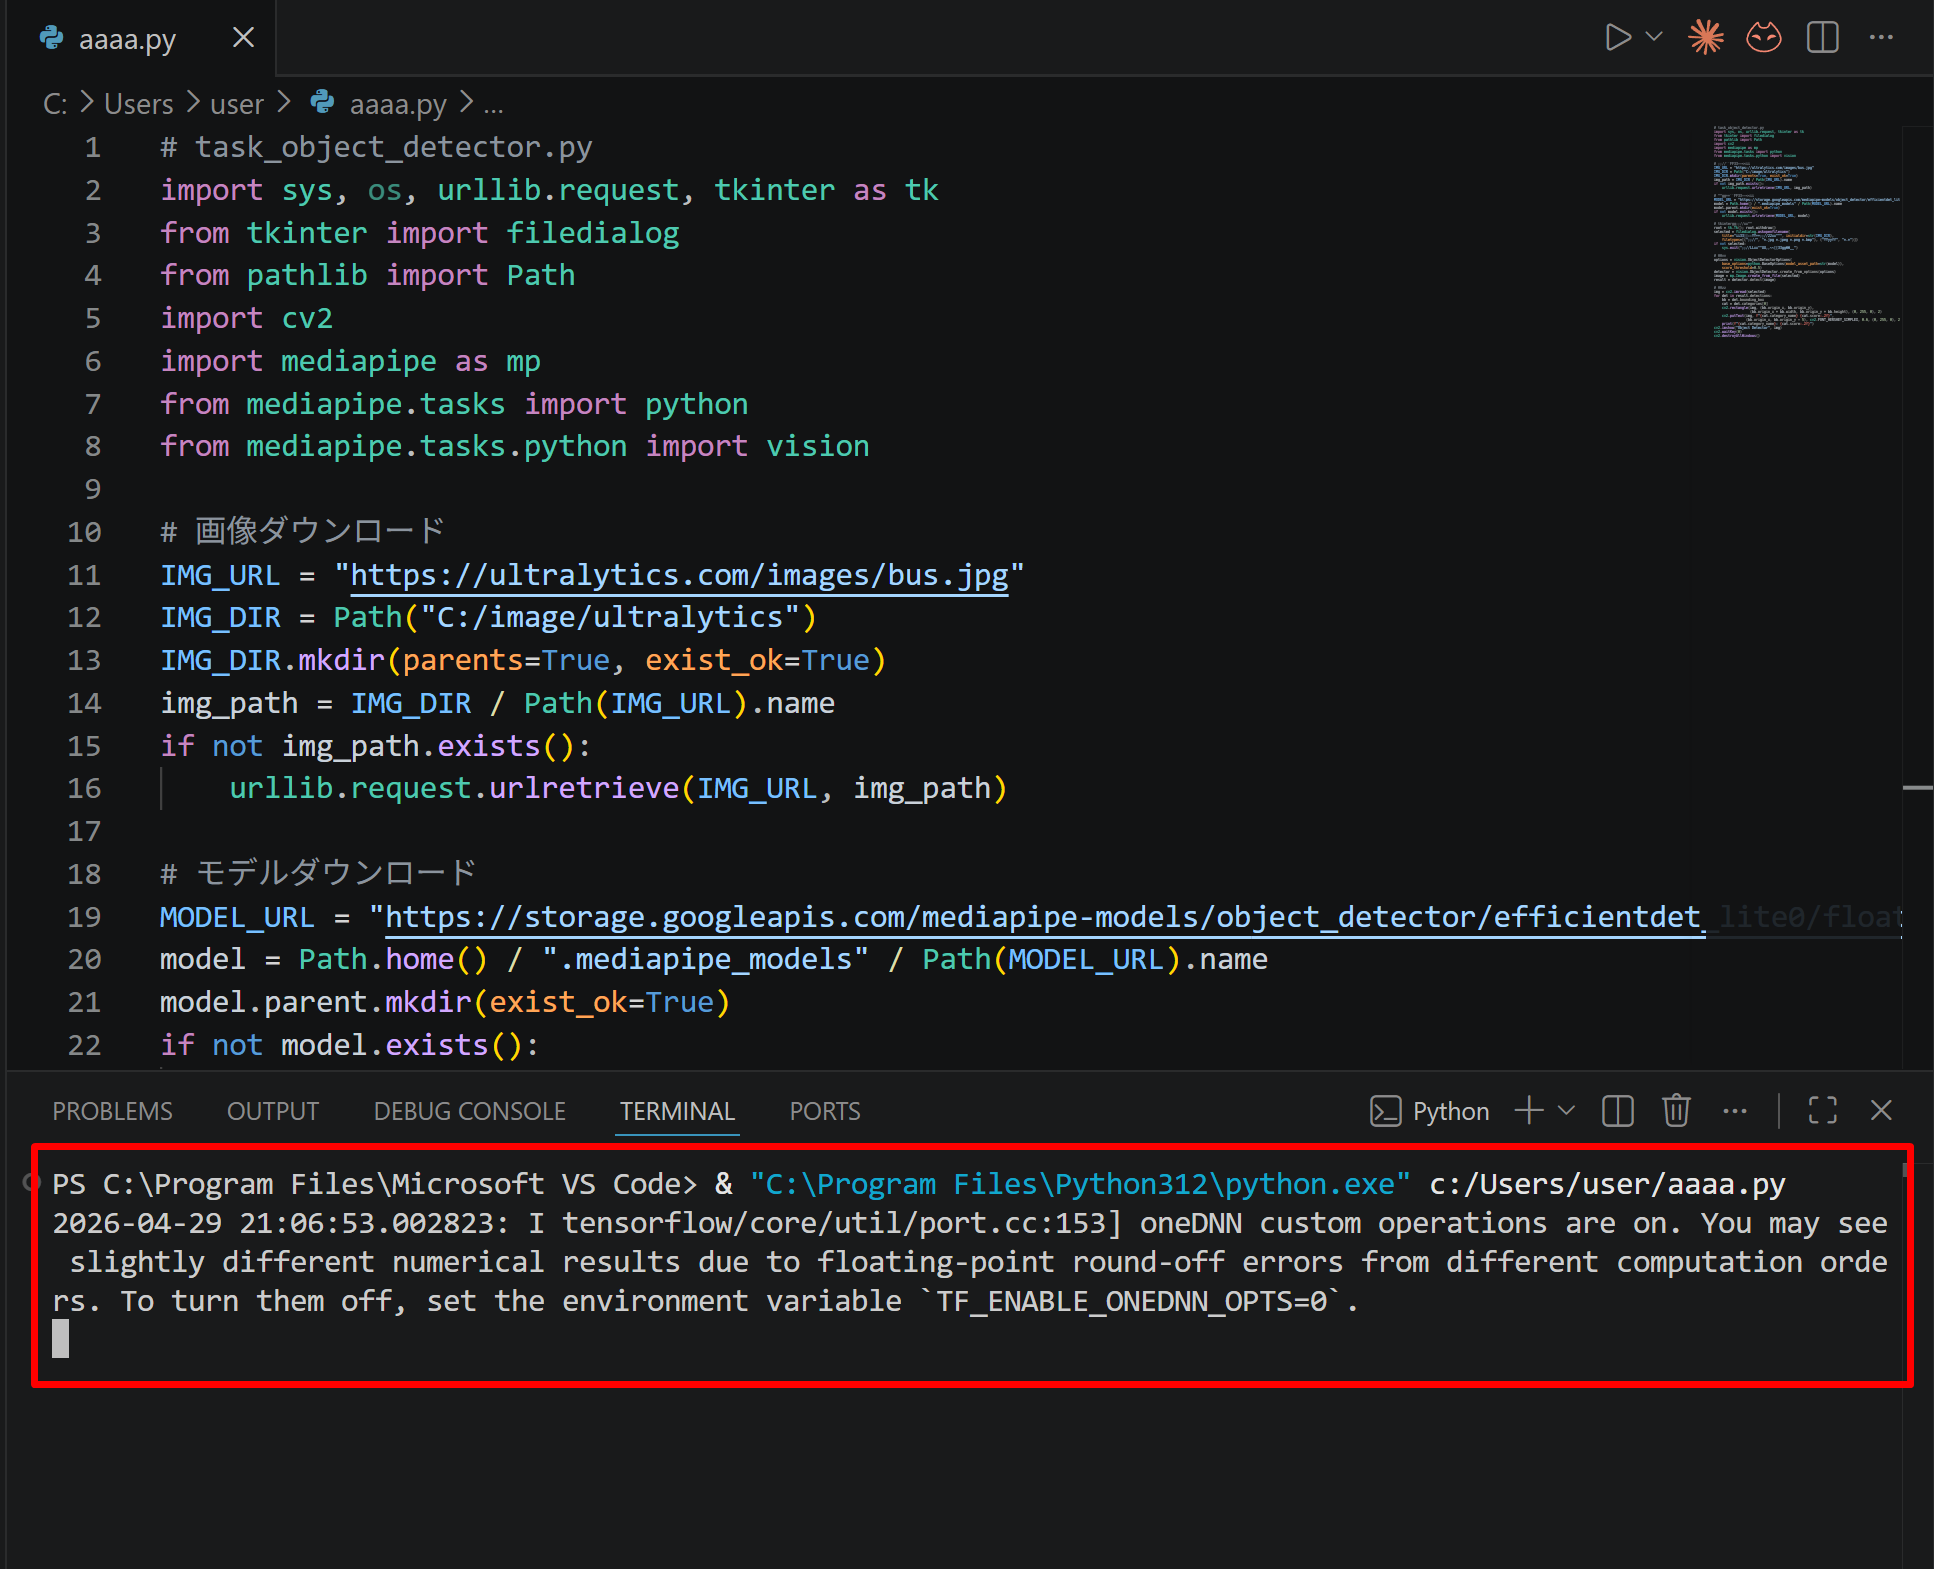
- tkinter(Python 標準の GUI ライブラリ)のファイル選択ダイアログを使うプログラムを実行した場合は,ダイアログが開くので対象画像を選択する
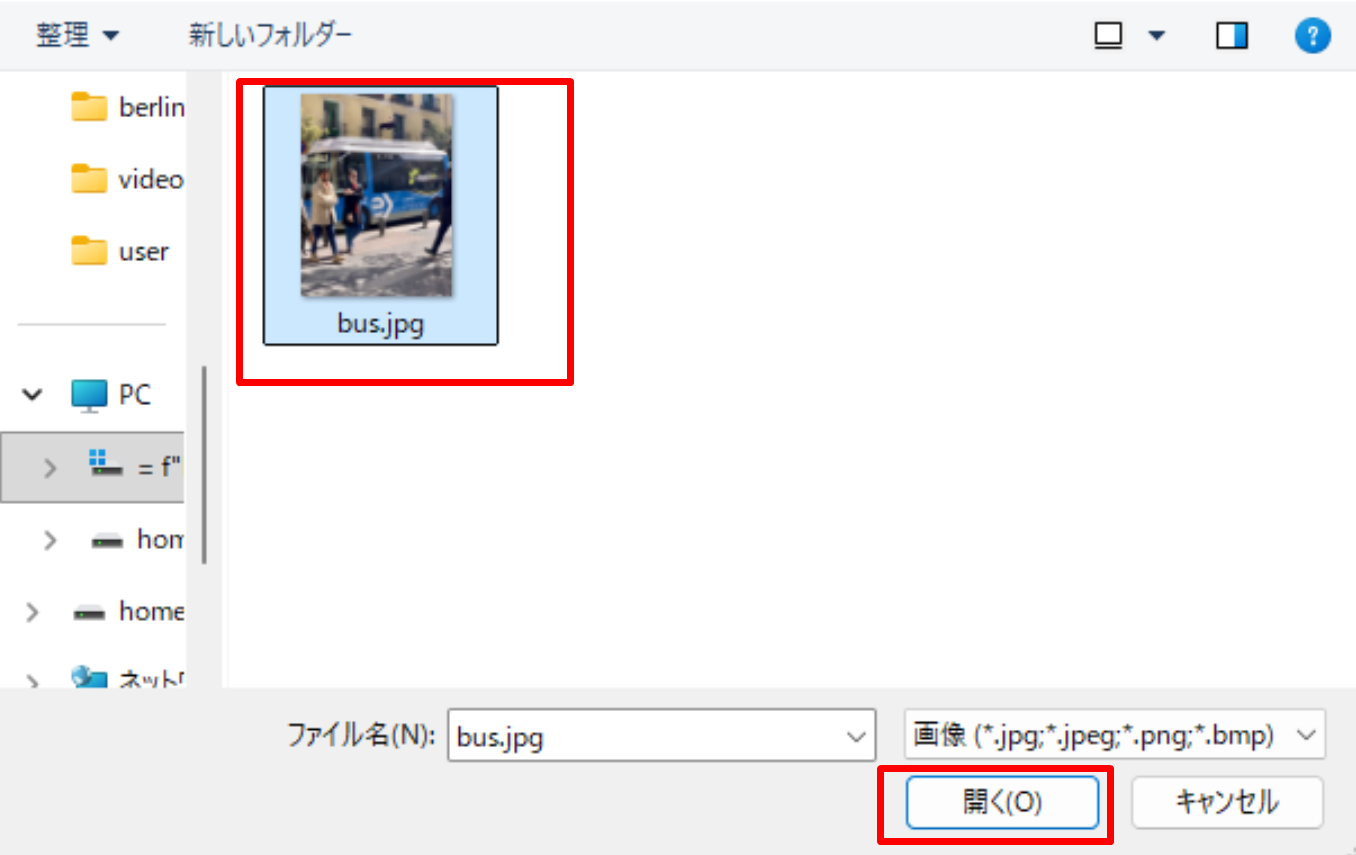
- VS Code 下部のターミナルで実行結果を確認する.OpenCV ウィンドウ(OpenCV が画像を表示するために開く専用ウィンドウ)が開いた場合はそちらも確認する.OpenCV ウィンドウは,マウスクリックでウィンドウをアクティブ(操作対象の状態)にしてからキーを押すと終了する
必要なPythonライブラリのインストール
- 管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー →
cmdと入力 → 右クリック → 「管理者として実行」)。 - 以下のコマンドで必要なライブラリをインストールする。
pip install -U pandas numpy matplotlib scipy statsmodels
Matplotlibの日本語表示設定(Windows)
グラフ内の日本語が文字化けしないよう、描画前に一度だけ以下を設定する。
import matplotlib.pyplot as plt

plt.rcParams['font.family'] = ['Meiryo', 'Yu Gothic', 'MS Gothic']
plt.rcParams['axes.unicode_minus'] = False
演習1.記述統計量の算出
手順
- 次のコードを実行する。
- 「得点」列の平均値、標準偏差、分散、中央値、第1四分位数、第3四分位数、歪度、尖度を出力する。
describe()による全体の記述統計量と、科目別の記述統計量を確認する。- 標準偏差の
ddofを0に変えて再実行し、ddof=1の場合と値を比較する。
ヒント
- 標準偏差は
scores.std(ddof=1)、分散はscores.var(ddof=1)で算出する。 - 四分位数は
scores.quantile(0.25)とscores.quantile(0.75)で算出する。 - 歪度と尖度は
stats.skew()とstats.kurtosis()で算出する。
考察ポイント
- 平均値と中央値の大小関係から、分布の偏りの向きを読み取る。
- 歪度の符号と、平均値・中央値の大小関係が一致するかを確認する。
ddof=0とddof=1で標準偏差がどちらが大きいかを確認する。- 科目別の平均値と標準偏差を比較し、科目ごとの得点傾向を確認する。
import pandas as pd
from scipy import stats

data = {
    '科目': ['国語'] * 5 + ['算数'] * 5 + ['理科'] * 5,
    '受講者': ['A', 'B', 'C', 'D', 'E'] * 3,
    '得点': [
        90, 80, 85, 88, 76,
        95, 90, 92, 87, 85,
        80, 78, 85, 82, 88
    ]
}

df = pd.DataFrame(data)
df['科目'] = pd.Categorical(df['科目'], categories=['国語', '算数', '理科'], ordered=True)
df['受講者'] = pd.Categorical(df['受講者'], categories=['A', 'B', 'C', 'D', 'E'], ordered=True)
df['得点'] = df['得点'].astype('int32')

scores = df['得点']
score_array = scores.to_numpy()

print("データフレーム:")
print(df)

print("\n基本統計量:")
print(f"平均値: {scores.mean():.1f}")
print(f"標準偏差(ddof=1): {scores.std(ddof=1):.1f}")
print(f"分散(ddof=1): {scores.var(ddof=1):.1f}")
print(f"中央値: {scores.median():.1f}")
print(f"最大値: {scores.max()}")
print(f"最小値: {scores.min()}")
print(f"第1四分位数: {scores.quantile(0.25):.1f}")
print(f"第3四分位数: {scores.quantile(0.75):.1f}")
print(f"歪度: {stats.skew(score_array, bias=True):.3f}")
print(f"尖度(超過尖度): {stats.kurtosis(score_array, fisher=True, bias=True):.3f}")

print("\ndescribe()による基本統計量:")
print(scores.describe())

print("\n科目別の記述統計量:")
print(df.groupby('科目', observed=True)['得点'].describe())
演習2.箱ひげ図とヒストグラムの作成
手順
- 次のコードを実行する。
- 科目別の箱ひげ図と、得点全体のヒストグラムを出力する。
- ヒストグラムの
binsをrange(0, 101, 5)に変えて再実行する。
ヒント
- 箱ひげ図は
df.boxplot(column='得点', by='科目')で作成する。 binsは区間の境界を表し、range(0, 101, 10)は0から100まで10点刻みを指定する。
考察ポイント
- 箱ひげ図の箱の位置と幅から、科目間の得点傾向の違いを読み取る。
binsの幅を10から5に変えると、分布の見え方がどう変わるかを確認する。
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams['font.family'] = ['Meiryo', 'Yu Gothic', 'MS Gothic']
plt.rcParams['axes.unicode_minus'] = False

data = {
    '科目': ['国語'] * 5 + ['算数'] * 5 + ['理科'] * 5,
    '受講者': ['A', 'B', 'C', 'D', 'E'] * 3,
    '得点': [
        90, 80, 85, 88, 76,
        95, 90, 92, 87, 85,
        80, 78, 85, 82, 88
    ]
}

df = pd.DataFrame(data)
df['科目'] = pd.Categorical(df['科目'], categories=['国語', '算数', '理科'], ordered=True)
df['受講者'] = pd.Categorical(df['受講者'], categories=['A', 'B', 'C', 'D', 'E'], ordered=True)
df['得点'] = df['得点'].astype('int32')

df.boxplot(column='得点', by='科目', figsize=(10, 6), grid=True)
plt.suptitle('')
plt.title('科目別得点分布', pad=15)
plt.ylabel('得点')
plt.savefig('score_distribution.png', bbox_inches='tight')
plt.show()
plt.close()

plt.figure(figsize=(10, 6))
plt.hist(df['得点'], bins=range(0, 101, 10), edgecolor='black')
plt.title('得点分布のヒストグラム')
plt.xlabel('得点')
plt.ylabel('頻度')
plt.grid(True)
plt.savefig('score_histogram.png', bbox_inches='tight')
plt.show()
plt.close()
演習3.クロス集計表とカイ二乗独立性検定
手順
- 次のコードを実行する。
- クロス集計表、合計付きの表、期待度数、カイ二乗統計量、p値、自由度、Cramér's Vを出力する。
ヒント
- カイ二乗検定には合計を含まない集計表を渡す。
chi2_contingencyの戻り値はカイ二乗統計量、p値、自由度、期待度数の順である。correction=Falseを明示し、Pearsonのカイ二乗統計量を用いる。
考察ポイント
- p値と有意水準(0.05)の比較から、2変数が独立かどうかを判断する。
- Cramér's Vの大きさから、関連の強さを読み取る。
- 期待度数が十分に大きいデータでカイ二乗検定を行っていることを確認する。
import numpy as np
import pandas as pd
from scipy import stats

data = {
    '学習方法': ['A'] * 30 + ['B'] * 40 + ['C'] * 50,
    '結果': (
        ['合格'] * 18 + ['不合格'] * 12
        + ['合格'] * 10 + ['不合格'] * 30
        + ['合格'] * 32 + ['不合格'] * 18
    )
}

df = pd.DataFrame(data)
df['学習方法'] = pd.Categorical(df['学習方法'], categories=['A', 'B', 'C'], ordered=True)
df['結果'] = pd.Categorical(df['結果'], categories=['合格', '不合格'], ordered=True)

cross_table = pd.crosstab(df['学習方法'], df['結果'])
print("クロス集計表:")
print(cross_table)

cross_with_margins = pd.crosstab(df['学習方法'], df['結果'], margins=True)
print("\n合計付きクロス集計表(合計の名称はAll):")
print(cross_with_margins)

chi2, p, dof, expected = stats.chi2_contingency(cross_table, correction=False)
expected_df = pd.DataFrame(expected, index=cross_table.index, columns=cross_table.columns)

print("\n期待度数:")
print(expected_df.round(2))

print(f"\nカイ二乗統計量: {chi2:.3f}, p値: {p:.3f}, 自由度: {dof}")

n = cross_table.to_numpy().sum()
r, k = cross_table.shape
cramers_v = np.sqrt(chi2 / (n * (min(r, k) - 1)))
print(f"Cramér's V: {cramers_v:.3f}")
演習4.相関分析
手順
- 次のコードを実行する。
- Pearson相関行列、Pearson相関係数とp値、Spearman相関係数とp値を出力する。
ヒント
- 相関行列は
df.corr(method='pearson')で算出する。 - 個別の相関係数とp値は
stats.pearsonrとstats.spearmanrで算出し、いずれも相関係数、p値の順で返る。
考察ポイント
- PearsonとSpearmanの値の違いから、関係が線形か単調かを読み取る。
- p値と有意水準(0.05)の比較から、相関が有意かを判断する。
import pandas as pd
from scipy import stats

df = pd.DataFrame({
    'x': [1, 2, 3, 4, 5, 6, 7, 8],
    'y': [2, 1, 4, 3, 6, 5, 8, 7]
})

print("Pearson相関行列:")
print(df.corr(method='pearson'))

x = df['x'].to_numpy()
y = df['y'].to_numpy()

r_p, p_p = stats.pearsonr(x, y)
r_s, p_s = stats.spearmanr(x, y)

print(f"\nPearson r: {r_p:.3f} (p={p_p:.3f})")
print(f"Spearman r: {r_s:.3f} (p={p_s:.3f})")
演習5.等分散性検定とt検定
手順
- 次のコードを実行する。
- Levene検定の統計量とp値、Welchのt検定のt値、p値、自由度を出力する。
ヒント
- 乱数のシードを固定すると、実行のたびに同じ結果が得られる。
- Levene検定で
center='median'を指定した場合はBrown-Forsythe検定に相当する。 - t検定の戻り値
TtestResultはstatistic、pvalue、dfを持つ。
考察ポイント
- Levene検定のp値と有意水準(0.05)の比較から、等分散の仮定が妥当かを判断する。
- t検定のp値と有意水準(0.05)の比較から、2群の平均値に有意な差があるかを判断する。
import numpy as np
from scipy import stats

np.random.seed(42)
group1 = np.random.normal(0, 1, 100)
group2 = np.random.normal(0.5, 1, 100)

lev_stat, lev_p = stats.levene(group1, group2, center='median')
print(f"Levene検定: 統計量={lev_stat:.3f}, p値={lev_p:.3f}")

res = stats.ttest_ind(group1, group2, equal_var=False, alternative='two-sided')
print(f"t値: {res.statistic:.3f}")
print(f"p値: {res.pvalue:.3f}")
print(f"自由度: {res.df:.1f}")
演習6.Mann-Whitney U検定(ノンパラメトリック)
手順
- 次のコードを実行する。
- U統計量とp値を出力する。
alternativeを'greater'に変えて再実行し、両側検定の場合と結果を比較する。
ヒント
- 正規性が仮定できない場合に、t検定の代わりに用いることがある(Wilcoxon順位和検定と等価に扱われる)。
stats.mannwhitneyuの戻り値はstatistic(U統計量)とpvalueを持つ。alternative='greater'は、第1引数のgroup1が第2引数のgroup2より大きい方向の片側検定である。
考察ポイント
- p値と有意水準(0.05)の比較から、2群の順位分布に有意な差があるかを判断する。
- 演習5のt検定と同じデータでの結果を比べ、両手法の違いを読み取る。
- このデータでは
group2の平均を0.5だけ高くしているため、片側検定の方向指定が結果に与える影響を確認する。
import numpy as np
from scipy import stats

np.random.seed(42)
group1 = np.random.normal(0, 1, 100)
group2 = np.random.normal(0.5, 1, 100)

res = stats.mannwhitneyu(group1, group2, alternative='two-sided', method='asymptotic')
print(f"U統計量: {res.statistic:.3f}")
print(f"p値: {res.pvalue:.3f}")
演習7.分散分析と多重比較
手順
- 次のコードを実行する。
- 分散分析のF値とp値、Tukey HSDの結果の表を出力する。
ヒント
- 多重比較には、全群の値を結合した配列(
endog)と、対応する群ラベル(groups)を渡す。
考察ポイント
- 分散分析のp値と有意水準(0.05)の比較から、群間に差があるかを判断する。
- Tukey HSDの表のp値と有意判定から、どの群間に有意な差があるかを読み取る。
import numpy as np
from scipy import stats
from statsmodels.stats.multicomp import pairwise_tukeyhsd

group_a = [3.42, 3.84, 3.96, 3.76]
group_b = [3.17, 3.63, 3.47, 3.44, 3.39]
group_c = [3.64, 3.72, 3.91]

f_stat, p_value = stats.f_oneway(group_a, group_b, group_c)
print(f"F値: {f_stat:.3f}")
print(f"p値: {p_value:.3f}")

values = np.array(group_a + group_b + group_c)
labels = (['A'] * len(group_a)) + (['B'] * len(group_b)) + (['C'] * len(group_c))

tukey = pairwise_tukeyhsd(endog=values, groups=labels, alpha=0.05)
print(tukey)
演習8.正規性の検定
手順
- 次のコードを実行する。
- 正規分布から生成したデータに対し、統計量Wとp値を出力する。
- サンプル数を
100から20に変えて再実行し、結果を比較する。
ヒント
- Shapiro-Wilk検定の戻り値は統計量Wとp値を持つ。
- サンプル数は
np.random.normal(0, 1, 100)の第3引数で指定する。
考察ポイント
- p値と有意水準(0.05)の比較から、正規性を否定する根拠があるかを判断する。
- サンプル数を100から20に減らすと、p値がどう変わるかを読み取る。
import numpy as np
from scipy import stats

np.random.seed(42)
data = np.random.normal(0, 1, 100)

res = stats.shapiro(data)
print(f"検定統計量(W): {res.statistic:.3f}")
print(f"p値: {res.pvalue:.3f}")