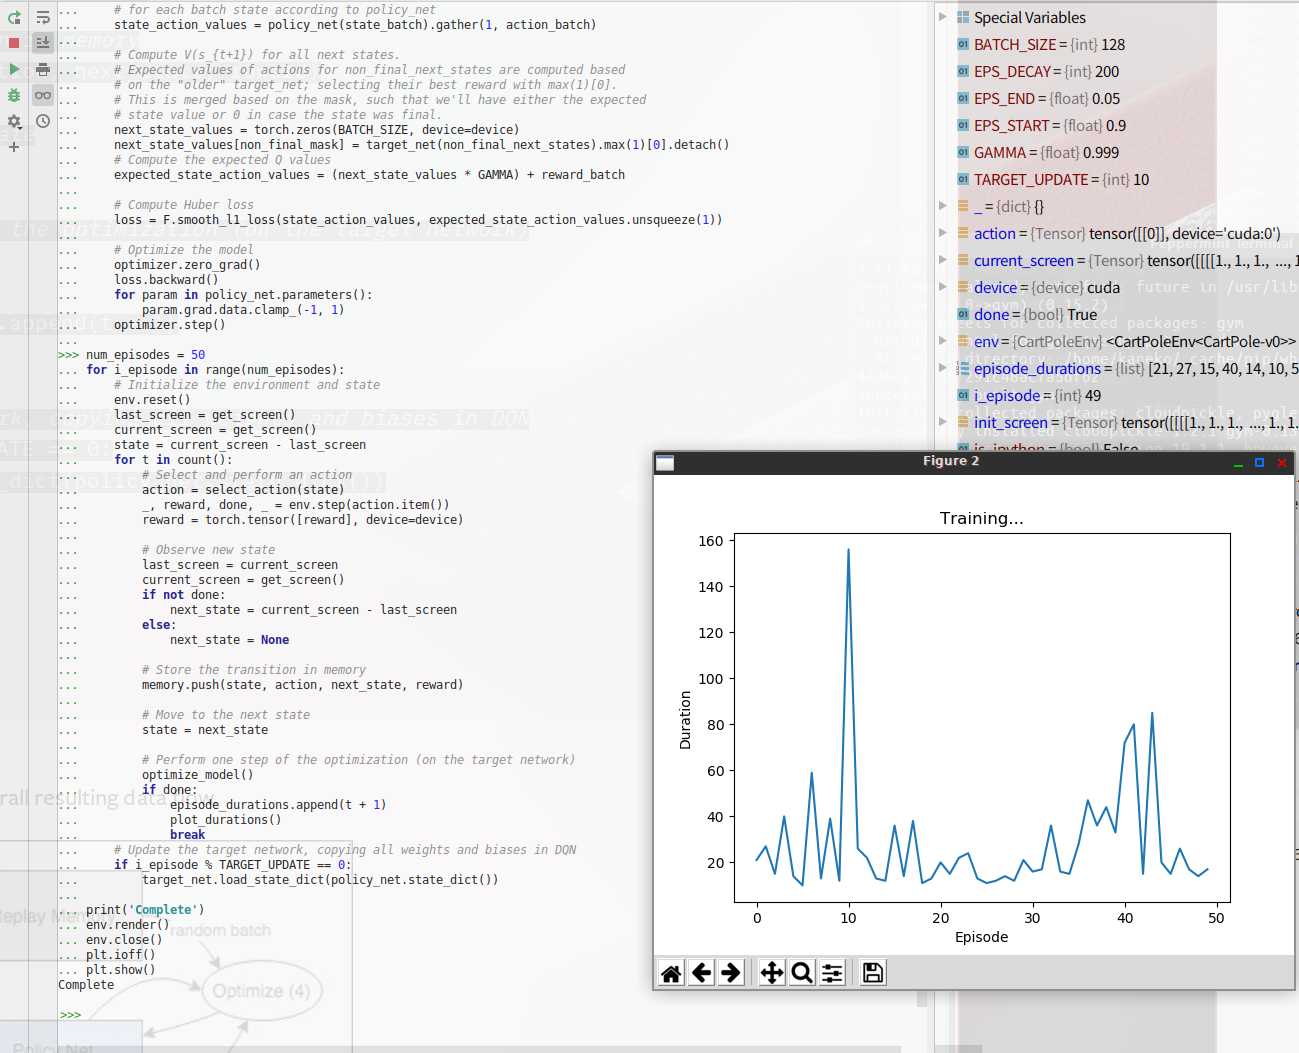
深層強化学習 CartPole-v1 を動かしてみる(PyTorch のサンプルプログラムを使用)
【概要】
ユースケース: 深層強化学習 CartPole-v1 を動かしてみたい次のWebページに記載のソースコード(DQN(Deep Q-Network)を用いた深層強化学習)を実行してみる
【目次】
【関連する外部ページ】
https://docs.pytorch.org/tutorials/intermediate/reinforcement_q_learning.html先人に感謝
PyTorch の Web ページ: http://pytorch.org
GitHub の PyTorch の Webページ: https://github.com/pytorch/pytorch
第1章 前準備
PyTorch (NVIDIA CUDA ツールキット 12.8 用)のインストール(Windows 上)
次のコマンドを実行することにより, PyTorch(NVIDIA CUDA ツールキット 12.8 用)がインストールされる.
- 管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー →
cmdと入力 → 右クリック → 「管理者として実行」)。 - PyTorch の公式ページを確認
- 次のようなコマンドを実行(実行するコマンドは,PyTorch のページに表示されるコマンドを使う).
次のコマンドを実行することにより, PyTorch(NVIDIA CUDA 12.8 用)がインストールされる. 但し,Anaconda3を使いたい場合には別手順になる.
事前に NVIDIA CUDA のバージョンを確認しておくこと(ここでは,NVIDIA CUDA ツールキット 12.8 が前もってインストール済みであるとする).
PyTorch で,GPU が動作している場合には,「torch.cuda.is_available()」により,True が表示される.
python -m pip install -U --no-user --ignore-installed pip
python -m pip uninstall -y torch torchvision torchaudio torchtext xformers
python -m pip install -U --no-user torch torchvision torchaudio numpy --index-url https://download.pytorch.org/whl/cu128

python -c "import torch; print(torch.__version__, torch.cuda.is_available())"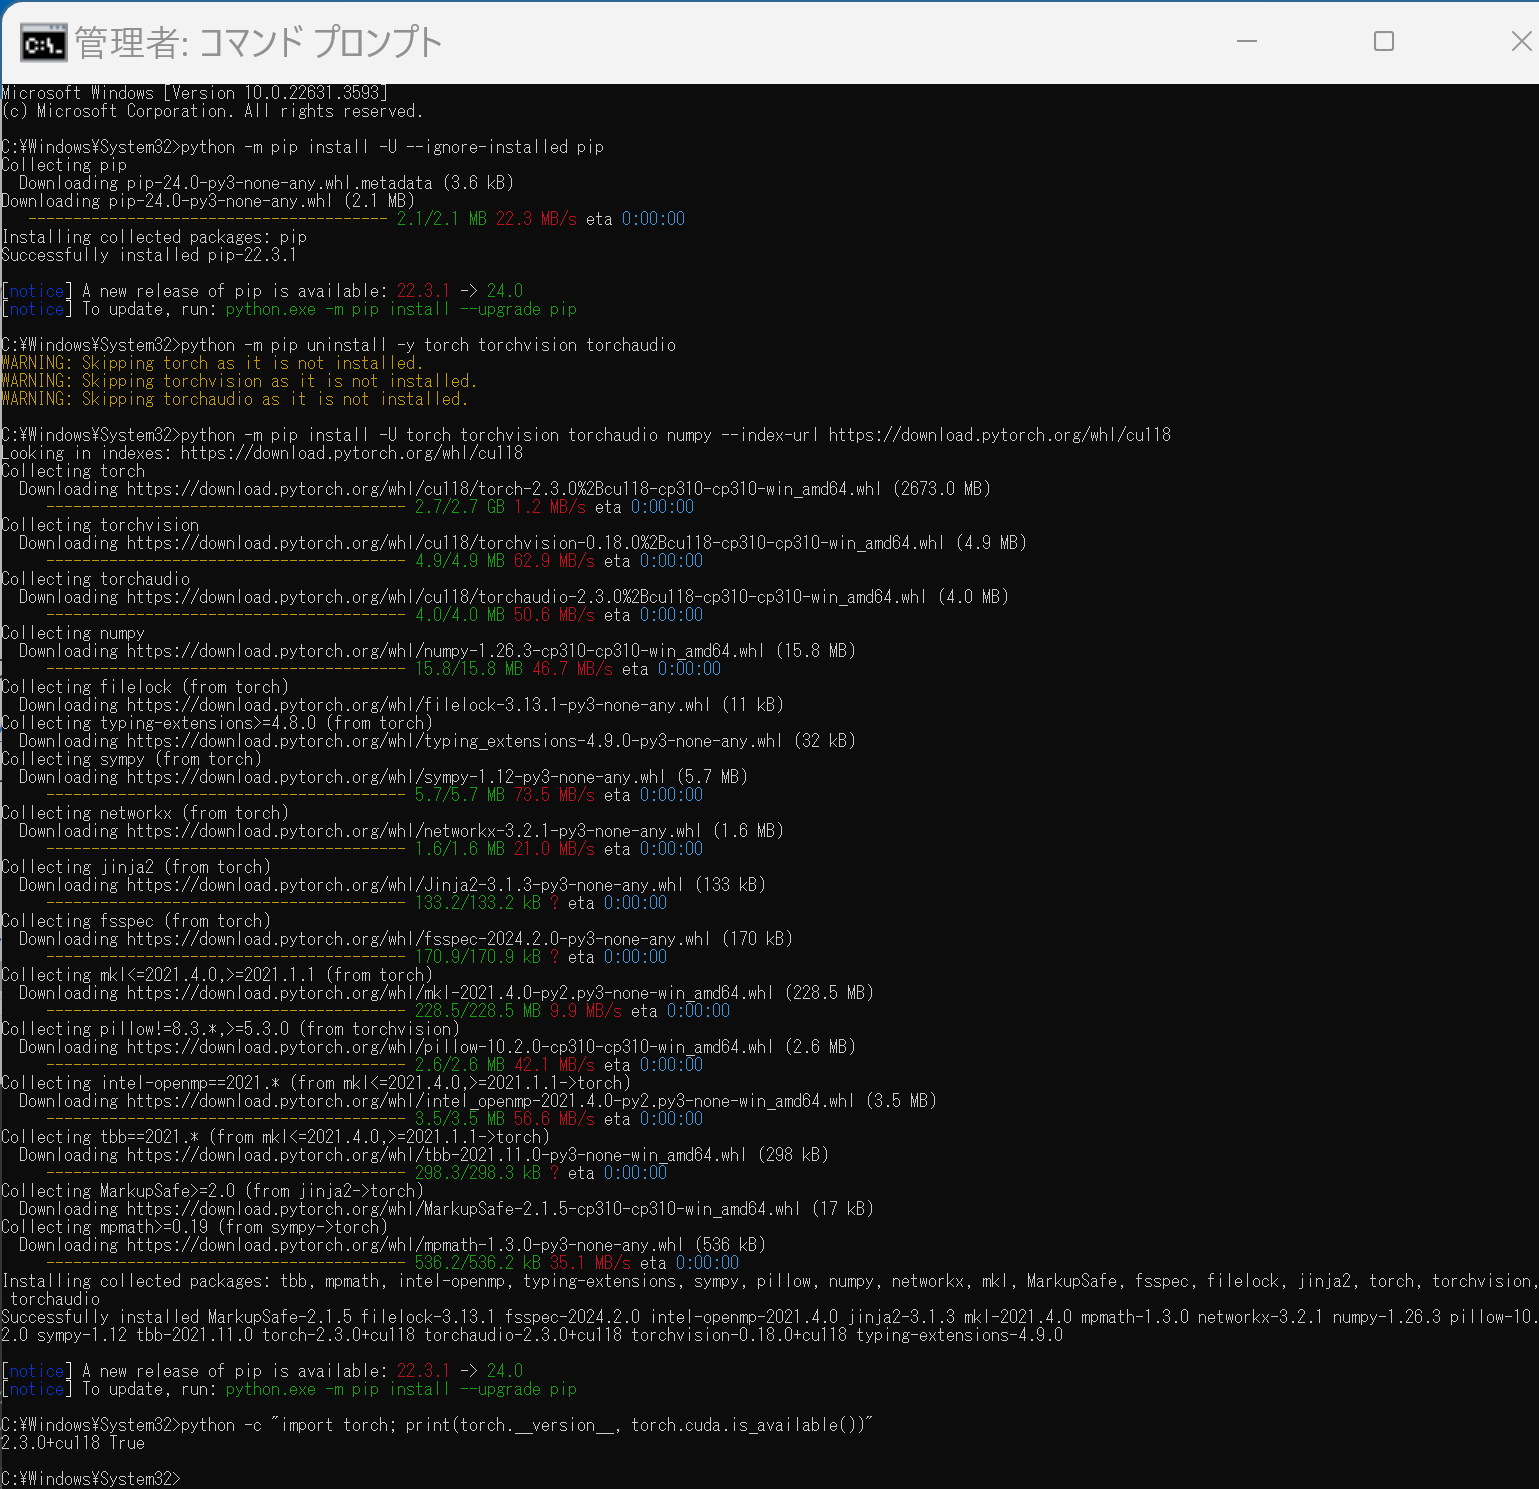
【関連する外部ページ】
【サイト内の関連情報】
- GPU対応PyTorchのセットアップと性能確認(Windows 上): 別ページ »で説明
- PyTorch の最新版を検証,開発者に貢献したいなどの場合には,ソースコードからビルドして,インストールする: 別ページ »で説明
【関連項目】 NVIDIA CUDA ツールキット, PyTorch
Gymnasium のインストール
強化学習の環境として,Gymnasium(OpenAI Gym の後継であり,現在はこちらが保守されている)を用いる.
- Ubuntu の場合
次のコマンドを実行.
pip3 install -U --no-user "gymnasium[classic_control]"
第2章 深層強化学習 CartPole-v1 を動かしてみる(PyTorch のサンプルプログラムを使用)
- Windows では python (Python ランチャーは py)
- Ubuntu では python3
Python 開発環境(Jupyter Qt Console, Jupyter ノートブック (Jupyter Notebook), Jupyter Lab, Nteract, Spyder, PyCharm, PyScripterなど)も便利である.
Python のまとめ: 別ページ »にまとめ
python
- インポート
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count

import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

env = gym.make('CartPole-v1')

# matplotlib の設定
is_ipython = 'inline' in matplotlib.get_backend()
if is_ipython:
    from IPython import display

plt.ion()

# GPU が使えれば GPU を使う
device = torch.device(
    "cuda" if torch.cuda.is_available() else
    "mps" if torch.backends.mps.is_available() else
    "cpu"
)
Ubuntu での実行結果例
- Replay Memory の作成
経験再生(Experience Replay)のためのメモリを作る.エージェントが観測した遷移(状態・行動・次の状態・報酬)を保存しておき,学習時にランダムに取り出して使うことで,学習を安定させる.
Transition = namedtuple('Transition',
                        ('state', 'action', 'next_state', 'reward'))


class ReplayMemory(object):

    def __init__(self, capacity):
        self.memory = deque([], maxlen=capacity)

    def push(self, *args):
        """遷移を保存する"""
        self.memory.append(Transition(*args))

    def sample(self, batch_size):
        return random.sample(self.memory, batch_size)

    def __len__(self):
        return len(self.memory)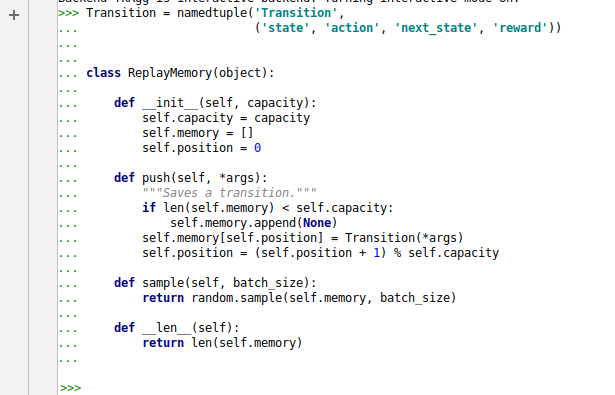
- Q-network の作成
CartPole の状態は,カートの位置・速度,ポールの角度・角速度の4個の実数値で表される.これらをそのまま全結合層に入力し,各行動(左・右)の期待収益を出力する.
class DQN(nn.Module):

    def __init__(self, n_observations, n_actions):
        super(DQN, self).__init__()
        self.layer1 = nn.Linear(n_observations, 128)
        self.layer2 = nn.Linear(128, 128)
        self.layer3 = nn.Linear(128, n_actions)

    def forward(self, x):
        x = F.relu(self.layer1(x))
        x = F.relu(self.layer2(x))
        return self.layer3(x)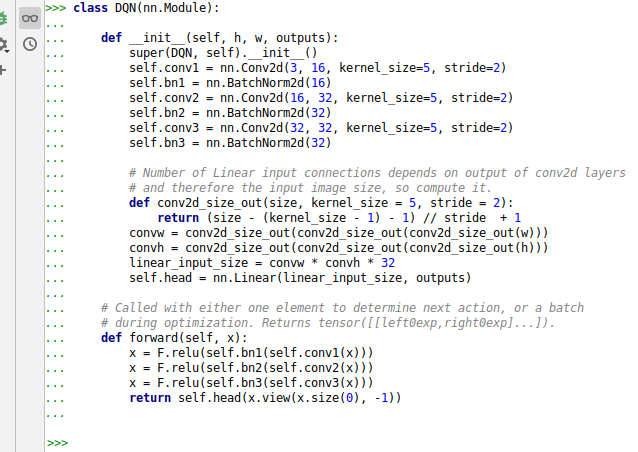
- ハイパーパラメータなど
BATCH_SIZE = 128 GAMMA = 0.99 EPS_START = 0.9 EPS_END = 0.01 EPS_DECAY = 2500 TAU = 0.005 LR = 3e-4 n_actions = env.action_space.n state, info = env.reset() n_observations = len(state) policy_net = DQN(n_observations, n_actions).to(device) target_net = DQN(n_observations, n_actions).to(device) target_net.load_state_dict(policy_net.state_dict()) optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True) memory = ReplayMemory(10000) steps_done = 0 def select_action(state): global steps_done sample = random.random() eps_threshold = EPS_END + (EPS_START - EPS_END) * \ math.exp(-1. * steps_done / EPS_DECAY) steps_done += 1 if sample > eps_threshold: with torch.no_grad(): return policy_net(state).max(1).indices.view(1, 1) else: return torch.tensor([[env.action_space.sample()]], device=device, dtype=torch.long) episode_durations = [] def plot_durations(show_result=False): plt.figure(1) durations_t = torch.tensor(episode_durations, dtype=torch.float) if show_result: plt.title('Result') else: plt.clf() plt.title('Training...') plt.xlabel('Episode') plt.ylabel('Duration') plt.plot(durations_t.numpy()) if len(durations_t) >= 100: means = durations_t.unfold(0, 100, 1).mean(1).view(-1) means = torch.cat((torch.zeros(99), means)) plt.plot(means.numpy()) plt.pause(0.001) if is_ipython: if not show_result: display.display(plt.gcf()) display.clear_output(wait=True) else: display.display(plt.gcf())「eps_threshold」は,行動をランダムに選ぶ確率(探索率)である.学習が進むにつれて
EPS_STARTからEPS_ENDへ指数的に減衰し,ランダムな探索から,学習した方策に基づく行動選択へ徐々に移行する.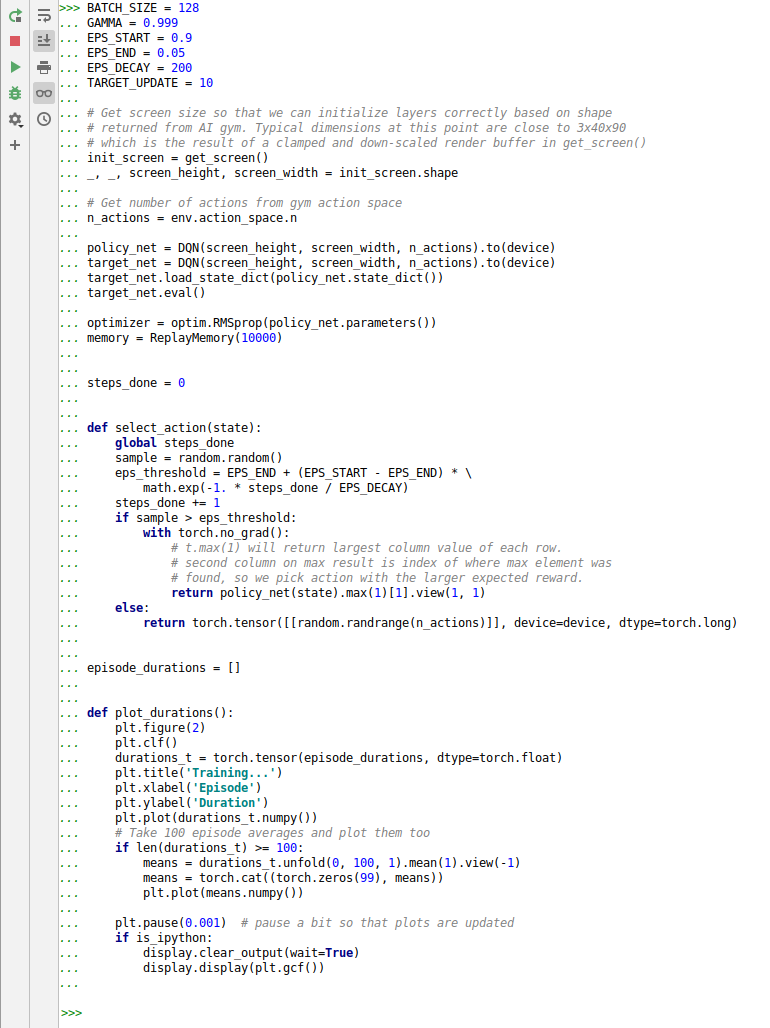
- 最適化の1ステップを実行する関数
「target_net」は,学習を安定させるための目標ネットワークである.経験再生メモリからバッチを取り出し,
policy_netによる現在の行動価値と,target_netによる次状態の価値から求めた目標値との誤差(Huber損失)を最小化する.def optimize_model(): if len(memory) < BATCH_SIZE: return transitions = memory.sample(BATCH_SIZE) batch = Transition(*zip(*transitions)) # 終端でない状態のマスクを作成する non_final_mask = torch.tensor(tuple(map(lambda s: s is not None, batch.next_state)), device=device, dtype=torch.bool) non_final_next_states = torch.cat([s for s in batch.next_state if s is not None]) state_batch = torch.cat(batch.state) action_batch = torch.cat(batch.action) reward_batch = torch.cat(batch.reward) # Q(s_t, a) を計算する state_action_values = policy_net(state_batch).gather(1, action_batch) # V(s_{t+1}) を計算する。終端状態では 0 とする next_state_values = torch.zeros(BATCH_SIZE, device=device) with torch.no_grad(): next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values expected_state_action_values = (next_state_values * GAMMA) + reward_batch # Huber損失を計算する criterion = nn.SmoothL1Loss() loss = criterion(state_action_values, expected_state_action_values.unsqueeze(1)) # モデルを最適化する optimizer.zero_grad() loss.backward() torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100) optimizer.step()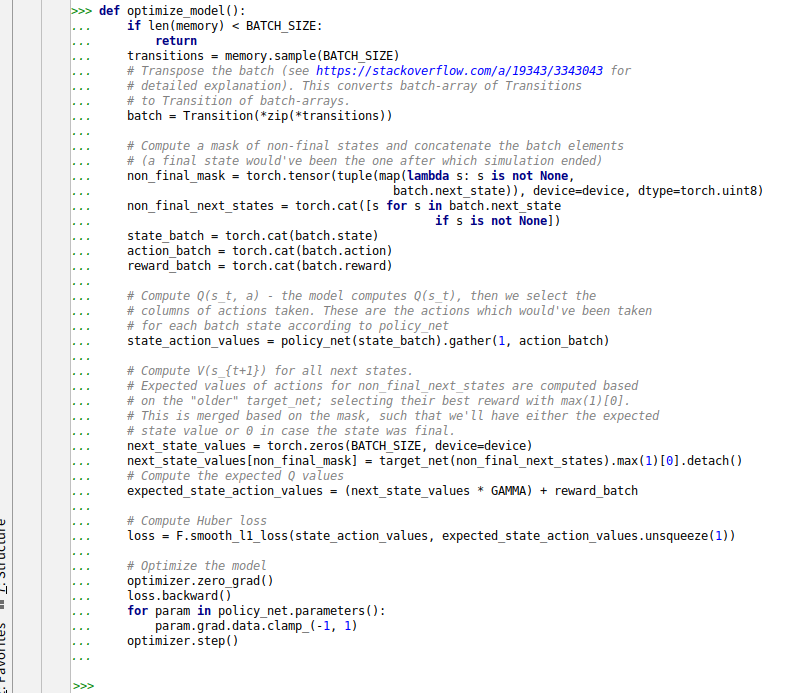
- 学習
GPU が使える場合は600エピソード,使えない場合は50エピソードを学習する.学習は雑音を含む過程であるため,収束しない場合は学習をやり直すと改善することがある.
if torch.cuda.is_available() or torch.backends.mps.is_available():
    num_episodes = 600
else:
    num_episodes = 50

for i_episode in range(num_episodes):
    state, info = env.reset()
    state = torch.tensor(state, dtype=torch.float32, device=device).unsqueeze(0)
    for t in count():
        action = select_action(state)
        observation, reward, terminated, truncated, _ = env.step(action.item())
        reward = torch.tensor([reward], device=device)
        done = terminated or truncated

        if terminated:
            next_state = None
        else:
            next_state = torch.tensor(observation, dtype=torch.float32, device=device).unsqueeze(0)

        # 遷移をメモリに保存する
        memory.push(state, action, next_state, reward)

        # 次の状態へ移る
        state = next_state

        # 最適化を1ステップ実行する(policy_net について)
        optimize_model()

        # target_net の重みをソフト更新する
        # θ' ← τθ + (1 − τ)θ'
        target_net_state_dict = target_net.state_dict()
        policy_net_state_dict = policy_net.state_dict()
        for key in policy_net_state_dict:
            target_net_state_dict[key] = policy_net_state_dict[key] * TAU + target_net_state_dict[key] * (1 - TAU)
        target_net.load_state_dict(target_net_state_dict)

        if done:
            episode_durations.append(t + 1)
            plot_durations()
            break

print('Complete')
plot_durations(show_result=True)
plt.ioff()
plt.show()