二次索引 (secondary index)
- 索引 (index)
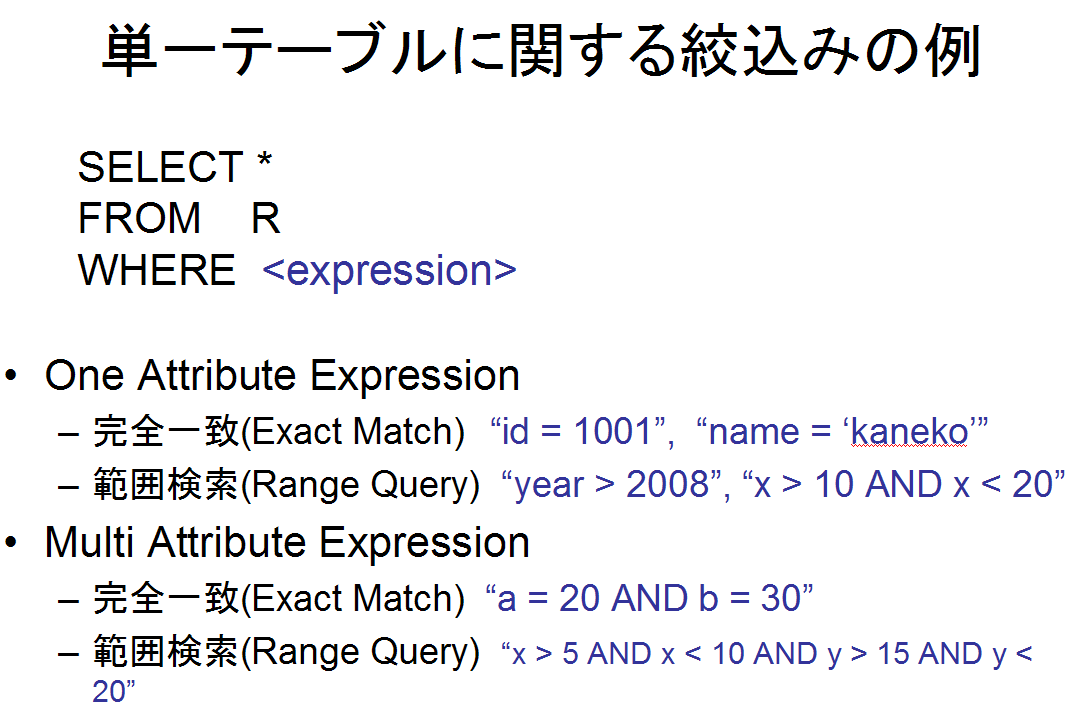
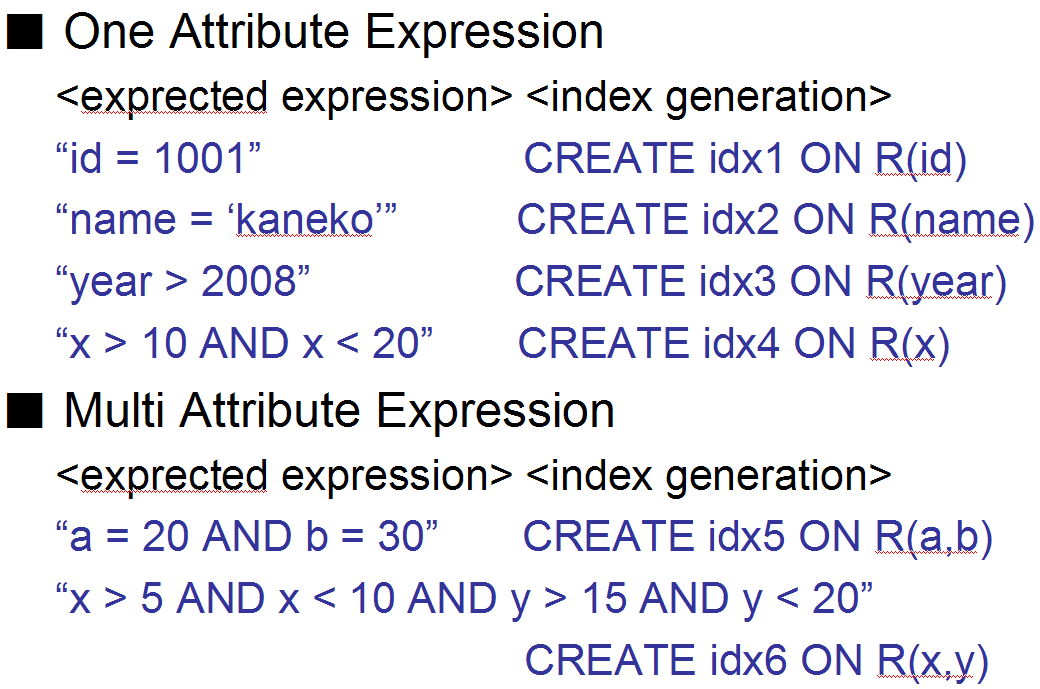
索引を用いることで,レコードを効率よく検索できる.
ただし,レコードの更新時には索引の維持 (maintenance) が必要になるため,索引を増やしすぎると更新が遅くなる.
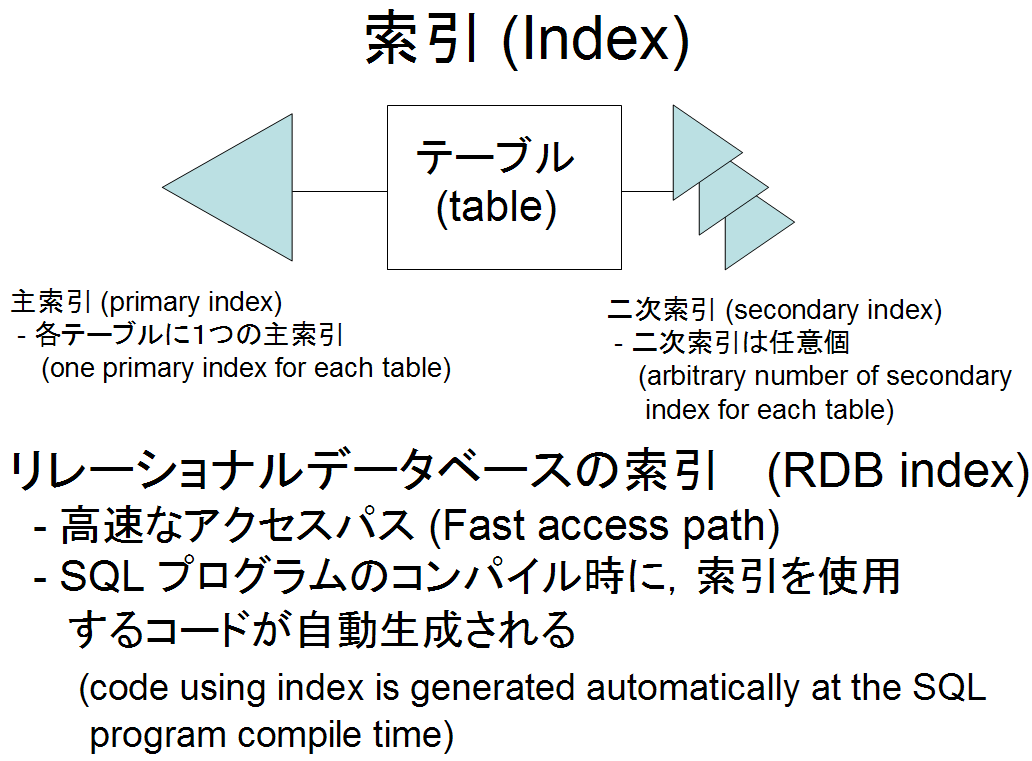
- 主索引 (primary index)
主キー (primary key) の値とレコードを直接結びつける索引構造を,この資料では「主索引」と呼ぶ.
1つのテーブルに,主索引は1つである.
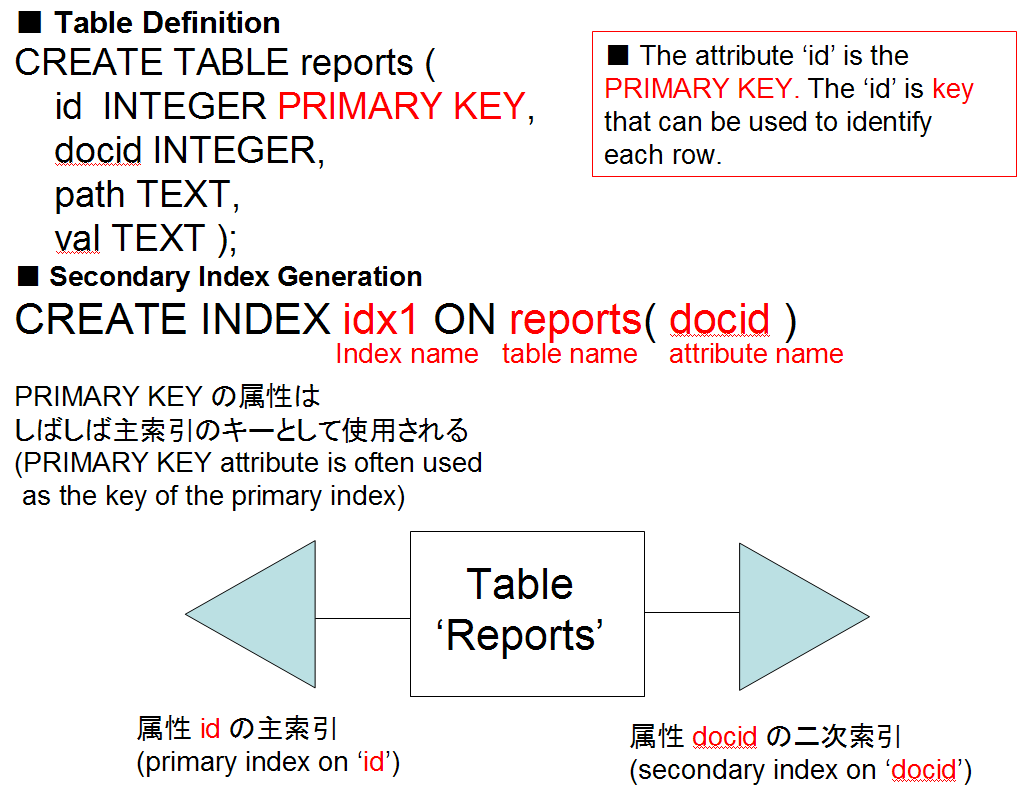
テーブル定義で「primary key」と指定した属性が主キーになる. 「primary key」の指定がないときは,データベース管理システムが各行の識別番号を自動生成し,それを主索引のキーとして使う.
- 二次索引 (secondary index)
主索引のキー以外の属性による索引構造.
二次索引は,1つのテーブルに対して複数作ることができ,追加と削除が自由にできる.
【SQLite 3 の主要なオペコード (Opcode) の要点】
- OpenRead: ルート・ページが P2 であるようなテーブルのカーソルを作る. P1 にはカーソル番号を設定する. P4 には,テーブルの列数,または KeyInfo 構造体へのポインタを設定する.
- Rewind: 後続の Column, Rowid, Next 命令の実行に備えて,カーソル P1 をテーブルの先頭を指し示すようにする.テーブルが空の場合には,アドレス P2 にジャンプする.
- Column: カーソル P1 (cursor P1) が指し示すレコードの P2 番目の列 (P2-th column) からデータを取り出して,レジスタ P3 に格納する.(列番号は 0 から始まる)
- Rowid: カーソル P1 (cursor P1) が指し示すレコードの主キーの値を,レジスタ P2 に格納する.
- MakeRecord:
レジスタ P1 からレジスタ (P1+P2-1) までの値から,テーブルの1行,または索引のキー (key) として使うレコードを作る.
P4 には column affinity を文字列として指定する.column affinity の各文字は,SQLite 3 のソースコード (sqliteInt.h) で次のように定義されている(値は SQLite 3 のバージョンによって異なる).
#define SQLITE_AFF_BLOB     0x41  /* 'A' */
#define SQLITE_AFF_TEXT     0x42  /* 'B' */
#define SQLITE_AFF_NUMERIC  0x43  /* 'C' */
#define SQLITE_AFF_INTEGER  0x44  /* 'D' */
#define SQLITE_AFF_REAL     0x45  /* 'E' */
- IdxInsert: 索引 P1 にデータを挿入する.
- ResultRow: レジスタ P1 からレジスタ (P1+P2-1) までの値を1行として出力する.
- SeekGe: カーソル P1 がテーブルを指し示しているときは,レジスタ P3 の値を検索キーとして使う. カーソル P1 が索引を指し示すときは,レジスタ P3 からレジスタ (P3+P4-1) までを検索キーとして使う. カーソル P1 の位置を,検索キー以上の要素のうち最小の要素を指し示すように動かす.そのような要素がない場合には P2 にジャンプする.
- IdxGE: レジスタ P3 からレジスタ (P3+P4-1) までを検索キーとして使う. カーソル P1 が指し示す索引エントリ (index entry) が検索キー以上ならば,P2 にジャンプする.さもなければ次に進む.
- Eq: レジスタ P1 の値とレジスタ P3 の値が等しいときに限り,アドレス P2 (address P2) にジャンプする.
- Ne: レジスタ P1 の値とレジスタ P3 の値が等しくないときに限り,アドレス P2 (address P2) にジャンプする.
- Next: カーソル P1 (cursor P1) が指し示すレコードが末端レコードならば,次の命令に進む. 末端レコードでなければ,カーソル P1 (cursor P1) を1つ進めて,アドレス P2 (address P2) にジャンプする.
- Goto: アドレス P2 (address P2) にジャンプする.
* SQLite 3 のオペコードの説明は https://www.sqlite.org/opcode.html にある.
* SQLite 3 の SQL の説明は https://www.sqlite.org/lang.html (English Web Page) にある.
SQL による二次索引の生成と削除
- CREATE INDEX <index-name> ON <table-name> ( <column-name の並び> )
テーブル名と属性名を指定して,二次索引を生成する.「index-name」は二次索引の名前で,二次索引の削除などに使う.
- DROP INDEX <index-name>;
索引名を指定して二次索引を削除する.
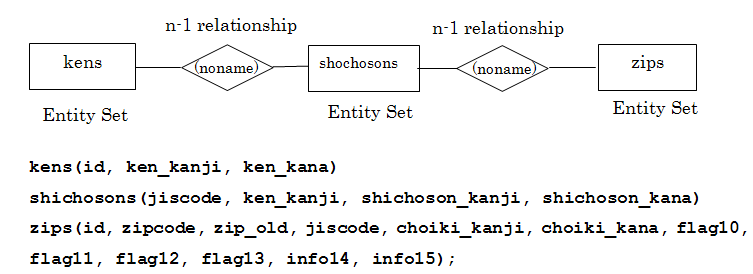
郵便番号データベース (Japanese ZIP code database)
郵便番号データベースは zips, kens, shichosons の 3 つのテーブルから構成される.
郵便番号データベースの作成手順は 別の Web ページで説明している.
Sqliteman で既存のデータベースを開く
作成済みのデータベースファイルは,次の手順で開く. (Open an existing database file)
- Sqliteman を起動する
- 「File」→
「Open」
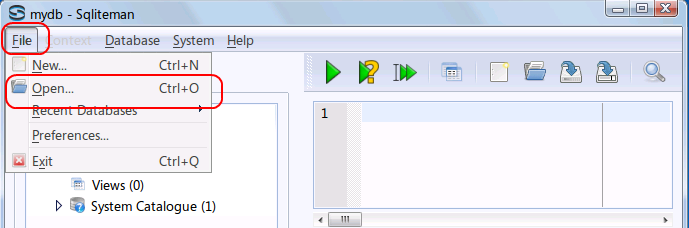
- データベースファイルを開く
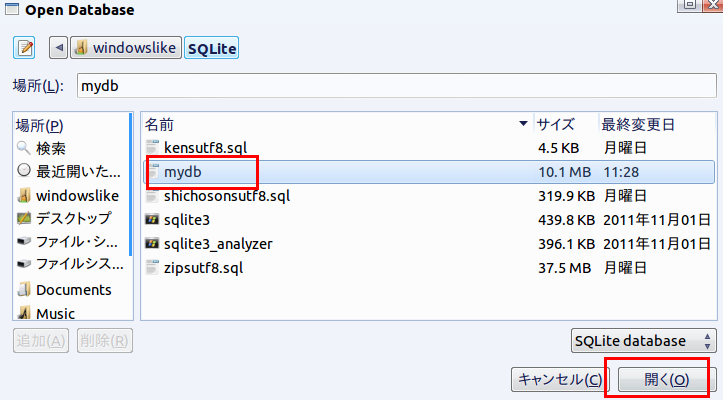
* Ubuntu での実行例
データベースファイル SQLite/mydb を選び, 「開く」をクリック (Click '開く' after choosing the database file "SQLite/mydb")
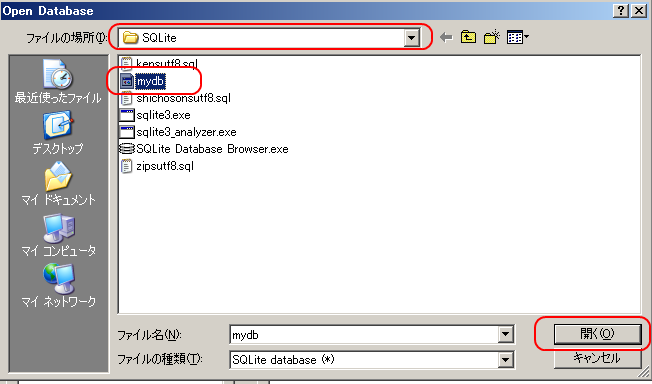
* Windows での実行例
データベースファイル C:\sqlite3\mydb を選び, 「開く」をクリック (Click '開く' after choosing the database file "C:\sqlite3\mydb")
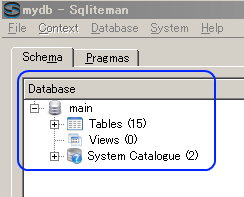
- データベースの中身が表示されるので確認する (Database appears)
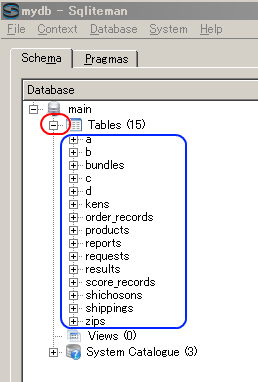
- 「Tables」を展開すると,テーブルの一覧 (List of Tables) が表示されるので確認する (List of tables appears by clicking 'Tables')
Sqliteman を用いたデータのブラウズ
zips, kens, shichosons テーブルの中身を表示する. 表示できないときは,zips, kens, shichosons テーブルの作成を行う. その手順は 別ページ »で説明している.
- zips テーブル
オブジェクト・ブラウザ (Object Browser) の中の zips テーブルを選ぶ (Select table 'zips')
テーブル zips が表示される (table 'zips' appears)
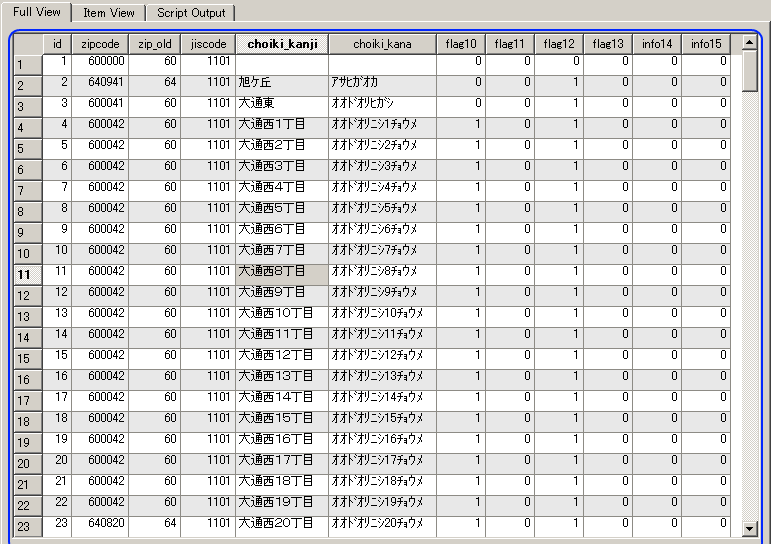
データベースの構造の確認 (Database Structure)
- sqlite_master をクリック (Click 'sqlite_master')
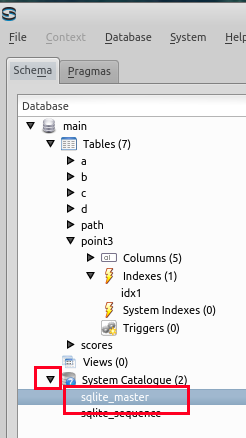
- テーブルと二次索引のルート・ページ番号が分かる
(Root page number of each table and secondary index)
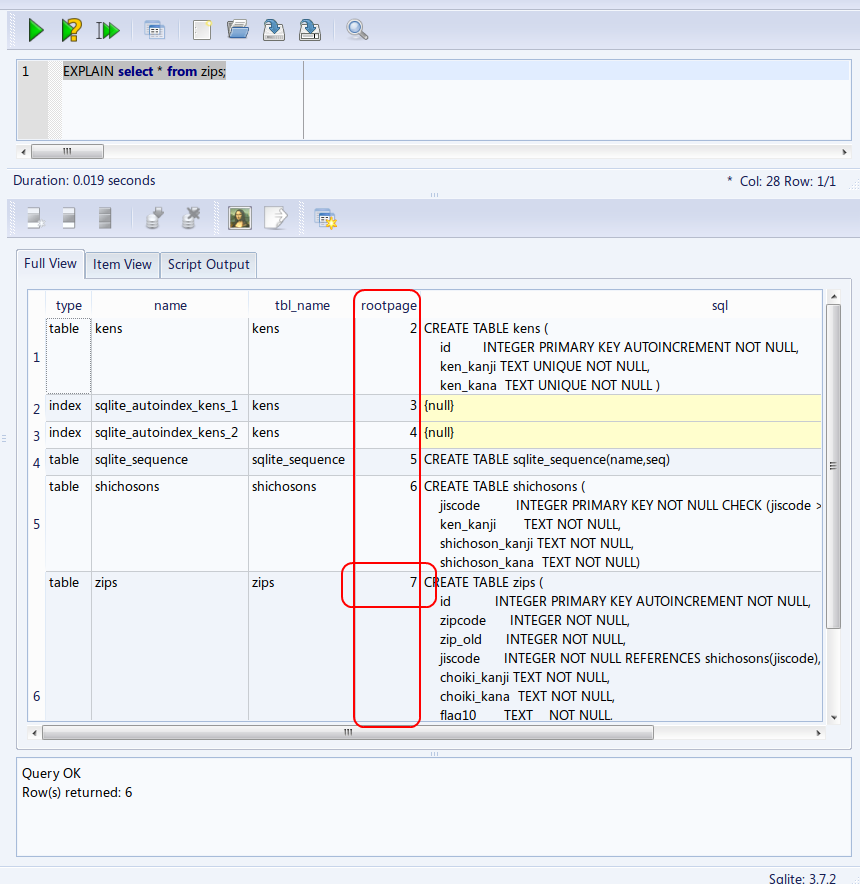
この資料では,zips, kens, shichosons の 3 つのテーブルのルートページ (root page) が次の値であるとして説明する.
- kens のルートページ: 2
- shichosons のルートページ: 6
- zips のルートページ: 7
* ルート・ページ番号はデータベース管理システムが決める値なので, 上とは違う値になることが多い.
(The number is automatically decided by the database management system)
Sqliteman を用いた SQL 問い合わせ計画の表示
単一テーブルに対する問い合わせの SQL 問い合わせ計画の表示例 (SQL query plan)
条件を満足する行のみの表示 (List the rows which satisfy a given condition)
- SQL の問い合わせの発行と評価結果の確認
SELECT zipcode, choiki_kanji FROM zips WHERE zipcode = 8190012;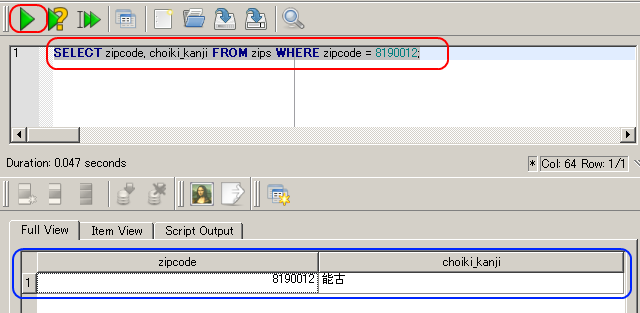
- SQL 問い合わせ計画の表示 (SQL query plan)
SQL 文の前に「EXPLAIN」を付ける.(Add 'EXPLAIN' before a SQL statement)
EXPLAIN SELECT zipcode, choiki_kanji FROM zips WHERE zipcode = 8190012;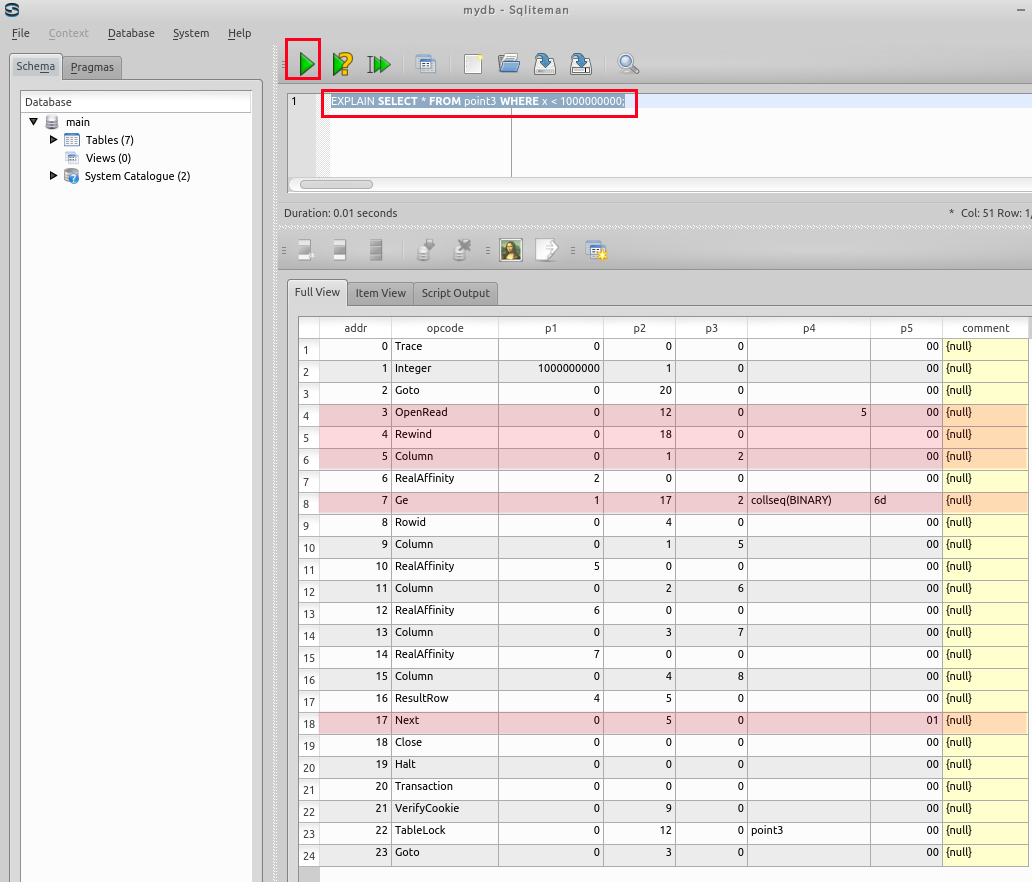
【表示された問い合わせ計画の要点】
アドレス (addr) オペコード 主なオペランド 1 Integer P1 = 8190012, P2 = 1 レジスタ1に,値8190012をセットする (store 8190012 into register #1) 2 OpenRead P2 = 7 ルート・ページが 7 であるようなテーブル(この場合はテーブル zips)のカーソルを作る (Open table 'zips' for read, and make a cursor) 3 Rewind P2 = 11 カーソルを,テーブルの先頭を指し示すようにする.テーブルが空の場合には,アドレス 11 にジャンプする (Use the first row. If the table is empty then jump to '11') 5 Column P2 = 1, P3 = 2 列番号1の値を,レジスタ 2 に格納する.(Save #1 column value into the register #2) 6 Ne P1 = 1, P2 = 10, P3 = 2 条件付きジャンプ. レジスタ 1 の値とレジスタ 2 の値が等しくないときに限り,アドレス 10 にジャンプする. (jump 10 if and only if register #1 is not equal to register #2) 7, 8 Column P2 = 1, 4, P3 = 4, 5 列番号1と4の値を,レジスタ 4 と 5 に格納する. 9 ResultRow P1 = 4, P2 = 2 レジスタ 4 からレジスタ 5 までの値(出力されるレジスタは2個)を1行として出力する (Generate output using registers) 10 Next P2 = 5 カーソルが指し示すレコードが末端レコードならば,次の命令に進む. 末端レコードでなければ,カーソルを1つ進めて,アドレス 5(「Column」のところ)にジャンプする. (Advance cursor to the next row. If there are more rows, then jump to the address '5') 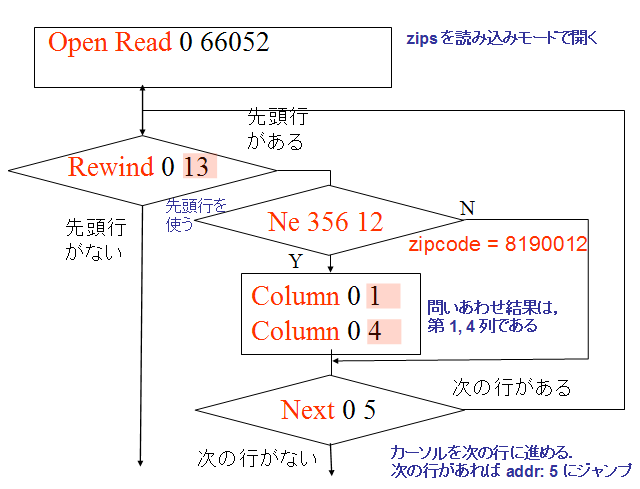
結合問い合わせの SQL 問い合わせ計画の表示例 (SQL query plan)
次は結合問い合わせ (join query) である.
- SQL の問い合わせの発行と評価結果の確認
評価には 10 秒以上かかる.結果が出るまで待つ.
select distinct R.choiki_kanji
FROM zips as R, zips as S
WHERE R.choiki_kanji = S.choiki_kanji
      AND R.jiscode <> S.jiscode;
- SQL 問い合わせ計画の表示 (SQL query plan)
SQL 文の前に「EXPLAIN」を付ける.(Add 'EXPLAIN' before a SQL statement)
EXPLAIN select distinct R.choiki_kanji
FROM zips as R, zips as S
WHERE R.choiki_kanji = S.choiki_kanji
      AND R.jiscode <> S.jiscode;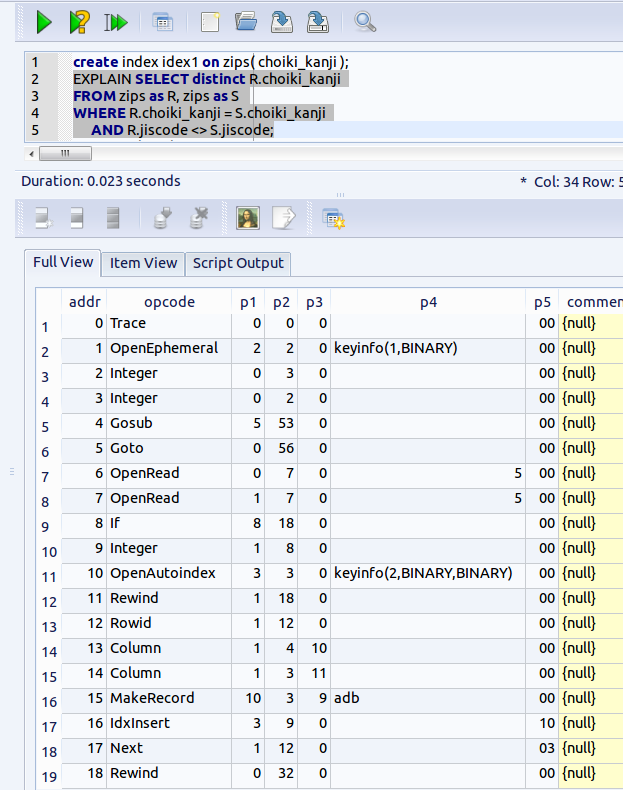
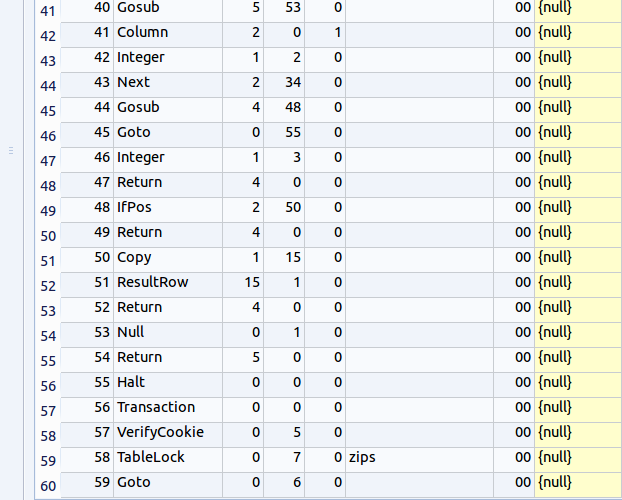
【表示された問い合わせ計画の要点】
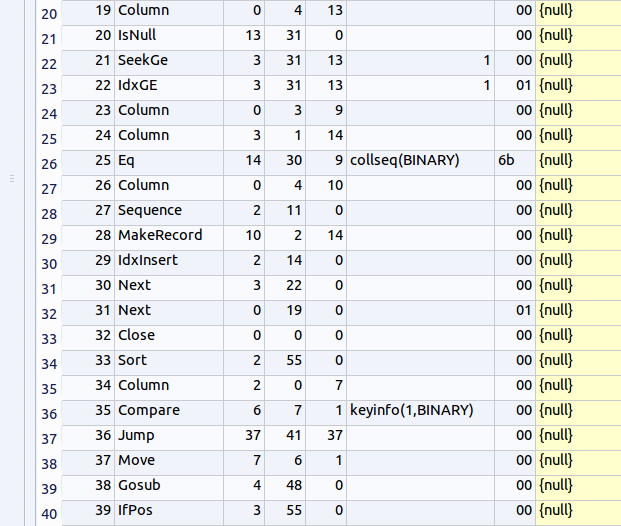
アドレス (addr) オペコード 主なオペランド 6 OpenRead P1 = 0, P2 = 7 ルート・ページが 7 であるようなテーブル(この場合はテーブル zips)のカーソルを作る.カーソル番号は 0 (Open table 'zips' for read, and make a cursor) 7 OpenRead P1 = 1, P2 = 7 ルート・ページが 7 であるようなテーブル(この場合はテーブル zips)のカーソルを作る.カーソル番号は 1 (Open table 'zips' for read, and make a cursor) 11 Rewind P1 = 1, P2 = 18 カーソル 1 を,テーブルの先頭を指し示すようにする.テーブルが空の場合には,アドレス 18 にジャンプする (Use the first row. If the table is empty then jump to '18') 12 Rowid P1 = 1, P2 = 12 カーソル 1 が指し示すレコードの主キーの値を,レジスタ12に格納する 13 Column P1 = 1, P2 = 4, P3 = 10 カーソル 1 が指し示すレコードの列番号4の値を,レジスタ 10 に格納する.(Save #4 column value into the register #10) 14 Column P1 = 1, P2 = 3, P3 = 11 カーソル 1 が指し示すレコードの列番号3の値を,レジスタ 11 に格納する.(Save #3 column value into the register #11) 15 MakeRecord P1 = 10, P2 = 3 レジスタ 10 からレジスタ 12 までの値からレコードを作る(次の IdxInsert で使う) 16 IdxInsert P1 = 3, P2 = 9 索引 3 に,前の MakeRecord 命令で作ったレコードを挿入する. * 「索引 3」は,アドレス 10 の「OpenAutoindex」で生成された索引である。この索引は,この SQL 問い合わせの評価のために一時的に生成された索引である。この「索引 3」により整列(ソート)が行われる. 17 Next P1 = 1, P2 = 12 カーソル 1 が指し示すレコードが末端レコードならば,次の命令に進む. 末端レコードでなければ,カーソルを1つ進めて,アドレス12 にジャンプする. (Advance cursor to the next row. If there are more rows, then jump to the address '12') 18 Rewind P1 = 0, P2 = 32 カーソル 0 を,テーブルの先頭を指し示すようにする.テーブルが空の場合には,アドレス 32 にジャンプする (Use the first row. If the table is empty then jump to '32') 19 Column P1 = 0, P2 = 4, P3 = 13 カーソル 0 が指し示すレコードの列番号4の値を,レジスタ 13 に格納する.(Save #4 column value into the register #13) 21 SeekGe P1 = 3, P2 = 31, P3 = 13, P4 = 1 カーソル 3 は「索引 3」を指し示している. カーソル 3 の位置を,レジスタ13に入っている検索キー以上の要素のうち最小の要素を指し示すように動かす.そのような要素がない場合には31にジャンプする. 22 IdxGe P1 = 3, P2 = 31, P3 = 13, P4 = 1 レジスタ13を検索キーとして使う. カーソル3が指し示す索引エントリと検索キーを比較する. 索引エントリが検索キー以上であれば31にジャンプする.さもなければ次に進む. 23 Column P1 = 0, P2 = 3, P3 = 9 カーソル 0 が指し示すレコードの列番号3の値を,レジスタ 9 に格納する.(Save #3 column value into the register #9) 24 Column P1 = 3, P2 = 1, P3 = 14 カーソル 3 が指し示すレコードの列番号1の値を,レジスタ 14 に格納する.(Save #1 column value into the register #14) 25 Eq P1 = 14, P2 = 30, P3 = 9 条件付きジャンプ. レジスタ 14 の値とレジスタ 9 の値が等しいときに限り,アドレス 30 にジャンプする. (jiscode が等しい組み合わせを除くため) 26 Column P1 = 0, P2 = 4, P3 = 10 カーソル 0 が指し示すレコードの列番号4の値を,レジスタ 10 に格納する. 28 MakeRecord P1 = 10, P2 = 2 レジスタ 10 からレジスタ 11 までの値からレコードを作る(次の IdxInsert で使う) 29 IdxInsert P1 = 2, P2 = 14 カーソル 2 が指し示す一時的なテーブルにレコードを挿入する.これは「DISTINCT」指定による重複除去のためである. * 「カーソル 2」は,最終結果の出力のために作られたカーソルで,アドレス 1 の「OpenEphemeral」命令で生成されている. 30 Next P1 = 3, P2 = 22 カーソル 3 が指し示すレコードが末端レコードならば,次の命令に進む. 末端レコードでなければ,カーソルを1つ進めて,アドレス22 にジャンプする. 31 Next P1 = 0, P2 = 19 カーソル 0 が指し示すレコードが末端レコードならば,次の命令に進む. 末端レコードでなければ,カーソルを1つ進めて,アドレス19 にジャンプする.
Sqliteman を用いた二次索引の追加 (generate a secondary index using Sqliteman)
テーブル zips の属性 choiki_kanji の二次索引を作る. (Generate a secondary index of the table 'zips')
- CREATE INDEX を用いた二次索引の生成 (Generate a secondary index using 'CREATE INDEX')
CREATE INDEX idx1 ON zips( choiki_kanji );「idx1」は索引名で,索引の管理(索引の削除など)に使用する. ('idx1' is index name).
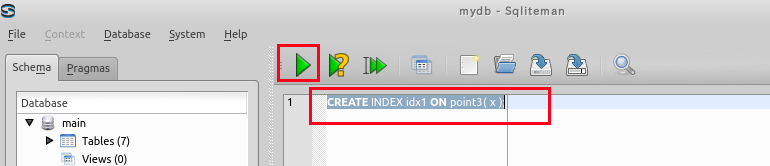
索引は数秒以内で生成される.(The secondary index will be generated in a several seconds)
- Sqliteman での二次索引の確認
idx1 ができている.
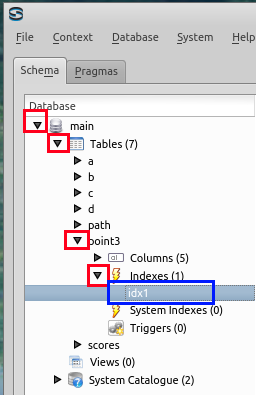
二次索引による問い合わせ計画の変化 (secondary index and query plan)
* データベースの構造の確認 (Database Structure)
sqlite_master をクリック (Click 'sqlite_master')

テーブルと二次索引のルート・ページ番号が分かる (Root page number of each table and secondary index)
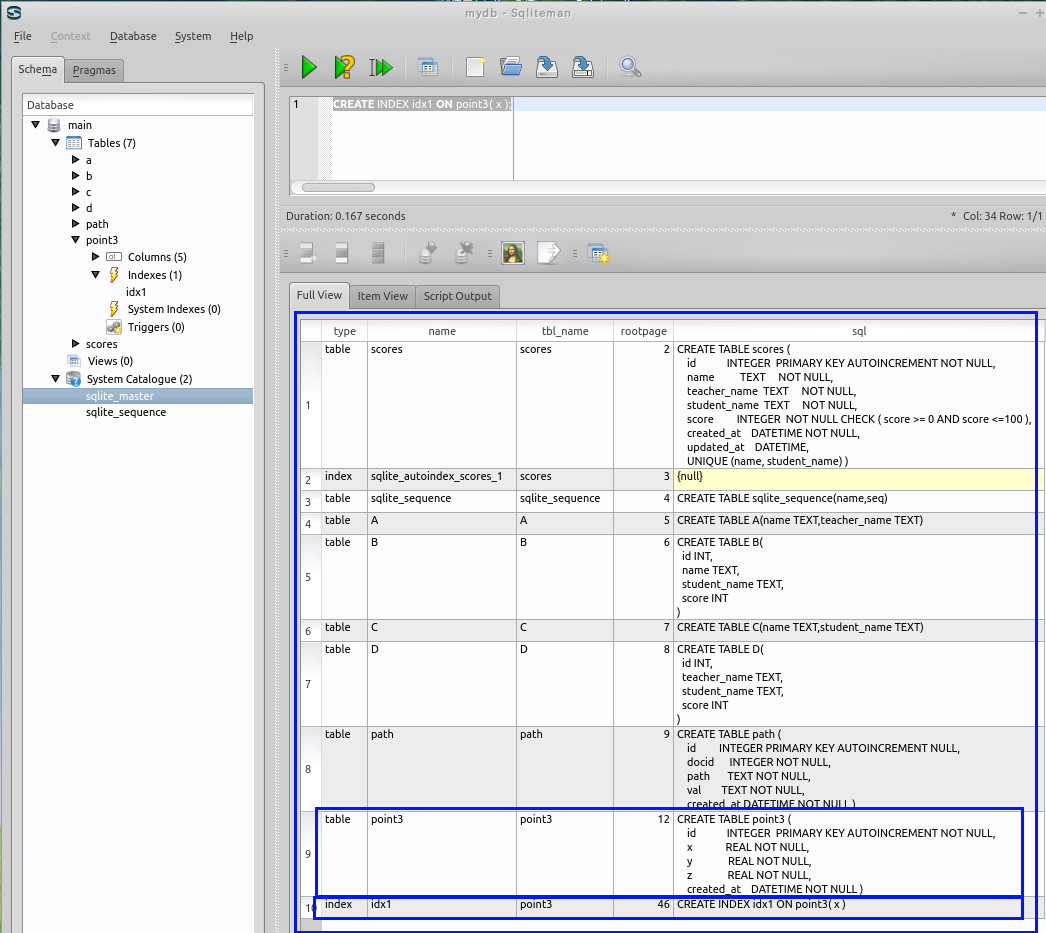
二次索引 idx1 のルート・ページ番号(ここでは「10357」)を確認する.ルート・ページ番号はデータベース管理システムが決める値なので,違う値になる.
(Inspect the root page number of the secondary index 'idx1'. The number is automatically decided by the database management system)
問い合わせ計画の表示 (query plan)
先ほどと同じ SQL 問い合わせを評価させる. 評価結果は同じであるが,評価にかかる時間は短くなる.
select distinct R.choiki_kanji
FROM zips as R, zips as S
WHERE R.choiki_kanji = S.choiki_kanji
      AND R.jiscode <> S.jiscode;

SQL 文の前に「EXPLAIN」を付ける.(Add 'EXPLAIN' before a SQL statement)
EXPLAIN select distinct R.choiki_kanji
FROM zips as R, zips as S
WHERE R.choiki_kanji = S.choiki_kanji
      AND R.jiscode <> S.jiscode;
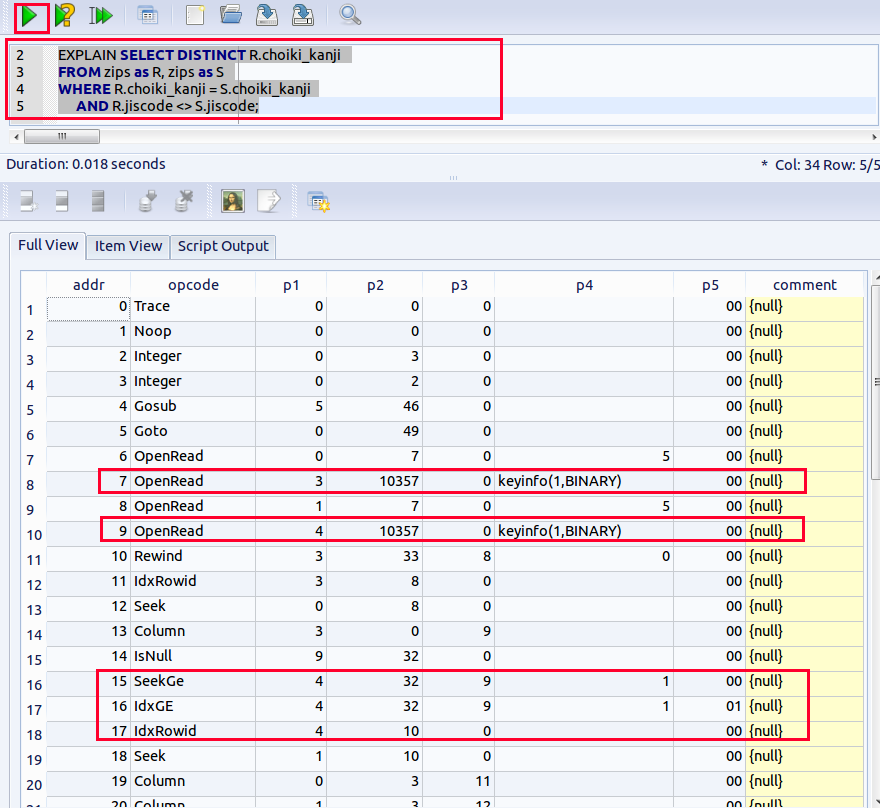
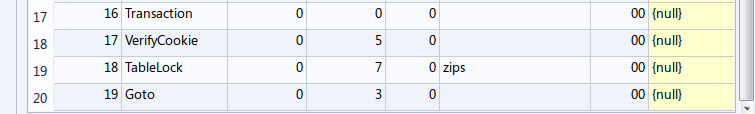
【問い合わせ計画の要点】
二次索引が使われるとき,結合の処理は二次索引の上で行われる. 一時的な索引の生成は行われない.
カーソルは,最初,二次索引 idx1 にセットされる. choiki_kanji の値を検索キーとして索引エントリを探し, 見つかった索引エントリを使って,テーブル本体のデータが取り出される.
- 二次索引のサイズは,テーブル本体のサイズよりずっと小さい (The size of secondary index is much smaller than the table)
- 二次索引は,高速な検索に向いたデータ構造である (Secondary index is fast access path)
演習問題
次の問いに答えよ. Answer the following questions.
問い (Questions)
- 次の PTABLE テーブルに関する問題 (About the following 'PTABLE' table)
name    |  type   |  color
------------------------------
apple   |  fruit  |  red
apple   |  fruit  |  blue
rose    |  flower |  white
rose    |  flower |  red
rose    |  flower |  yellow
このテーブルの行数は 1,000,000 行以上に増える予定である.(The number of rows of the table will be more than 1,000,000).
次の SQL を高速に処理するための二次索引を生成する SQL を書きなさい.二次索引の索引名は「idx3」にしなさい. (Write a SQL to generate a secondary index named 'idx3' that is used for the following SQL)
SELECT *
FROM PTABLE
WHERE name = 'apple'
- 次の PLACE テーブルに関する問題 (About the following 'PLACE' table)
name    |  x      |  y
------------------------------
tenji   |  101    |  104
hakata  |  180    |  125
nishijin|  45     |  108
このテーブルの行数は 1,000,000 行以上に増える予定である.(The number of rows of the table will be more than 1,000,000).
次の SQL を高速に処理するための二次索引を,下記の中から選びなさい. (Choose a SQL that generates a secondary index used for the following SQL)
SELECT *
FROM PLACE
WHERE x > 80 AND x < 120 AND y > 90 AND y < 110
- CREATE INDEX idx4 ON PLACE( x, y );
- CREATE INDEX idx4 ON PLACE( name, x );
- CREATE INDEX idx4 ON PLACE( name, y );
- 次のテーブルに関する問題 (About the following table)
create table R (
  id  integer primary key,
  val integer,
  note text );
テーブル R の属性 val に対する二次索引を生成した場合,どのような処理が遅くなるか. (What kinds of database processing become slower when a secondary index on 'val' of the table 'R' is generated).
- 下記を行いなさい (Do the followings)
- SQLite を使い,下記のテーブルを定義しなさい (Define the table below using SQL)
FF (id, name, price) - FF の属性 name に二次索引を作りなさい (Generate a secondary index on 'name' of 'FF')
- SQLite を使い,下記のテーブルを定義しなさい (Define the table below using SQL)
解答例 (Answers)
- CREATE INDEX idx3 ON PTABLE( name );
- CREATE INDEX idx4 ON PLACE( x, y );
- テーブル R への行の挿入や削除が遅くなる (Insertion of rows into R. Deletion of rows from R).
-
create table FF (
  id  integer primary key,
  name text,
  price integer );
CREATE INDEX idx5 ON FF( name );