Apache Spark のインストールとテスト実行(ソースコードからのビルド,Ubuntu 上)
前準備
Ubuntu のシステム更新
Ubuntu で OS のシステム更新を行うときは,端末で,次のコマンドを実行する。パッケージ情報を最新にし,インストール済みのパッケージを更新するためである。
# パッケージリストの情報を更新
sudo apt update
# インストール済みのパッケージを更新 (依存関係も考慮)
sudo apt full-upgrade
# カーネル更新等で再起動が必要な場合のみ実行
# sudo shutdown -r now
Git のインストール
端末で,次のコマンドを実行する.
# パッケージリストの情報を更新
sudo apt update
sudo apt -y install git
前準備として JDK のインストール
Apache Spark 4 系のビルドと実行には Java 17, 21, 25 のいずれかが必要である。
JDK のインストールと設定(Ubuntu 上): 別ページ »で説明
Apache Spark のインストールとテスト実行(Ubuntu 上)
次のURL に記載の手順でインストールを行う.
- インストール操作
build/mvn は,ビルドに必要な Maven と Scala を自動でダウンロードして使用する。そのため,Maven を別途インストールする必要はない。MAVEN_OPTS はビルド時のメモリ量の設定である。
端末で,次のコマンドを実行する.
export SROOT=/var/tmp cd $SROOT git clone --depth 1 https://github.com/apache/spark cd spark export MAVEN_OPTS="-Xss64m -Xmx4g -Xms4g -XX:ReservedCodeCacheSize=128m" ./build/mvn -DskipTests clean package - 終了の確認
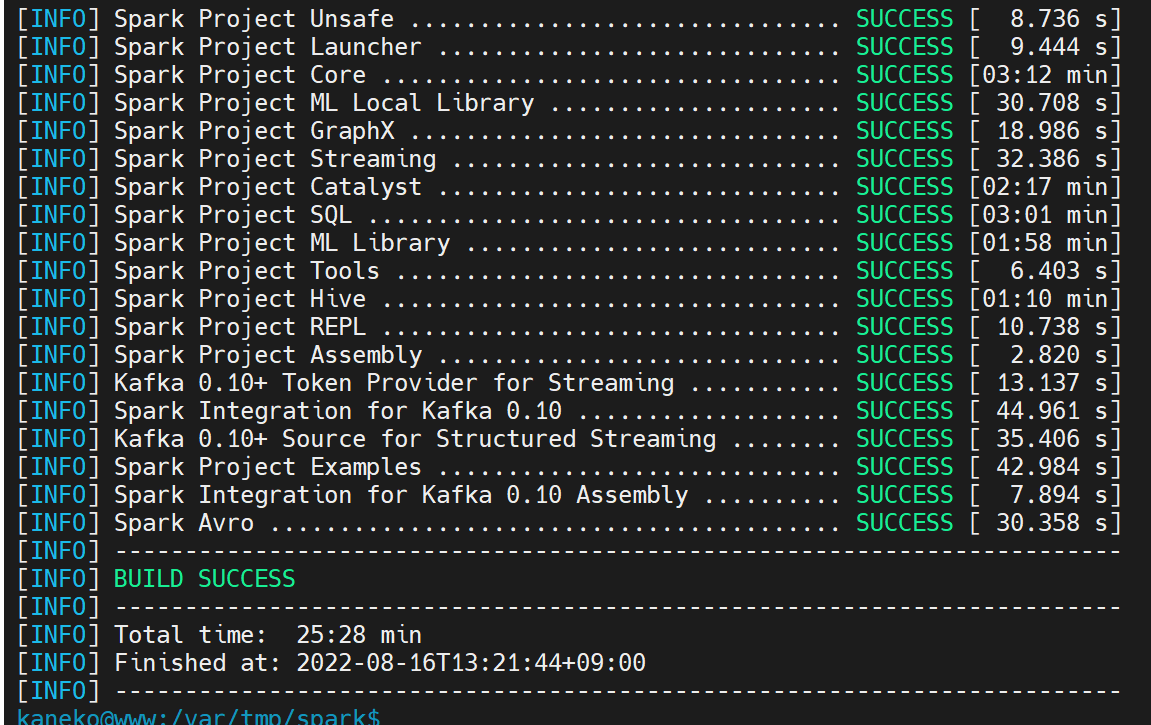
- 確認のため,Apache Spark の Python シェルを起動し,簡単なプログラムを動かしてみる.
spark は,Python シェルの起動時に自動で作られる SparkSession である。
./bin/pyspark
spark.range(1000 * 1000 * 1000).count()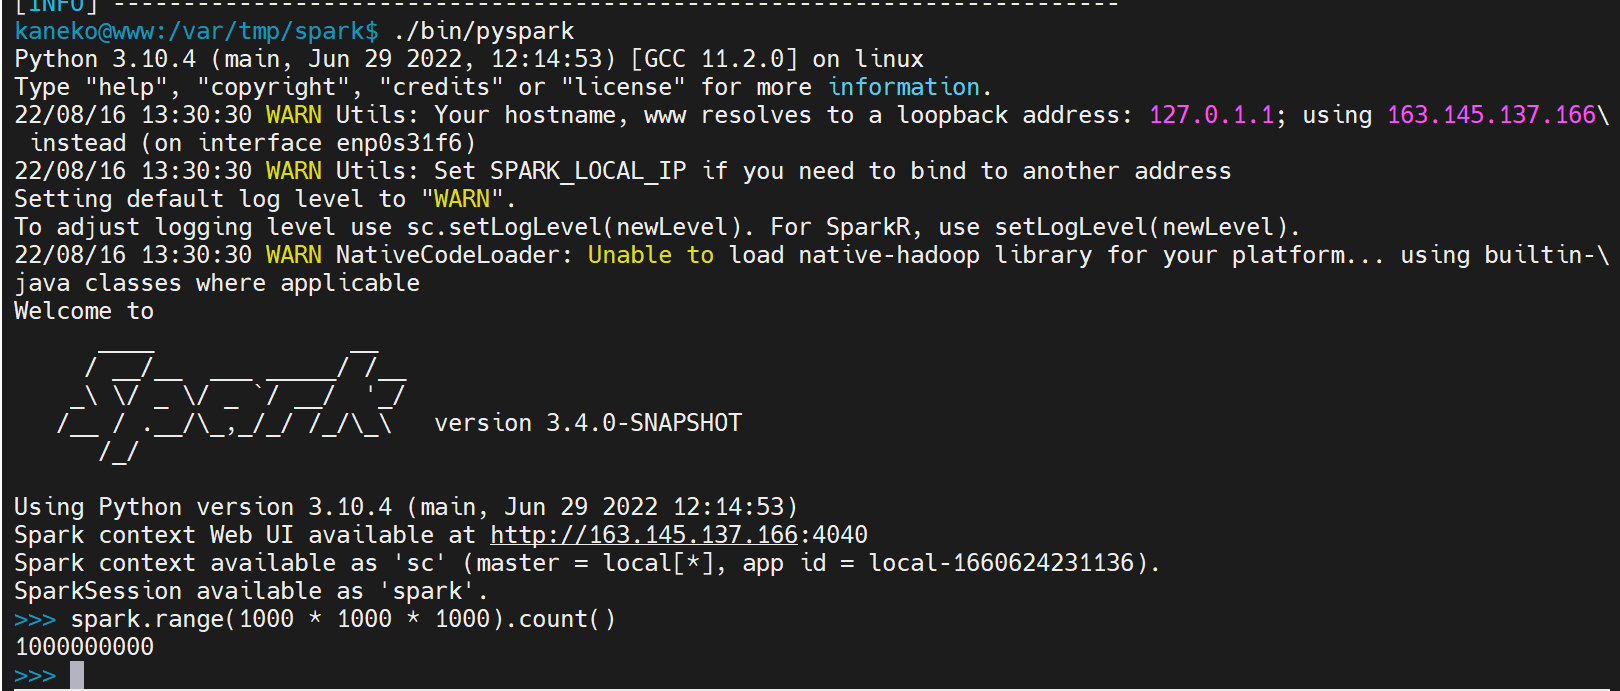
SQL の実行例
CSV ファイル /tmp/w.csv を読み込み,一時ビュー weather として登録し,SQL を実行する例である。inferSchema は,データからデータ型を推定するオプションである。
端末で,次のコマンドを実行する.
./bin/pyspark

df = spark.read.csv("/tmp/w.csv", header=False, inferSchema=True)
df.createOrReplaceTempView("weather")
r = spark.sql("select * from weather")
r.show()
r.printSchema()