
暗い動画を明るく鮮明にする
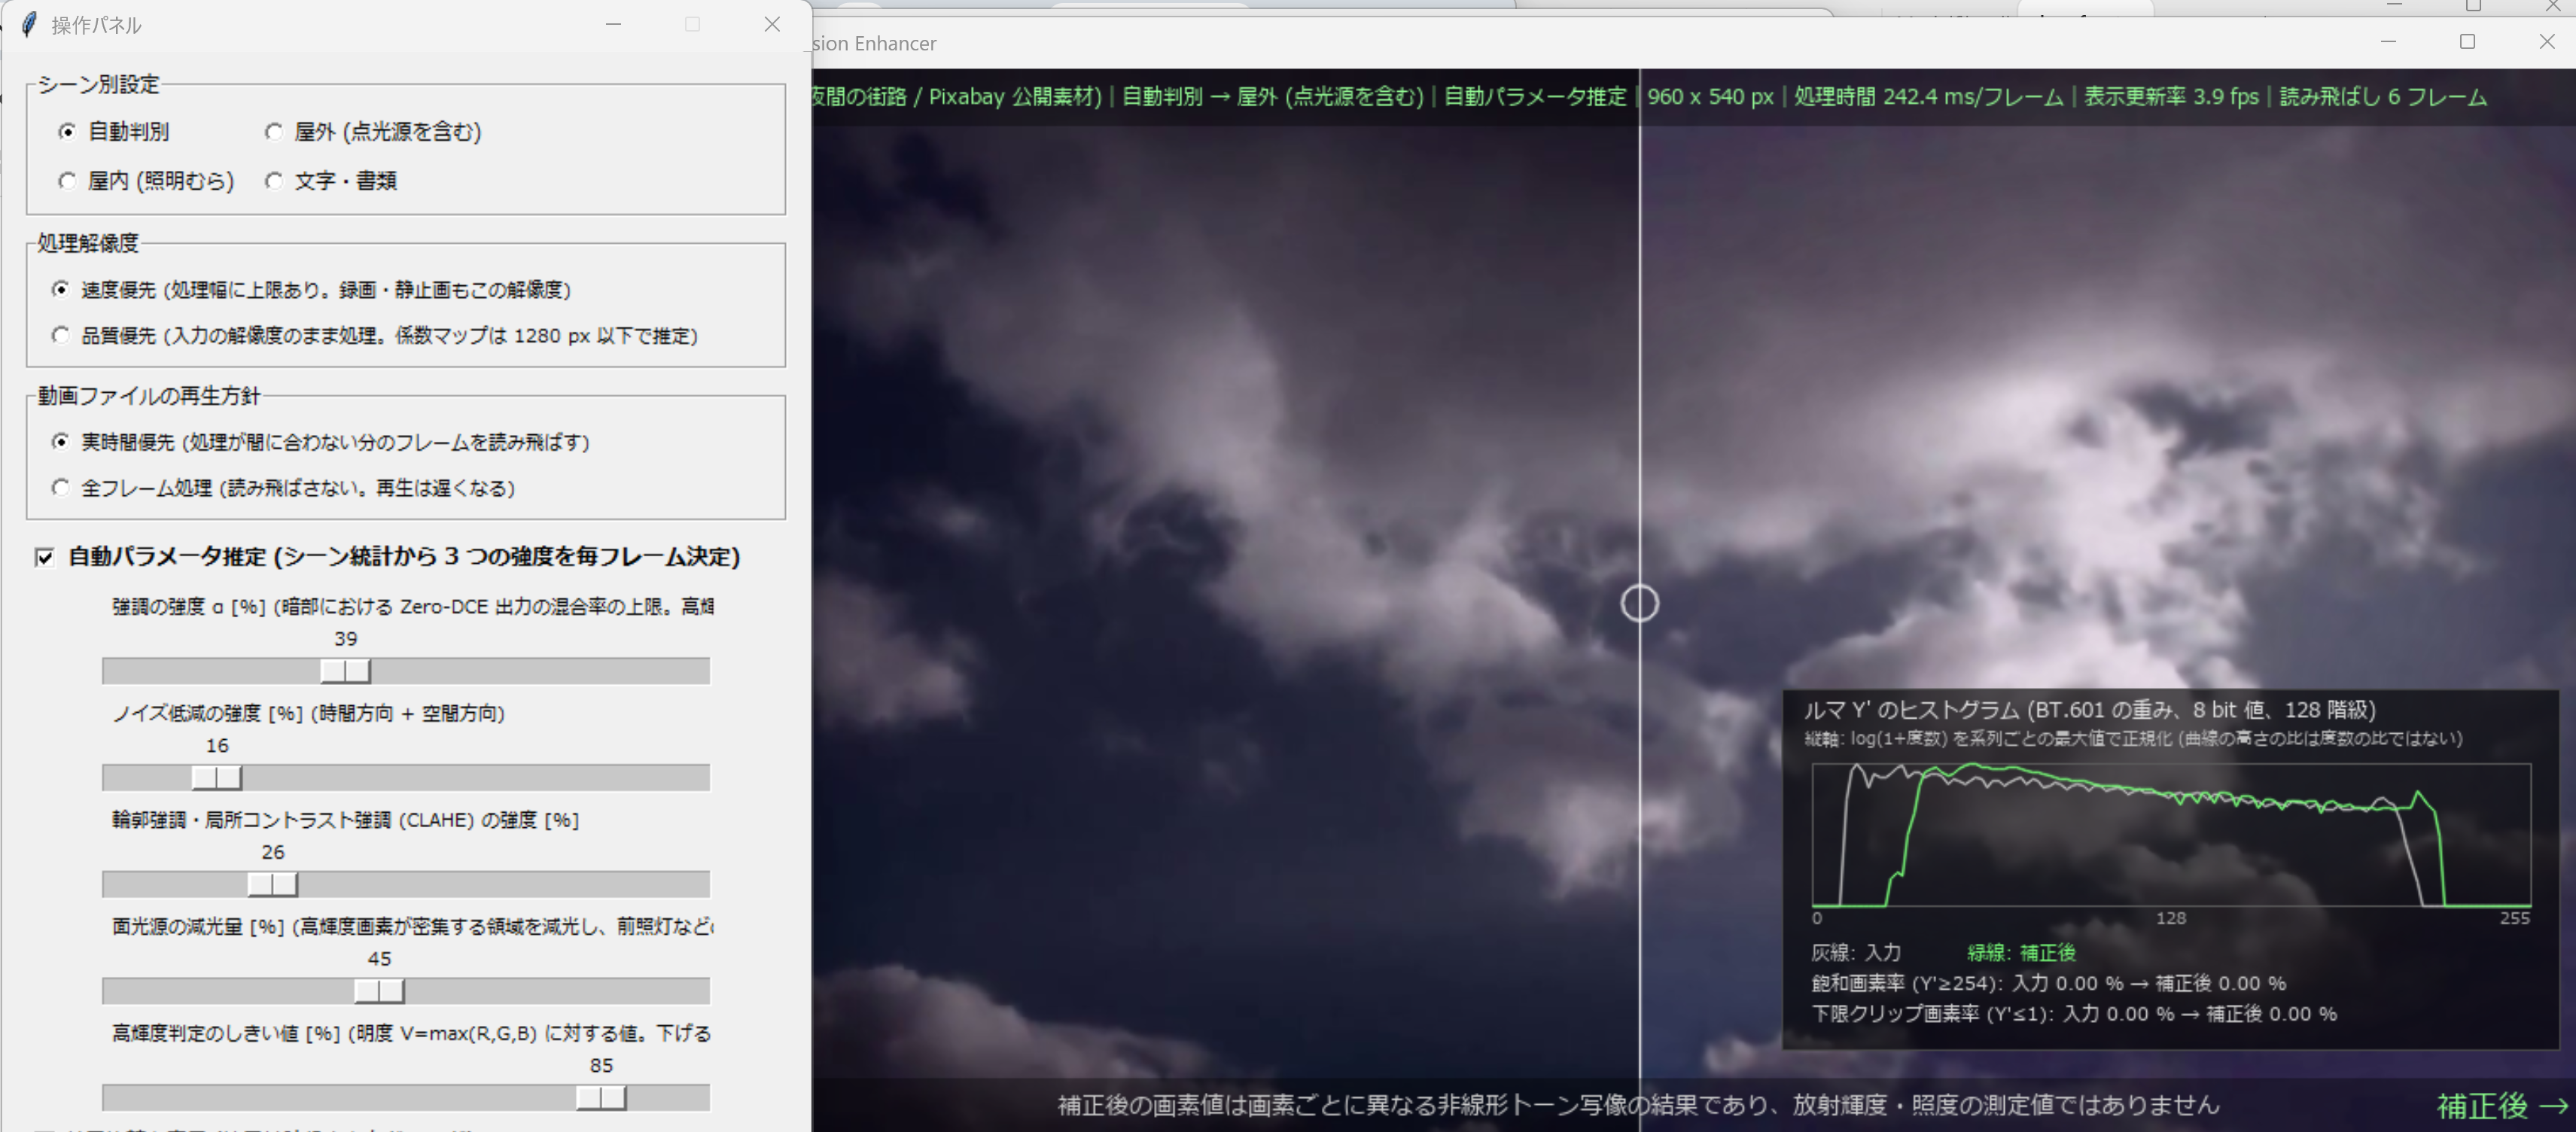
プログラムの動作の様子の動画:[動画]
実行ファイル:[exe]
実行ファイル(exe)は、Chrome または Firefox を用いてダウンロードすることを推奨。初回実行時に、SmartScreenの「WindowsによってPCが保護されました」の警告画面が出ます。警告画面で「詳細情報」をクリック、「実行」をクリックで続行できます。
説明資料: [PDF], [PPTX] , [動画](クリックして再生開始), クレジット:動画は「VOICEVOX:青山龍星」、「Vrew」、「Gemini」を用いて作成
本資料とコードの作成にAIを使用。
このプログラムの目的
本プログラムは、夜間や照明の乏しい環境で撮影された映像の暗部を、学習済みのニューラルネットワーク(AIモデル)と画像処理の組み合わせで、視認しやすい明るさに変換する。入力はカメラ映像、動画ファイル、デモ映像(Pixabayで公開されている夜間の街路映像)の3種類である。CPUだけの環境でも動作し、CUDA対応GPUがあれば自動で使用する。
暗い映像の明るさを一律に上げると、明るい部分の飽和(白飛び)とノイズの増幅が起こる。本プログラムは、画素ごとに異なる強さで暗部を明るくし、明るい部分を保ちながらノイズ低減と輪郭強調を行う。補正後の映像は画面で入力と比べながら確認でき、静止画や録画として保存できる。動画ファイルは、元の解像度と全フレームを保って書き出すこともできる(元解像度での書き出し)。
用語
- ルマ Y′:ガンマ符号化されたR、G、Bの加重和(BT.601の重み 0.299、0.587、0.114)。8ビット値(0〜255)で表す。光の物理量である輝度とは異なる。
- 明度 V:画素のR、G、Bの最大値。
- 飽和画素率:Y′≥254 の画素の割合。下限クリップ画素率:Y′≤1 の画素の割合。どちらも、入力より増えた分が、補正によって失われた階調を表す。
- ポイント:百分率どうしの差。例えば1.0%から1.2%への増加は0.2ポイントである。
- 処理解像度:補正処理を行う画像の解像度。その幅を処理幅と呼ぶ。
画面構成
起動すると、入力の選択画面が開く。入力の選択画面を閉じると、プログラムは終了する。入力を選ぶと、3つのタブからなるメイン画面が開く。
- 映像・操作:左に映像、右に操作パネルを表示する。映像の上端には、入力の名前、適用中のシーン種別、処理解像度、1フレームあたりの処理時間、表示更新率を表示し、下端には測定に使えない旨の注意書きを常時表示する。
- 中間結果:各処理段階の画像(入力、時間方向ノイズ低減後、AI強調後、混合後、照明・色補正後、面光源減光後、最終出力)と、混合率マップ、照明ゲインマップ、面光源マップ、および算出過程の数値を表示する。表示中の画像を保存できる。
- ヘルプ:操作手順、使用技術、使用中のAIモデルと演算装置、ライセンス、結果の限界を表示する。
処理解像度
操作パネルで次の2つから選ぶ。
- 速度優先(初期値):処理幅に上限を設ける(GPU使用時は1280画素、CPU使用時は960画素)。入力の幅がこの上限を超える場合は縮小するため、画面表示、録画、静止画もこの処理解像度になる。縮小で失われた細部は、輪郭強調では復元できない。
- 品質優先:入力の解像度のまま処理する。実時間性は保証しない。
標識、ナンバープレート、書類の文字を読み取ることが目的の場合は、品質優先か、元解像度での書き出しを用いる。
AIモデル
操作パネルで次の2つから選ぶ。初期値はZero-DCEである。重みは初回の使用時に自動で取得する。読み込みの前に毎回SHA-256を既知の値と照合し、一致しない場合は削除して1回だけ取得し直す。それでも一致しなければ、その重みは使用しない。読み込みには、任意のコード実行を伴う逆直列化を禁じる weights_only=True を指定する。
- Zero-DCE(Guo et al.、CVPR 2020):正解画像を必要としない損失で学習された軽量なCNNである。7層の3×3畳み込みが、画素ごとに24個(8反復×RGB)のカーブ係数 r(−1〜1)を推定し、LE(x) = x + r(x2 − x)(x は0〜1に正規化した画素値)を8回反復する。0≤x≤1 では x2 − x ≤ 0 であるため、r が負の画素では値が上がる。推論が高速で、実時間処理に向く。重みは公式リポジトリ Li-Chongyi/Zero-DCE の Epoch99.pth(320,017バイト)である。
- Retinexformer(Cai et al.、ICCV 2023):照明マップを推定し、照明の特徴量で重み付けた注意機構を持つU-Netで画像を復元する。夜間動画データセットSDSD(屋外)で、正解画像との対を用いて学習された公式の重みを使う。演算量が大きく、実時間性は保証しない。
Zero-DCEの学習に用いた損失には、16×16画素の領域の平均を0.6へ近づける項(露出制御損失)と、R、G、Bの平均値の差を抑える項(色恒常性損失)が含まれる。このため、Zero-DCEの出力には次の性質がある。
- 点光源の付近まで明るくして、飽和させることがある。
- 露出と色はAIモデルの中で補正済みであり、後段で同じ向きの補正を重ねると二重補正になる。
- r がR、G、Bごとに独立であるため、暗部で色の偏りが生じることがある。
Zero-DCEのカーブ係数の分布(係数マップ)は空間的に滑らかである。そこで、推論だけを縮小画像で行い、得られた係数マップを双線形補間で処理解像度へ拡大してから適用する。係数マップは時定数0.08秒で時間方向に平滑化し、明るさのちらつきを抑える。
推論を行う画像の幅(推論幅)は、両AIモデルとも次のように決める。
- 速度優先:起動時に推論時間を実測し、1回の推論が一定の時間に収まる推論幅で推論する。Retinexformerでは、この推論幅で得たAIモデルの出力を処理解像度へ拡大する。最小の推論幅(160画素)でも一定の時間に収まらない計算機に限り、推論を最大3フレームに1回まで間引く。
- 品質優先:Zero-DCEは推論幅を1280画素以下とし、Retinexformerは処理解像度のまま推論する。
どちらの場合も、推論幅を空きメモリ(GPU使用時はGPUの空きメモリ、CPU使用時は空き物理メモリ)で制限する。それでもメモリの確保に失敗した場合は、推論幅を半分にして再試行する。
処理の流れ
処理の強さは、次の3つの強度(各0〜100%)で決まる。
- 強調の強度 α:暗部を明るくする強さ。
- ノイズ低減の強度:時間方向ノイズ低減と空間方向ノイズ低減の強さ。
- 輪郭・局所コントラスト強調の強度:局所コントラスト強調と輪郭強調の強さ。
3つの強度の決め方は2つある。シーン解析の結果から毎フレーム自動で決める方法(自動パラメータ推定)と、利用者がスライダで指定する方法(手動設定)である。また、各処理の定数は、シーン種別(屋外、屋内、文字・書類)ごとに異なる。
1フレームの処理は、次の順序で行われる。
- 寸法調整:処理解像度の設定に応じて縮小する。動画の符号化が偶数の寸法を必要とするため、縦横を偶数にする。
- シーン解析:次の量を求め、3つの強度の推奨値とシーン種別を決める。
- 推定ノイズ標準偏差 σ:画素値を0〜1に正規化した単位で表す。ノイズに強く反応する3×3のフィルタ(Immerkærのマスク)の応答の絶対値の中央値から推定する。
- 暗部指標:平均ルマとルマの90パーセンタイルから求める0〜1の量で、1に近いほど暗い。
- エッジ密度:輪郭として検出された画素の割合。
- 時間方向ノイズ低減:静止している画素を、過去のフレームと平均する(再帰型)。動きと判定された画素は平均しない。動きと判定された画素が画面に占める割合を、動き領域の面積比と呼ぶ。動きの判定しきい値は σ に比例させるため、ノイズの多い暗部でも、静止している画素を動きと誤判定しにくい。暗部を明るくしてノイズが大きくなる前に行う。
- AIモデルによる暗部の伸張:Zero-DCEでは、まずAIモデルの出力と次の画像を、シーン種別ごとに決めた割合で混合する(色度の引き戻し)。混合する画像は、入力の全チャネルに「AIモデルの出力のルマ/入力のルマ」を掛けたもので、入力の色を保ったまま明るさだけをAIモデルの出力に合わせた画像である。これにより、色の偏りを抑える。
次に、AIモデルの出力と入力を、画素ごとの混合率で混合する。混合率は、近傍で平滑化した明度 V が0のとき α で、明度 V が高くなるほど滑らかに下がり、シーン種別ごとに決めた明度で0になる。明るい画素には入力が残るため、α を上げても街灯や前照灯が飽和しにくい。 - 照明補正とホワイトバランス:照明成分を、明度 V を平滑化した値で近似する。補正後の照明成分の平均が、シーン種別ごとに決めた目標値に一致するガンマ値を求めて、照明のゲインとする。照明のゲインは1以上で、明るい領域ほど小さくする。照明成分の平均がすでに目標値以上なら、照明補正は行わない。ホワイトバランスは、各チャネルの98パーセンタイルを白の基準とし、0.85〜1.20倍の範囲で補正する。
- 面光源の減光:明度 V が高輝度判定のしきい値を超える画素を、高輝度画素とする。高輝度画素が近傍に占める割合(近傍占有率)を求め、近傍占有率の高い領域の高輝度画素だけを減光する。対向車の前照灯の発光面のように面積を持つ光源は減光され、周囲が暗い孤立した点光源は減光されにくい。面光源の減光量は α によらない。
- 仕上げ(YCrCb空間):次の処理を順に行う。動き領域の面積比が大きいほど、最初の2つ(空間方向ノイズ低減)を強める。動きと判定された画素では、時間方向ノイズ低減が効かないためである。
- ルマをバイラテラルフィルタ(輪郭を保つ平滑化)で処理する。
- 色差を1/2に縮小して平滑化し、元の寸法に戻す。暗部を明るくしたことで目立つ色ノイズを抑えるためである。
- 局所コントラスト強調(CLAHE):画像を8×8のタイルに分け、タイルごとにヒストグラムを平坦化する。強調の上限は、CLAHEのクリップ値で抑える。
- 輪郭強調(コアリング付きアンシャープマスク):振幅の小さい成分(主に残留ノイズ)を除いてから、輪郭を強調する。
- 片側トーンカーブ:ルマが127.5(0〜255の中央)以下の画素は変えず、それより明るい側を持ち上げて、白付近を圧縮する。
- 彩度を上げる。
α が2%未満のときは、手順4〜6を行わない。3つの強度がいずれも2%未満のときは、処理を行わずに入力をそのまま補正後の映像とする。
シーン別設定
操作パネルで、シーン種別の決め方を次の4つから選ぶ。
- 自動判別(初期値):孤立した高輝度画素の有無(ルマの99パーセンタイルと90パーセンタイルの差)と、ルマの範囲(99パーセンタイルと1パーセンタイルの差)から、屋外らしさを求める。屋外らしさが上のしきい値を超えると屋外、下のしきい値を下回ると屋内と判定し、その間では直前の判定を保つ。これにより、判定が頻繁に切り替わるのを防ぐ。「文字・書類」は自動判別では選ばれない。
- 屋外(点光源を含む):混合率が0になる明度を0.50と3つのシーン種別の中で最も低く取り、点光源を保つ。Zero-DCEとの二重補正を避けるため、ホワイトバランスは適用しない。面光源の減光を3つのシーン種別の中で最も強く効かせる。
- 屋内(照明むら):照明成分を推定する範囲を屋外より狭くして、照明むらを補正する。照明の色かぶりを補正するため、ホワイトバランスを適用する。
- 文字・書類:局所コントラスト強調と輪郭強調を3つのシーン種別の中で最も強くし、ノイズ低減の強度に下限(α の0.45倍)を設ける。色の再現を重視しないため、色度の引き戻しの割合を3つのシーン種別の中で最も大きくし、彩度は上げない。面光源の減光は行わない。
撮影環境が分かっている場合は、該当するシーン種別を選ぶ。
自動パラメータ推定
シーン解析で得た3つの強度の推奨値を、時間方向に平滑化して用いる。明るくノイズも少ない映像では、推奨値は0に近づく。
暗部指標だけから α を決めると、全体が暗い夜間映像では α が上限に張り付き、飽和が増える。そこで、補正後の飽和画素率を入力と比べ、増分が0.2ポイントを超えている間は、α の推奨値に掛ける強度補正係数を段階的に下げる(下限0.35)。増分が0.05ポイント未満になると、少しずつ1へ戻す。
3つの強度のスライダのいずれかを操作した時点で、手動設定へ切り替わる。
ヒストグラムの読み方
入力(灰線)と補正後(緑線)のルマを128区間で数える。縦軸は log(1+度数) を系列ごとの最大値で正規化して重ね描きするため、曲線の高さの比は度数の比を表さない。あわせて、飽和画素率と下限クリップ画素率を、入力と補正後の両方について表示する。
評価用の低照度シミュレーション
明るい素材から、低照度で撮影した場合と同じ種類の劣化を作り、効果を確認するための機能である。入力をsRGBの伝達関数の逆変換で線形化し、露光量を0.12倍にする。そこに、ポアソン分布に従う光ショットノイズ(線形信号1.0を光電子8000個とする)と、標準偏差6×10⁻⁴の正規分布の読み出しノイズを、チャネルごとに独立に加え、再びsRGBで符号化する。特定の撮像素子の較正値ではない。有効にすると、劣化させた画像が処理の入力になり、並置比較の左側にも表示される。
元解像度での書き出し
動画ファイルを入力にしているときだけ使える。入力の解像度と元のフレームレートを保ち、全フレームを処理してMP4を書き出す。推論幅は品質優先と同じである。シーン別設定、面光源の減光量、高輝度判定のしきい値には、開始時点の操作パネルの値を用いる。処理は3段階で行う。
- 統計の収集と強度の決定:ファイル全体から一定間隔で約120フレームの統計を集める。シーン別設定が「自動判別」のときは、シーン種別をこの統計から決める。自動パラメータ推定のときは3つの強度に推奨値の中央値を、手動設定のときは操作パネルの値を用いる。3つの強度はファイル全体で固定されるため、強度の時間変化によるちらつきは生じない。
- 飽和画素率の確認:再生時間の1/4、1/2、3/4の位置のフレームで、補正後の飽和画素率を実測する。自動パラメータ推定のときは、入力からの増分が0.2ポイントを超えていれば、α を10%ずつ下げる(最大4回、下限20%)。手動設定のときは実測だけを行い、値は変えない。
- 本処理:時間方向ノイズ低減には、前後1フレームを動きに応じた重みで平均する方式(双方向型)を用いる。双方向型は、再帰型より残像が出にくい。
開始前に、先頭フレームで1フレームあたりの処理時間を実測し、出力解像度、フレーム数、強度の決め方、本処理の所要時間の目安を示して確認を求める。全フレームを処理するため、所要時間は再生時間より長くなる。元解像度での書き出しの間は進捗と残り時間が表示され、画面表示は更新されない。本処理の途中で中止した場合も、そこまでの内容が保存される。
操作パネル
自動パラメータ推定が有効な間は、3つの強度のスライダに推奨値が書き戻される。このため、3つの強度の初期値は、起動直後に推奨値で置き換わる。
- シーン別設定:自動判別、屋外、屋内、文字・書類から選ぶ。
- AIモデル:Zero-DCEとRetinexformerを切り替える。重みがなければ取得する。
- 処理解像度:速度優先と品質優先を切り替える。切り替えると録画は確定され、処理の内部状態は初期化される。
- 動画ファイルの再生方針:「実時間優先」(初期値)では、処理が追いつかない分のフレームを読み飛ばして再生速度を保ち、読み飛ばしたフレーム数の累計を映像の上端に表示する。「全フレーム処理」ではフレームを読み飛ばさないため、処理が追いつかない計算機では低速再生になる。録画中は、記録が欠けないよう、再生方針にかかわらずフレームを読み飛ばさない。どちらの再生方針でも、元の再生速度より速くは再生しない。
- 自動パラメータ推定(初期値:有効)。
- 強調の強度 α(初期値60%):暗部でのAIモデルの出力の混合率の上限である。照明補正、ホワイトバランス、片側トーンカーブ、彩度、CLAHEのクリップ値にも掛かる。面光源の減光量には掛からない。
- ノイズ低減の強度(初期値40%):上げるほどノイズは減るが、細部がぼやける。
- 輪郭・局所コントラスト強調の強度(初期値50%):上げるほど、文字や輪郭が明瞭になる。
- 面光源の減光量(初期値45%):0で面光源の減光を行わない。実際の面光源の減光量は、この値にシーン種別ごとの倍率を掛けたものである。
- 高輝度判定のしきい値(初期値85%):明度 V がこの値を超える画素を、高輝度画素とする。下げると検出範囲が広がるが、明るい雲や白い壁の誤検出も増える。映像を見ながら決める。
- 比較境界の位置(初期値50%):並置比較で、左に入力を表示する幅の割合。映像上の左ドラッグでも動かせる。
- 表示の切り替え:並置比較(初期値:有効。左に入力、右に補正後の映像)、ヒストグラム(初期値:有効)、低照度シミュレーション(初期値:無効)、一時停止(初期値:無効)。一時停止中も3つの強度の変更は反映される。
- ボタン:静止画の保存、録画の開始・停止、元解像度での書き出し、入力の切り替え(入力の選択画面を開く)、全画面、終了。
- 状態表示:推定ノイズ標準偏差 σ、暗部指標、強度補正係数、動き領域の面積比、処理解像度(画面では「出力解像度」と表示)、1フレームあたりの処理時間、表示更新率。操作パネルの下部には、各数値の定義を表示する。
キー操作
メイン画面で使える。大文字と小文字は区別しない。
- SPACE:並置比較の切り替え
- P:一時停止の切り替え
- G:ヒストグラムの切り替え
- L:低照度シミュレーションの切り替え
- S:静止画の保存
- R:録画の開始・停止
- I:入力の切り替え
- F11:全画面の切り替え
- Q または ESC:終了
保存されるファイル
保存先は、スクリプト(exe化した場合はexe)と同じフォルダである。ファイル名には、保存時刻がミリ秒まで入る。静止画と録画の解像度は、処理解像度である。
- 静止画:
view_YYYYMMDD_HHMMSS_mmm.png。補正後の映像(並置比較が有効なときは、境界線付きの並置比較の画像)を保存する。文字の重ね表示とヒストグラムは含まれない。 - 録画:
enhanced_YYYYMMDD_HHMMSS_mmm.mp4。補正後の映像だけを記録する。フレームレートは、動画ファイル入力では元のフレームレート、カメラ入力では録画開始時点の直近30フレームの取得間隔から求めた値(5〜60fpsの範囲に制限)とする。同じ名前の_frames.csvに、各フレームの取得時刻を記録し、カメラ入力ではカメラ側の通し番号から求めた欠番も記録する。 - 元解像度での書き出し:
export_YYYYMMDD_HHMMSS_mmm.mp4。 - 中間結果の画像:
stage_YYYYMMDD_HHMMSS_mmm.png。
動画の符号化は、H.264(avc1)を先に試し、使えない場合はMPEG-4 Part 2(mp4v)を用いる。pipで導入したOpenCVはH.264の符号化器を含まないことが多く、その場合はMPEG-4 Part 2になる。実際に用いた符号化の方式は、画面に表示される。音声は記録されない。
既知の制限
- 速度優先の画面表示と元解像度での書き出しで、見え方が一致しないことがある:空間方向ノイズ低減と輪郭強調は、処理解像度によらず同じ画素数の範囲で処理する。ノイズは画素単位の現象だからである。一方、照明成分の推定、混合率、動きの判定、面光源の検出、CLAHEのタイル分割は、範囲を処理幅に比例させる。このため、入力の幅が速度優先の処理幅の上限を超える場合、元解像度での書き出しの結果は、速度優先の画面表示より、輪郭強調と空間方向ノイズ低減が穏やかに見える。
- 画面全体が動く映像では、時間方向ノイズ低減がほとんど効かない:走行中の車載映像などが該当する。代わりに空間方向ノイズ低減を強めるため、細部がぼやける。元解像度での書き出しでは、双方向型を用いるため影響が小さい。
- Retinexformerを速度優先で使うと、細部がなめらかになる:処理解像度より小さい推論幅で得たAIモデルの出力を拡大するためである。また、Zero-DCEと異なり時間方向の平滑化を行わないため、場面が急変すると明るさが瞬時に変わる。
- 面光源の減光は画素値を下げる処理である:撮影時に生じたブルーミングやフレアは除去できない。大きく写った街灯や密集した光源は、面光源として減光されることがある。その場合は、面光源の減光量か高輝度判定のしきい値を調整する。
- 測定には使えない:補正後の画素値は、画素ごとに異なる非線形トーン写像の結果であり、放射輝度や照度の測定値ではない。明るさの定量的な比較や測光には使用できない。
実行上の注意
- ネットワーク接続が必要になるのは、AIモデルの重みの初回取得と、デモ映像の初回取得である。2回目以降は取得済みのファイルを使う。取得に失敗した場合は、再試行するか取りやめるかを選べる。
exeファイルの作成手順
cd /d c:\users\user\proj\night_vision_enhancer
python -m venv venv
venv\Scripts\activate.bat
python -m pip install --upgrade pip
pip install -U --no-user pyinstaller pytest numpy torch opencv-python pillow
pyinstaller --onefile --clean --noconfirm  --collect-all numpy --collect-all torch --collect-all cv2 --collect-all PIL night_vision_enhancer.py
実行ファイル:[exe]
実行ファイル(exe)は、Chrome または Firefox を用いてダウンロードすることを推奨。初回実行時に、SmartScreenの「WindowsによってPCが保護されました」の警告画面が出ます。警告画面で「詳細情報」をクリック、「実行」をクリックで続行できます。
ソースコード実行のための前準備
Python 3.12 のインストール
Pythonのインストールを行い、Pythonのプログラムを実行する環境を整える。扱う環境は、Windows搭載パソコンである。金子研究室では、Python 3.12.10を推奨する。
[Windows での Python 3.12 のインストール手順を見るには、ここをクリック]
Windows での Python 3.12 のインストール
以下のいずれかの方法でPython 3.12をインストールする。Pythonがインストール済みの場合、この手順は不要である。
方法 1:winget によるインストール
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして、コマンド全体をコマンドプロンプトにコピー&ペーストする。
--scope machine を指定することで、システム全体(全ユーザー向け)にインストールされる。このオプションの実行には管理者権限が必要である。インストール完了後、コマンドプロンプトを再起動するとPATHが反映される。
REM Python 3.12 をシステム領域にインストール
winget install --id Python.Python.3.12 -e --scope machine --silent --accept-source-agreements --accept-package-agreements --override "/quiet InstallAllUsers=1 PrependPath=1 Include_test=0 Include_pip=1 Include_launcher=1 InstallLauncherAllUsers=1 TargetDir=\"C:\Program Files\Python312\""
if not "%ERRORLEVEL%"=="0" ( color 0c & echo Python 3.12 のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )

REM Python と Scripts を PATH 先頭に追加
powershell -NoProfile -Command "$p='C:\Program Files\Python312'; $s=\"$p\Scripts\"; if(Test-Path $p){$k=[Microsoft.Win32.Registry]::LocalMachine.OpenSubKey('SYSTEM\CurrentControlSet\Control\Session Manager\Environment',$true); $c=$k.GetValue('Path','',[Microsoft.Win32.RegistryValueOptions]::DoNotExpandEnvironmentNames); $t=$k.GetValueKind('Path'); $new=$c; if((';'+$new+';') -notlike \"*;$p;*\"){$new=$p+';'+$new}; if((';'+$new+';') -notlike \"*;$s;*\"){$new=$s+';'+$new}; if($new -ne $c){$k.SetValue('Path',$new,$t)}; $k.Close()}"

REM 現在のセッションにも反映(システムPATHを再取得して連結)
for /f "usebackq tokens=2,*" %A in (`reg query "HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment" /v Path`) do set "PATH=%B"

REM pip / wheel の更新
python -m pip install --no-user -U pip wheel
if not "%ERRORLEVEL%"=="0" ( color 0c & echo pip / wheel の更新に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
方法 2:インストーラーによるインストール
- Python公式サイト(https://www.python.org/downloads/)にアクセスし、「Download Python 3.x.x」ボタンからWindows用インストーラーをダウンロードする。
- ダウンロードしたインストーラーを実行する。
- 初期画面の下部に表示される「Add python.exe to PATH」にチェックを入れてから「Customize installation」を選択する。このチェックを入れ忘れると、コマンドプロンプトから
pythonコマンドを実行できない。 - 「Install Python 3.xx for all users」にチェックを入れ、「Install」をクリックする。
インストールの確認
コマンドプロンプトで以下を実行する。
python --versionバージョン番号(例:Python 3.12.x)が表示されればインストール成功である。「'python' は、内部コマンドまたは外部コマンドとして認識されていません。」と表示される場合は、インストールが正常に完了していない。
Python の開発環境 Visual Studio Code のインストールと Python 用の設定
Python の開発環境Visual Studio Code(プログラムを編集するソフトウェア。以下、VS Code)を整える。
[Windows での Visual Studio Code のインストールと Python 用の設定手順を見るには、ここをクリック]
Windows での Visual Studio Code のインストールと Python 用の設定手順
1. VS Code と拡張機能のインストール
以下のコマンドにより,既存の VS Code を削除し,全ユーザー共有の設定で再インストールしたうえで,拡張機能(VS Code に機能を追加するソフトウェア)をまとめて導入する.
【インストールコマンドの実行方法】
管理者権限でコマンドプロンプトを起動する(手順:Windows キーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。そして,コマンド全体をコマンドプロンプトにコピー&ペーストする。
インストールコマンド
REM ============================================================
REM Microsoft Visual Studio Code
REM ============================================================
REM Build Tools + Desktop development with C++(VCTools)+ 追加コンポーネント(一括)
REM 未インストール時: winget で新規インストール
REM インストール済み時: setup.exe modify でコンポーネント追加(バージョンは変更しない)
winget list --id Microsoft.VisualStudio.BuildTools 2>nul | findstr /i "BuildTools" >nul 2>&1
if %ERRORLEVEL% EQU 0 (
    for /f "usebackq delims=" %P in (`"C:\Program Files (x86)\Microsoft Visual Studio\Installer\vswhere.exe" -products Microsoft.VisualStudio.Product.BuildTools -property installationPath`) do start /wait "" "C:\Program Files (x86)\Microsoft Visual Studio\Installer\setup.exe" modify --installPath "%P" --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64 --includeRecommended --quiet --norestart --nocache
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のコンポーネント追加に失敗しました & ping 127.0.0.1 -n 6 >nul & color )
) else (
    winget install --scope machine --id Microsoft.VisualStudio.BuildTools -e --silent --disable-interactivity --force --accept-source-agreements --accept-package-agreements --override "--quiet --wait --norestart --nocache --add Microsoft.VisualStudio.Workload.VCTools --includeRecommended --add Microsoft.VisualStudio.Workload.MSBuildTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --add Microsoft.VisualStudio.Component.VC.Llvm.Clang --add Microsoft.VisualStudio.Component.VC.Llvm.ClangToolset --add Microsoft.VisualStudio.Component.Windows11SDK.26100 --add Microsoft.VisualStudio.Component.VC.v143.x86.x64"
    if not "%ERRORLEVEL%"=="0" ( color 0c & echo Build Tools のインストールに失敗しました & ping 127.0.0.1 -n 6 >nul & color )
)

REM 全ユーザー共有の拡張機能フォルダ
if not exist "C:\ProgramData\vscode-extensions" mkdir "C:\ProgramData\vscode-extensions"
icacls "C:\ProgramData\vscode-extensions" /grant "Everyone:(OI)(CI)M" /T

REM スタートメニューのショートカットを --extensions-dir 付きで再作成
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code" rmdir /s /q "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code"
if exist "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk" del "C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk"
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); $lnk.TargetPath='C:\Program Files\Microsoft VS Code\Code.exe'; $lnk.Arguments='--extensions-dir \"C:\ProgramData\vscode-extensions\"'; $lnk.Save()"
REM ショートカットの検証
powershell -NoProfile -Command "$s=New-Object -ComObject WScript.Shell; $lnk=$s.CreateShortcut('C:\ProgramData\Microsoft\Windows\Start Menu\Programs\Visual Studio Code.lnk'); Write-Host 'TargetPath:' $lnk.TargetPath; Write-Host 'Arguments:' $lnk.Arguments"

REM ファイル / フォルダ右クリックの「Code で開く」を登録
reg add "HKLM\SOFTWARE\Classes\*\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%1\"" /f
reg add "HKLM\SOFTWARE\Classes\Directory\Background\shell\VSCode\command" /ve /d "\"C:\Program Files\Microsoft VS Code\Code.exe\" --extensions-dir \"C:\ProgramData\vscode-extensions\" \"%V\"" /f

REM --extensions-dir 付きで起動する code.cmd ラッパを作成
REM (%* を echo で書くと対話的 cmd で失われるため、PowerShell で [char]37+'*' を書き出す)
powershell -NoProfile -Command "$pct=[char]37; $q=[char]34; $c='@echo off'+[char]13+[char]10+$q+'C:\Program Files\Microsoft VS Code\bin\code.cmd'+$q+' --extensions-dir '+$q+'C:\ProgramData\vscode-extensions'+$q+' '+$pct+'*'+[char]13+[char]10; [IO.File]::WriteAllText('C:\ProgramData\vscode-extensions\vscode.cmd',$c,[Text.Encoding]::ASCII)"

REM 拡張機能のインストール
set "CODE=C:\Program Files\Microsoft VS Code\bin\code.cmd"
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --uninstall-extension GitHub.copilot-chat
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.python
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.vscode-pylance
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension ms-python.debugpy
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension MS-CEINTL.vscode-language-pack-ja
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension saoudrizwan.claude-dev
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension rust-lang.rust-analyzer
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension tamasfe.even-better-toml
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension anthropic.claude-code
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --install-extension almenon.arepl
"%CODE%" --extensions-dir "C:\ProgramData\vscode-extensions" --list-extensions --show-versions

REM settings.json を作成(自動更新オフ、Python、Claude Code 設定)
if not exist "%APPDATA%\Code\User" mkdir "%APPDATA%\Code\User"
python -c "import json,os;data={'update.mode':'none','update.enableWindowsBackgroundUpdates':False,'extensions.autoUpdate':False,'python.defaultInterpreterPath':r'C:\Program Files\Python312\python.exe','claudeCode.environmentVariables':[{'name':'ANTHROPIC_API_KEY','value':'not-needed'},{'name':'ANTHROPIC_AUTH_TOKEN','value':'ollama'},{'name':'ANTHROPIC_BASE_URL','value':'http://localhost:11434'},{'name':'ANTHROPIC_MODEL','value':'glm-4.7-flash'},{'name':'CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC','value':'1'}]};p=os.path.join(os.environ['APPDATA'],'Code','User','settings.json');open(p,'w',encoding='utf-8').write(json.dumps(data,indent=4));print('Done:',p)"

REM 自動更新の抑止ポリシー(settings.json に加えて、レジストリ側でも明示的にオフ)
reg add "HKLM\SOFTWARE\Policies\Microsoft\VSCode" /v "UpdateMode" /t REG_SZ /d "none" /f
echo === セットアップ完了 ===
2. Python インタプリタの選択
同一マシンに複数の Python がインストールされている場合,VS Code で使用する Python 本体(インタプリタ:Python プログラムを解釈・実行するソフトウェア)を選択する必要がある.
- コマンドパレット(コマンド名で機能を呼び出す VS Code の入力欄)を開く(
Ctrl+Shift+P) Python: Select Interpreterと入力する
- 表示される一覧から,使用する Python(例:
C:\Program Files\Python312\python.exe)を選択する.
必要なライブラリをシステム領域にインストール
管理者権限でコマンドプロンプトを起動する
(手順:Windowsキーまたはスタートメニュー → cmd と入力 → 右クリック → 「管理者として実行」)。
以下を実行する。torch.load の weights_only 引数を使うため、PyTorch は新しい版が必要である。
REM PyTorch をインストール(GPU対応版)
set "CUDA_TAG=cu128"
pip uninstall -y opencv-python-headless opencv-contrib-python-headless opencv-python
pip install --no-user -U numpy torch torchvision torchaudio --index-url https://download.pytorch.org/whl/%CUDA_TAG%
pip install --no-user -U opencv-contrib-python pillow
ソースコード
"""
暗所映像の暗部復元ビューア (Windows / CPU・GPU 両対応)
================================================================================
夜間や無照明環境で撮影した映像に対し、学習済み CNN による画素別トーンカーブ推定
(Zero-DCE) と後処理を適用し、暗部の被写体を視認できる映像に変換する。
■ 入力 (起動時のダイアログ、実行中は「入力を切り替える」または I キー)
1. カメラ : 番号を指定して「カメラを使う」を押したときに 1 回だけ開く
2. 動画ファイル : パソコン内の動画を選択 (先頭フレームの復号を確認して採用)
3. デモ映像 : Pixabay で公開されている夜間街路映像を初回のみ自動取得
取得元: https://cdn.pixabay.com/video/2016/02/13/2147-155244189_medium.mp4
■ 処理解像度の選択 (操作パネル)
速度優先 : 処理幅の上限を設ける (GPU 1280px / CPU 960px)。係数マップは起動時に
実測して決めた幅で推定する。録画・静止画もこの解像度になる。
品質優先 : 処理幅の上限を外し、入力の解像度そのままで処理する。係数マップの
推定幅は FULL_WIDTH (1280px) を上限とする。係数マップは空間的に
滑らかなので、元解像度で推定した場合との差は小さい。実時間性は
保証しない。
■ 元解像度での書き出し (動画ファイル入力のときだけ)
元解像度・元フレームレートを保ち、全フレームを処理して MP4 を書き出す。
1 パス目 : ファイル全体から統計を集め、強度の中央値を求める
調整 : 代表フレームで出力の飽和率を実測し、入力より増えすぎない強度に
確定する (白飛びが増えて明部の情報が失われるのを防ぐ)
2 パス目 : 前後 1 フレームを使う双方向の時間方向ノイズ低減と本処理を行う
(未来のフレームを使うため実時間表示では使えない)
強度を固定するので、毎フレーム推定による時間方向の揺らぎがない。音声は
cv2.VideoWriter では扱えないため含まれない。所要時間は先頭フレームで実測して
事前に提示し、途中で中止できる。
■ 復元モデル: Zero-DCE (Zero-Reference Deep Curve Estimation, CVPR 2020)
DCE-Net (7層 CNN) が画素ごとの光強調カーブ係数 (24ch = 8反復 x RGB) を推定し、
LE(x) = x + r*(x^2 - x) を8回反復して暗部を持ち上げる。参照画像を用いない
損失で学習されているため未知の夜間映像へ汎化しやすい。重みは公式リポジトリ
(Li-Chongyi/Zero-DCE) の Epoch99.pth (約313KB) を初回起動時に取得する。
読み込みは weights_only=True で行い、load_state_dict による構造の完全一致が
ファイルの健全性検証を兼ねる。失敗時はファイルを削除して次回再取得させる。
Zero-DCE は「暗部を持ち上げるフィルタ」ではなく、露出と色の正規化を内蔵した
変換である。公式の学習コードは損失に L_exp(16, 0.6) と L_color を含み、局所
領域の明るさを一定値へ寄せ、色チャネル間の偏りを抑えるよう学習されている。
後段に同じ向きの補正を重ねると二重補正になるため、
・混合率を画素別にして暗部だけに適用する (blend_mask)
・自己較正ガンマは暗部を持ち上げる方向にのみ働かせ、明るい画素を
わざわざ暗く戻すことはしない
としている。さらに LE(x) の係数 r は R,G,B ごとに独立なので、暗部のわずかな
チャネル不均衡が 8 回の反復で増幅され、夜景全体が青緑側へ転ぶことがある。
これを抑えるため preserve_hue で「輝度比だけを全チャネルへ一律に掛けた画像」
(入力の色度を厳密に保つ) と混ぜる。
また、対向車のヘッドライト発光面のように面積を持って明るい光源は、内部の
階調を保っても意味のある情報にならず、むしろ持ち上げた暗部の諧調をハレー
ションで覆い隠す。これを抑えるため suppress_glare で、明るい画素が近傍に
どれだけ密集しているか (近傍占有率) を測り、密集度の高い領域だけを検出して
減光する。街灯や遠方の光源のような孤立した点光源は近傍が暗いため占有率が
低く保たれ、検出されずそのまま残る。
■ 処理順序 (要点: ノイズ低減を増幅より前に置く)
1. 時間方向ノイズ低減。実時間表示では動き適応の再帰型、書き出しでは前後
フレームを使う双方向型を用いる。混合率は経過時間から求めるので、実効
フレームレートが変わっても時定数は一定である。画面全体が動く映像では
この処理が効かないため、動き画素の割合に応じて空間方向を強める。
2. Zero-DCE による暗部伸張 (色度の引き戻しと画素別混合を伴う)
3. 照明補正 (自己較正ガンマ + 明部保護) とホワイトバランスを、1枚の低解像度
ゲインマップに合成して1回の乗算で適用
4. 面積の広い高輝度光源の減光 (suppress_glare)。対向車のヘッドライト
発光面のように面積を持って明るい部分だけを検出して減光し、点光源は
そのまま残す
5. 仕上げ (YCrCb): 輝度はエッジ保存平滑化、色差は縮小して平滑化 →
CLAHE → しきい値付きアンシャープマスク → 明部を締めるトーンカーブ・彩度
(暗部を暗く戻す処理は行わない)
明部を締めるトーンカーブは輝度 Y を変えるので、色差 Cr,Cb にも同じ比を掛ける。
YCrCb では彩度が輝度に対する相対量であり、Y だけを上げると彩度比が下がって
色が薄く見えるためである。比は 1 以下に制限し、色ノイズの増幅を避ける。
■ 解像度に対する取り扱い (二種類の尺度を区別する)
絶対画素尺度: バイラテラルフィルタ・色差の平滑化・アンシャープマスク。
センサの読み出しノイズとショットノイズは画素単位の現象であり、画像の
大きさに比例しない。高解像度でも同じ画素数の窓で処理するのが正しく、
窓を比例させると計算量が二乗で増えるうえ本来残せる細部を潰す。
その結果、高解像度では画面全体に対する効果が相対的に穏やかに見える。
相対尺度: 照明成分の推定・混合率マスク・動き検出。これらは場面の構造に
対する量なので、処理幅に比例させて解像度によらず同じ効果にする。
ノイズ標準偏差は、処理解像度のフレームと縮小前の原画の両方から推定して
大きい方を採る。縮小はノイズを平均化するが、再標本化でノイズに空間相関が
生じると Immerkær のマスク応答が小さくなり、縮小後の推定だけでは過小評価に
なるためである。
カーブ係数マップの縮小推定では縦横比を厳密に保つ。DCE-Net はプーリングを
持たない 3x3 畳み込みのみの網なので、入力寸法を 8 の倍数へ丸める必要はない。
丸めると係数マップが数 % 伸縮し、画面端でゲインが輪郭とずれる。
係数マップの適用は 3ch ずつ拡大して逐次行う。補間はチャネルごとに独立なので
24ch を一括で拡大した場合と数値は完全に等価で、峰値記憶量だけが 1/8 になる。
■ 自動パラメータ推定
平均輝度・推定ノイズ標準偏差・エッジ密度から 3 つの強度を推定し、指数移動平均
で平滑化する。さらに出力の飽和率を入力と比べ、増えすぎている間は暗部復元の
強度を少しずつ引き下げる (不感帯を置いた積分制御)。白飛びが増えて明部の
情報が失われるのを防ぐためである。スライダに触れた時点で手動設定へ
切り替わる。
■ 補助表示
・並置比較 (ワイプ): 境界は映像上の左ドラッグで移動
・輝度ヒストグラム: 入力と補正後を対数縦軸で重ね、飽和率と黒つぶれ率を併記
する。飽和率が入力より大きく増えていないか、黒つぶれ率が入力より大きく
増えていないかを見る指標として使う。どちらも元の映像の諧調情報が
失われていないかを表す。
・評価用 低照度シミュレーション: 入力を γ=2.2 の逆変換で近似的に線形化し、
露光量を下げて光ショットノイズと読み出しノイズを加え、再び γ 符号化する。
補正後の画素値は、画素ごとに異なる非線形トーンマッピングの結果であり、
放射輝度やその比の測定値ではない。画面上にもこの注意書きを常時表示する。
■ 操作
操作パネル (別ウィンドウ) の各部品、または映像ウィンドウ上のキー操作
SPACE 並置比較 P 一時停止 G ヒストグラム L 低照度シミュレーション
S 静止画保存 R 録画開始/停止 I 入力切替 Q・ESC 終了
必要なもの: pip install opencv-python numpy torch pillow
(torch は weights_only 引数に対応した版が必要)
実行: python night_vision_enhancer.py
"""
import math
import os
import time
import urllib.request
import tkinter as tk
from tkinter import filedialog, messagebox, ttk
import cv2
import numpy as np
# torch の読み込みだけで数秒かかり、その間はウィンドウを1つも出せないため、
# 端末側に進行を知らせる (pythonw 起動時は表示されない)
print("起動中: PyTorch を読み込んでいます...", flush=True)
import torch
import torch.nn as nn
import torch.nn.functional as F
from PIL import Image, ImageDraw, ImageFont
# OpenCV 自身が標準エラーへ出す警告を抑止する。撮影バックエンド (FFmpeg など) が
# 直接書き出す出力はこれでは止まらない
cv2.utils.logging.setLogLevel(cv2.utils.logging.LOG_LEVEL_ERROR)
# ----------------------------------------------------------------------------
# 定数
# ----------------------------------------------------------------------------
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
WEIGHTS_URL = ("https://raw.githubusercontent.com/Li-Chongyi/Zero-DCE/master/"
"Zero-DCE_code/snapshots/Epoch99.pth")
WEIGHTS_PATH = os.path.join(SCRIPT_DIR, "zero_dce_epoch99.pth")
DEMO_URL = "https://cdn.pixabay.com/video/2016/02/13/2147-155244189_medium.mp4"
DEMO_PATH = os.path.join(SCRIPT_DIR, "demo_night_street.mp4")
DEMO_NAME = "デモ映像 (夜間の街路 / Pixabay 公開素材)"
UI_FONT = "Meiryo"
VIDEO_EXT = "*.mp4 *.avi *.mov *.mkv *.wmv *.m4v *.mpg *.mpeg *.webm"
SCENE_LABELS = ("自動判別", "屋外 (点光源を含む)", "屋内 (照明ムラ)", "文字・書類")
# 録画に使う符号化方式。前にあるものから順に試し、開けたものを使う
CODECS = ("avc1", "mp4v")
# 映像上に文字を描画するためのフォント。日本語が出る順に並べ、最後に欧文フォントを
# 置く。見つからない場合も起動できるように、ここでは例外を投げない
_FONT_CANDIDATES = (r"C:\Windows\Fonts\meiryo.ttc",
r"C:\Windows\Fonts\YuGothM.ttc",
r"C:\Windows\Fonts\YuGothR.ttc",
r"C:\Windows\Fonts\msgothic.ttc",
r"C:\Windows\Fonts\msmincho.ttc",
r"C:\Windows\Fonts\segoeui.ttf",
r"C:\Windows\Fonts\arial.ttf")
_FONT_FILE = next((p for p in _FONT_CANDIDATES if os.path.exists(p)), None)
_FONT_WARNING = ("" if _FONT_FILE else
"フォントが見つからないため、映像上の文字は簡易表示になります: "
+ " / ".join(os.path.basename(p) for p in _FONT_CANDIDATES))
_FONT_CACHE = {}
# ----------------------------------------------------------------------------
# 汎用ユーティリティ
# ----------------------------------------------------------------------------
def to_float(img):
return img.astype(np.float32) / 255.0
def to_uint8(img):
return np.clip(img * 255.0 + 0.5, 0, 255).astype(np.uint8)
def shrink(img, width):
"""統計量・低周波成分の算出用に縮小する。"""
h, w = img.shape[:2]
if w <= width:
return img
return cv2.resize(img, (int(width), max(1, round(h * width / w))),
interpolation=cv2.INTER_AREA)
def map_width(width):
"""ゲインマップ・混合率マスク・動き検出に使う低解像度の幅を返す。
低周波成分を求めるだけなら 192px でも足りるが、混合率マスクと動き検出は
「増幅する場所」を直接決めるため、粗いと点光源の周囲に広いにじみが出る。
処理幅の 1/2 を目安に 256-512px の範囲で決める。
"""
return int(np.clip(width // 2, 256, 512))
def fit_frame(frame, max_width):
"""処理サイズを決める。幅を max_width 以下に収め、縦横とも偶数にする。
偶数化は MPEG-4 系の符号化が偶数寸法を前提とするための措置で、
録画時のフレーム欠落を原理的に排除する。
"""
h, w = frame.shape[:2]
tw = max(2, min(w, int(max_width)) // 2 * 2)
th = max(2, round(h * tw / w) // 2 * 2)
if (tw, th) == (w, h):
return frame
return cv2.resize(frame, (tw, th), interpolation=cv2.INTER_AREA)
def font(px):
"""指定した文字高のフォントを返す (生成結果は使い回す)。"""
px = max(9, int(px))
if px not in _FONT_CACHE:
if _FONT_FILE is None:
_FONT_CACHE[px] = ImageFont.load_default()
else:
_FONT_CACHE[px] = ImageFont.truetype(_FONT_FILE, px)
return _FONT_CACHE[px]
def fit_px(text, width, px):
"""text が width [px] に収まる文字高を返す。"""
need = font(px).getlength(text)
return px if need <= width else max(9, int(px * width / need))
def draw_texts(canvas, rect, items, dim=0.0):
"""canvas の矩形 rect=(x, y, w, h) に黒の下地を不透明度 dim で敷き、文字を描く。
items は (矩形内x, 矩形内y, 文字列, 文字高px, BGR色, 基準位置) の並び。
矩形部分だけを色空間変換するので、毎フレーム描画しても負荷は小さい。
anchor は truetype フォントでのみ有効なので、退避フォント時は指定しない。
"""
x, y, w, h = rect
x, y = max(0, x), max(0, y)
w, h = min(w, canvas.shape[1] - x), min(h, canvas.shape[0] - y)
if w < 40 or h < 12:
return
roi = canvas[y:y + h, x:x + w]
if dim > 0.0:
cv2.addWeighted(roi, 1.0 - dim, np.zeros_like(roi), dim, 0.0, dst=roi)
pil = Image.fromarray(cv2.cvtColor(roi, cv2.COLOR_BGR2RGB))
draw = ImageDraw.Draw(pil)
for tx, ty, text, px, color, anchor in items:
draw.text((tx, ty), text, font=font(px), fill=tuple(color[::-1]),
anchor=anchor if _FONT_FILE else None)
roi[:] = cv2.cvtColor(np.asarray(pil), cv2.COLOR_RGB2BGR)
def center_window(win):
win.update_idletasks()
x = (win.winfo_screenwidth() - win.winfo_width()) // 2
y = (win.winfo_screenheight() - win.winfo_height()) // 3
win.geometry(f"+{max(0, x)}+{max(0, y)}")
def download(url, path, parent, title, message):
"""進捗を表示しながら取得する。
受信は一時ファイルへ行い、Content-Length と一致したときだけ本来の名前へ
置き換える。ウィンドウは利用者からは閉じられないようにするが、失敗時には
必ず破棄して一時ファイルも消すため、閉じられない窓が残ることはない。
transient は parent が可視のときだけ設定する。withdrawn なウィンドウを
親に指定すると、transient は初回マップ時に親の状態を継承するため、この窓が
非表示のまま開いてしまう。
"""
win = tk.Toplevel(parent)
win.title(title)
win.resizable(False, False)
win.protocol("WM_DELETE_WINDOW", lambda: None)
text = tk.StringVar(value=message)
tk.Label(win, textvariable=text, font=(UI_FONT, 10), justify="left"
).pack(padx=24, pady=(18, 8))
bar = ttk.Progressbar(win, length=400, maximum=1000.0)
bar.pack(padx=24, pady=(0, 20))
if parent.winfo_viewable():
win.transient(parent)
center_window(win) # update_idletasks でマップされる
win.grab_set() # マップ後に掴む (未マップだと失敗する)
win.update()
tmp = path + ".part"
try:
request = urllib.request.Request(url,
headers={"User-Agent": "Mozilla/5.0"})
with urllib.request.urlopen(request, timeout=30) as res, \
open(tmp, "wb") as f:
total = int(res.headers.get("Content-Length", 0))
done = 0
while True:
chunk = res.read(1 << 18)
if not chunk:
break
f.write(chunk)
done += len(chunk)
if total:
bar["value"] = 1000.0 * done / total
text.set(f"{message}\n{done / 1e6:.1f} / {total / 1e6:.1f} MB")
else:
text.set(f"{message}\n{done / 1e6:.1f} MB 受信")
win.update()
if total and done != total:
raise RuntimeError(f"受信が不完全です ({done}/{total} バイト): {url}")
os.replace(tmp, path)
except BaseException:
if os.path.exists(tmp):
try:
os.remove(tmp)
except OSError:
pass
raise
finally:
try:
win.grab_release()
except tk.TclError:
pass
win.destroy()
class Ema:
"""指数移動平均。時定数を秒で持ち、経過時間から混合率を決める。
フレーム単位の固定係数にすると、実効フレームレートが変わったときに平滑化の
強さも変わってしまう。処理が遅い機械で追従が遅れるのを避けるため、
alpha = 1 - exp(-dt/tau) とする。
"""
def __init__(self, tau=0.26):
self.tau = tau
self.state = {}
def reset(self):
self.state.clear()
def __call__(self, key, value, dt):
alpha = float(np.clip(1.0 - math.exp(-max(dt, 1e-4) / self.tau), 0.02, 1.0))
prev = self.state.get(key)
cur = value if prev is None else prev + (value - prev) * alpha
self.state[key] = cur
return cur
def luminance_profile(bgr, bins=128):
"""輝度ヒストグラム (対数・最大値正規化) と飽和率・黒つぶれ率を返す。
飽和率と黒つぶれ率は画素を数えるので、縮小した画像では平均化されて過小に
なる。したがって必ず与えられた解像度のまま数え、代わりに呼び出し頻度を
落として負荷を抑える。
"""
y = cv2.cvtColor(bgr, cv2.COLOR_BGR2GRAY) # BT.601 の輝度成分
hist = cv2.calcHist([y], [0], None, [bins], [0, 256]).ravel()
log = np.log1p(hist)
curve = log / max(float(log.max()), 1e-6)
return (curve, float(np.count_nonzero(y >= 254)) / y.size,
float(np.count_nonzero(y <= 1)) / y.size)
# ----------------------------------------------------------------------------
# 学習済みモデル Zero-DCE
# ----------------------------------------------------------------------------
class DCENet(nn.Module):
"""Zero-DCE 公式実装 (enhance_net_nopool) と同一構造。公開重みと互換。
公式実装が持つ maxpool / UpsamplingBilinear2d は学習パラメータもバッファも
持たないため、省略しても load_state_dict(strict=True) は成立する。
プーリングが無いので、入力寸法に 8 の倍数などの制約は無い。
"""
def __init__(self):
super().__init__()
f = 32
self.relu = nn.ReLU(inplace=True)
self.e_conv1 = nn.Conv2d(3, f, 3, 1, 1)
self.e_conv2 = nn.Conv2d(f, f, 3, 1, 1)
self.e_conv3 = nn.Conv2d(f, f, 3, 1, 1)
self.e_conv4 = nn.Conv2d(f, f, 3, 1, 1)
self.e_conv5 = nn.Conv2d(f * 2, f, 3, 1, 1)
self.e_conv6 = nn.Conv2d(f * 2, f, 3, 1, 1)
self.e_conv7 = nn.Conv2d(f * 2, 24, 3, 1, 1)
def forward(self, x):
"""入力 RGB(0-1) から画素ごとのカーブ係数マップ (24ch, tanh 出力) を返す。"""
x1 = self.relu(self.e_conv1(x))
x2 = self.relu(self.e_conv2(x1))
x3 = self.relu(self.e_conv3(x2))
x4 = self.relu(self.e_conv4(x3))
x5 = self.relu(self.e_conv5(torch.cat([x3, x4], 1)))
x6 = self.relu(self.e_conv6(torch.cat([x2, x5], 1)))
return torch.tanh(self.e_conv7(torch.cat([x1, x6], 1)))
class ZeroDCE:
"""Zero-DCE の推論器。CUDA が利用できる場合は自動的に使用する。
CNN は縮小画像で実行し、得られたカーブ係数マップ (24ch) を双線形補間で
処理解像度へ拡大してからカーブを適用する。係数マップは空間的に滑らかなので
画質の低下は小さく、畳み込みの演算量だけが大きく下がる。推論幅がフレーム幅
以上になる場合は縮小を省く。
縮小時は縦横比を厳密に保つ。寸法を 8 の倍数へ丸めると係数マップが数 % 伸縮し、
画面端でゲインが輪郭と十数画素ずれて二重輪郭やにじみの原因になる。
品質優先でも推論幅に上限 (FULL_WIDTH) を設ける。DCE-Net は 32ch の中間層を
6 枚保持するため、4K で元解像度推論を行うと活性値だけで 1GB を超え、多くの
機械で確保に失敗する。係数マップが滑らかであることを利用し、推定だけを
1280px 以下で行い、適用は処理解像度で行う。確保に失敗した場合は幅を半分に
下げて再試行し、成功した幅を記憶する。
予算に収まらない場合は、まず推論幅を下げる。係数マップを時間方向に間引くと
動く被写体でゲインが内容に追従せず目立つため、間引きは下限幅でも足りない
場合の最後の手段とする。なお 1 フレームの総処理時間のうち CNN の取り分は
3 割程度であり、間引いても実時間性は回復しない。
"""
# BGR 画像へ直接カーブを適用するための係数の並べ替え (8反復 x RGB -> BGR)
_BGR_ORDER = [3 * i + c for i in range(8) for c in (2, 1, 0)]
CURVE_TAU = 0.08 # 係数マップの時間方向の平滑化の時定数 [s]
FULL_WIDTH = 1280 # 品質優先での推論幅の上限
MIN_WIDTH = 192 # 記憶量不足で下げるときの下限
def __init__(self, parent):
if not os.path.exists(WEIGHTS_PATH):
download(WEIGHTS_URL, WEIGHTS_PATH, parent, "学習済みモデルの取得",
"Zero-DCE の学習済み重み (約313KB) を取得しています。")
torch.set_flush_denormal(True)
net = DCENet()
try:
state = torch.load(WEIGHTS_PATH, map_location="cpu",
weights_only=True)
except TypeError as exc:
# weights_only 引数の無い古い torch。安全性を落とさず助言する
raise RuntimeError(
"この torch は torch.load の weights_only に対応していません。"
"torch を更新してください。") from exc
try:
net.load_state_dict(state)
except Exception as exc:
# 構造不一致 = ファイルが壊れている。次回起動で再取得させる
try:
os.remove(WEIGHTS_PATH)
except OSError:
pass
raise RuntimeError(
"学習済み重みの内容がモデル構造と一致しません。ファイルを削除し"
"ました。もう一度起動すると再取得します。") from exc
self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
self.net = net.to(self.device).eval()
if self.device.type == "cuda":
torch.backends.cudnn.benchmark = True
self._preview = self._calibrate()
self.full = False
self.full_width = self.FULL_WIDTH
self.infer_width, self.interval = self._preview
self._curves = None
self._tick = 0
print(f"Zero-DCE 準備完了 演算装置: {self.device} "
f"推論幅: {self.infer_width}px "
f"係数マップ更新: {self.interval} フレームに1回")
def reset(self):
self._curves = None
self._tick = 0
def set_full(self, full):
"""品質優先 (処理解像度の上限なし) と速度優先を切り替える。"""
full = bool(full)
if full == self.full:
return
self.full = full
self.infer_width, self.interval = ((self.full_width, 1) if full
else self._preview)
self.reset()
def describe(self):
if self.full:
return (f"画像は処理解像度のまま/係数マップは幅 {self.full_width}px "
"以下で推定")
return f"幅 {self.infer_width}px/{self.interval} フレームに1回更新"
@torch.inference_mode()
def _calibrate(self, budget_ms=None):
"""係数推定コストを実測し、推論幅と更新間隔を決める。
畳み込みの演算量は入力幅の2乗に比例するため、実測時間から必要な幅を
逆算できる。CPU の予算を小さく取っているのは、カーブ係数マップが空間的に
滑らかで、幅を 300px 程度まで落としても最終画質の差がほとんど無い一方、
1フレームの総処理時間では後処理 (バイラテラルフィルタ・CLAHE・
アンシャープマスク) の取り分が大きく、そちらに時間を残した方が体感が
良いためである。予算は CNN の推論時間だけを対象としており、総処理時間は
これより大きい (画面に実測値を表示)。
"""
if budget_ms is None:
budget_ms = 25.0 if self.device.type == "cuda" else 40.0
probe = torch.rand(1, 3, 144, 256, device=self.device)
for _ in range(3):
self.net(probe)
if self.device.type == "cuda":
torch.cuda.synchronize()
t0 = time.perf_counter()
for _ in range(3):
self.net(probe)
if self.device.type == "cuda":
torch.cuda.synchronize()
ms256 = (time.perf_counter() - t0) / 3 * 1000.0
width = 256.0 * (budget_ms / max(ms256, 1e-3)) ** 0.5
if width >= 160.0:
return int(np.clip(round(width / 32) * 32, 160, 1024)), 1
# 下限幅でも予算を超える機械のみ、更新を間引いて負荷を均す
interval = int(np.clip(np.ceil(ms256 * (160 / 256) ** 2 / budget_ms), 1, 3))
return 160, interval
def _shrink_width(self, target):
"""記憶量不足のときに推論幅を下げ、成功した幅を記憶する。"""
target = max(self.MIN_WIDTH, target // 2)
if self.full:
self.full_width = target
else:
self.infer_width = target
return target
@torch.inference_mode()
def _estimate(self, img_bgr, dt):
"""カーブ係数マップを推定し、時間方向に平滑化して保持する。"""
h, w = img_bgr.shape[:2]
target = min(int(self.infer_width), w)
while True:
sw = max(16, target)
sh = max(8, round(sw * h / w)) # 縦横比を厳密に保つ
if (self._curves is not None
and self._curves.shape[-2:] == (sh, sw)
and self._tick % self.interval != 0):
return
small = (img_bgr if (sw, sh) == (w, h) else
cv2.resize(img_bgr, (sw, sh), interpolation=cv2.INTER_AREA))
rgb = np.ascontiguousarray(small[..., ::-1].transpose(2, 0, 1)[None])
try:
curves = self.net(
torch.from_numpy(rgb).to(self.device))[:, self._BGR_ORDER]
except RuntimeError as exc:
if self.device.type == "cuda":
torch.cuda.empty_cache()
if target <= self.MIN_WIDTH:
raise RuntimeError(
"カーブ係数の推定に失敗しました (記憶容量の不足が"
"考えられます)。処理解像度を下げてください。") from exc
target = self._shrink_width(target)
self._curves = None
continue
if self._curves is not None and self._curves.shape == curves.shape:
# フレーム独立処理による輝度のちらつきを抑える。混合率は経過時間
# から求めるので、実効フレームレートが変わっても時定数は一定
alpha = float(np.clip(
1.0 - math.exp(-max(dt, 1e-4) / self.CURVE_TAU), 0.05, 1.0))
curves = self._curves + alpha * (curves - self._curves)
self._curves = curves
return
@torch.inference_mode()
def __call__(self, img_bgr, dt):
"""img_bgr: float32 BGR [0,1] -> 暗部伸張後の float32 BGR [0,1]"""
h, w = img_bgr.shape[:2]
self._estimate(img_bgr, dt)
self._tick += 1
try:
x = torch.from_numpy(np.ascontiguousarray(
img_bgr.transpose(2, 0, 1)[None])).to(self.device)
# 3ch ずつ拡大して逐次適用する。補間はチャネル独立なので 24ch を
# 一括で拡大した場合と数値は等価で、峰値記憶量だけが 1/8 になる
for r in torch.split(self._curves, 3, dim=1):
if r.shape[-2:] != (h, w):
r = F.interpolate(r, size=(h, w), mode="bilinear",
align_corners=False)
t = x * x
t -= x
t *= r
x += t # LE(x) = x + r*(x^2 - x)
del t
out = x.clamp_(0.0, 1.0)[0].permute(1, 2, 0)
return np.ascontiguousarray(out.cpu().numpy())
except RuntimeError as exc:
if self.device.type == "cuda":
torch.cuda.empty_cache()
raise RuntimeError(
"カーブの適用に失敗しました (記憶容量の不足が考えられます)。"
"処理解像度を下げてください。") from exc
# ----------------------------------------------------------------------------
# 後処理
# ----------------------------------------------------------------------------
_BGR_LUMA = np.float32([0.114, 0.587, 0.299]) # BT.601 (BGR の並び)
def motion_map(a, b, sigma, mw):
"""2 枚の差から「動いている度合い」(0-1) の低解像度マップを作る。
判定しきい値を推定ノイズ標準偏差に比例させるため、暗部でも静止判定を
誤らない。平滑化の幅は処理幅に比例させ、解像度によらず同じ広さにする。
"""
diff = shrink(np.abs(a - b).mean(axis=2), mw)
floor = max(sigma, 1.0 / 255.0)
return cv2.GaussianBlur(np.clip((diff - 1.2 * floor) / (5.0 * floor), 0.0, 1.0),
(0, 0), max(1.0, 2.0 * mw / 192.0))
class TemporalDenoiser:
"""動き適応の時間方向ノイズ低減 (再帰型・1次 IIR)。
ノイズが増幅される前の入力段で適用する。静止領域の時定数は秒で与えるので、
実効フレームレートが変わっても効き方は変わらない。動き画素の割合も返す。
走行中の車載映像のように画面全体が動く映像ではこの処理はほとんど効かない
ため、呼び出し側でその分だけ空間方向のノイズ低減を強める。
"""
TAU = 0.12 # 静止領域の時定数 [s] (強度 1 のとき)
def __init__(self):
self.prev = None
def reset(self):
self.prev = None
def __call__(self, img, strength, sigma, dt, mw):
if strength <= 1e-3 or self.prev is None or self.prev.shape != img.shape:
self.prev = img.copy()
return img, 0.0
h, w = img.shape[:2]
motion = motion_map(img, self.prev, sigma, mw)
# 静止画素 (motion=0) では keep_static、動画素では 1 に近づける
keep_static = 1.0 - math.exp(-max(dt, 1e-4) / max(self.TAU * strength, 1e-3))
keep = cv2.resize(keep_static + (1.0 - keep_static) * motion,
(w, h), interpolation=cv2.INTER_LINEAR)[..., None]
out = self.prev + (img - self.prev) * keep # 静止領域ほど過去を強く残す
self.prev = out
return out, float(motion.mean())
def window_denoise(center, neighbors, strength, sigma, mw):
"""前後フレームを動き適応で平均する双方向の時間方向ノイズ低減。
書き出し専用である。未来のフレームを使うため実時間表示では遅延になるが、
書き出しでは制約が無く、再帰型より残像を出さずに強く平均化できる。
center は float32 BGR [0,1]、neighbors は同じ形の uint8 または float32。
重みは「動いていない度合い」なので、動いた画素では近傍が混ざらない。
"""
if strength <= 1e-3 or not neighbors:
return center
h, w = center.shape[:2]
acc = center.copy()
wsum = np.ones((h, w, 1), np.float32)
for nb in neighbors:
f = to_float(nb) if nb.dtype == np.uint8 else nb
if f.shape != center.shape:
continue
still = 1.0 - motion_map(f, center, sigma, mw)
weight = cv2.resize(still * strength, (w, h),
interpolation=cv2.INTER_LINEAR)[..., None]
acc += f * weight
wsum += weight
return acc / wsum
def preserve_hue(enhanced, src, keep):
"""Zero-DCE 出力の輝度上昇分を保ったまま、色みを入力へ引き戻す。
LE(x) の係数は R,G,B ごとに独立なので、暗部のわずかなチャネル不均衡が
8 回の反復で増幅され、夜景全体が青緑側へ転ぶことがある。輝度比
g = Y_enhanced / Y_src を全チャネルへ一律に掛けた画像は入力の色度を厳密に
保つため、これと元の出力を keep で混ぜて色の振れだけを抑える。
keep を上げると、モデルが持つ色かぶりの中立化も同時に弱まる。
"""
if keep <= 1e-3:
return enhanced
ys = np.maximum((src * _BGR_LUMA).sum(axis=2), 1e-4)
ya = (enhanced * _BGR_LUMA).sum(axis=2)
gain = np.clip(ya / ys, 0.0, 60.0)[..., None]
neutral = np.clip(src * gain, 0.0, 1.0)
return enhanced * (1.0 - keep) + neutral * keep
def blend_mask(img, strength, knee, mw):
"""Zero-DCE 出力を混ぜる比率を画素ごとに決める。
入力が明るい画素 (街灯・前照灯・看板) では 0 に近づけて入力をそのまま残し、
暗い画素でのみ strength まで上げる。混合率を全画面一律にすると、Zero-DCE が
露出を正規化する性質と相まって点光源が飽和し、夜の場面が昼のように見えて
しまう。knee は混合率が 0 になる明度で、小さいほど入力を広く残す。
明度は縮小・平滑化してから用いる。混合率が輪郭で急変すると増幅の段差が
見えるためである。平滑化の標準偏差は処理幅の 0.6% に相当する量へ固定するので、
解像度によらず同じ広さの遷移域になる。
"""
v = shrink(img.max(axis=2), mw)
v = cv2.GaussianBlur(v, (0, 0), max(1.0, 0.006 * v.shape[1]))
t = np.clip(v / max(knee, 1e-3), 0.0, 1.0)
m = strength * (1.0 - t * t * (3.0 - 2.0 * t)) # smoothstep で滑らかに減衰
return cv2.resize(m, (img.shape[1], img.shape[0]),
interpolation=cv2.INTER_LINEAR)[..., None]
def suppress_glare(img, strength, bright_th, low, high, mw):
"""面積が広く、かつ明るい光源 (対向車のヘッドライト発光面、看板の地色
など) だけを検出し、明るさを落として肥大やにじみを抑える。
街灯や遠方の点光源は、1〜2 画素程度の輝点であっても周囲に情報を持たない
ため、暗所復元の観点では暗部にわずかな手がかりを残す点光源自体を守る
必要がある (blend_mask の knee が担う)。一方、対向車のヘッドライトの
ように面積を持って明るい光源は、その内部の階調を保存しても意味のある
情報にならず、むしろ持ち上げた暗部の諧調をハレーションで覆い隠す。
両者を区別する指標には、局所平均の絶対値ではなく「明るい画素が近傍に
どれだけ密集しているか (近傍占有率)」を用いる。単発の点光源は周囲が
暗いため占有率が低く保たれる一方、対向車のヘッドライトのように複数の
光源が並ぶ場合や面積そのものが広い場合は、個々が中程度の大きさでも
合算されて占有率が高くなるため、局所平均だけでは検出できないケースも
拾える。占有率はガウシアン平滑化で求める。矩形窓の平均化 (ボックス
フィルタ) は二値マップに対して窓の境界がそのまま正方形の格子模様として
現れ、拡大後にブロック状の劣化になるため用いない。平滑化の広さは処理幅の
5% 相当とし、解像度によらず同じ広さの近傍で判定する。low 未満はそのまま、
low〜high は滑らかに減光量を強め、high 以上は strength で頭打ちにする。
減光は明るい画素の場所にのみ適用し、暗い隙間や周辺の非光源部分を
巻き込まない。
「明るい画素」のしきい値 bright_th は、雲や白い壁のように明るいが飽和は
していない自然物と、対向車のヘッドライトのような真の光源との境目を、
映っている被写体ごとに切り分けるものである。この境目は素材によって
大きく動くため、シーン別の既定値を一つに決め打ちすることはできない。
そのため固定値にはせず、操作パネルのスライダーで利用者が調整する値を
そのまま受け取る。
"""
v = shrink(img.max(axis=2), mw)
bright = (v > bright_th).astype(np.float32)
# 窓の一辺 (処理幅の5%) を、同程度の平滑化になるガウシアンの標準偏差に
# 換算する (矩形窓の分散 = 一辺^2/12 に基づく)
sigma = max(1.0, 0.05 * v.shape[1] / math.sqrt(12.0))
occupancy = cv2.GaussianBlur(bright, (0, 0), sigma)
t = np.clip((occupancy - low) / max(high - low, 1e-3), 0.0, 1.0)
glare = strength * bright * (t * t * (3.0 - 2.0 * t)) # smoothstepで滑らかに立ち上げ
gain = 1.0 - cv2.resize(glare, (img.shape[1], img.shape[0]),
interpolation=cv2.INTER_LINEAR)
return img * gain[..., None]
def tone_and_color(img, strength, sigma_frac, protect_from, target, wb_strength,
ema, dt, mw):
"""照明補正 (自己較正ガンマ + 明部保護) とホワイトバランスを、1枚の低解像度
ゲインマップに合成して適用する。
照明成分もホワイトバランス係数も低周波成分なので、縮小画像で求めて拡大して
も誤差は小さく、処理解像度での演算は1回の乗算だけで済む。sigma_frac は縮小
画像の幅に対する割合なので、解像度によらず同じ広さの照明推定になる。
冪指数は暗部を持ち上げる方向にのみ働く。Zero-DCE の出力を「暗いところが
残っている画素だけ、さらに持ち上げる」ために用い、target より明るい画素を
わざわざ暗く戻すことはしない (暗所を見やすくする目的に反するため)。
明部保護は増幅側にだけ掛ける。増幅を無条件にすると明るい画素まで
持ち上がって白飛びするため、そこだけは抑える。
"""
small = shrink(img, mw)
# 照明成分の推定: max(R,G,B) のガウシアン平滑化 (Retinex 系で用いる V 近似)
illum = np.clip(cv2.GaussianBlur(small.max(axis=2), (0, 0),
sigmaX=max(1.0, sigma_frac * small.shape[1])),
0.02, 1.0)
# 冪指数の算出で log(1.0)=0 による零除算を避けるため上限を 0.98 に抑える
mean_i = float(np.clip(ema("illum", float(illum.mean()), dt), 0.02, 0.98))
gamma = float(np.clip(np.log(target) / np.log(mean_i), 0.35, 1.45))
gain = np.clip(np.power(illum, gamma) / illum, 0.40, 6.0)
protect = np.clip((illum - protect_from) / (1.0 - protect_from), 0.0, 1.0)
lift = np.maximum(gain - 1.0, 0.0) * (1.0 - protect) # 増幅側は明部で抑える
gain = 1.0 + lift * strength
if wb_strength > 1e-3:
# 各チャネルの98パーセンタイルを白基準とする White-Patch 法の頑健版。
# Zero-DCE 側で色が中立化されているため、重ねがけによる色の振れを
# 避けるよう補正量の上下限を狭く取る
ref = np.percentile(small.reshape(-1, 3), 98.0, axis=0)
wb = 1.0 / np.maximum(ref, 0.05)
wb = wb / max(float(wb.mean()), 1e-6)
wb = np.float32([ema(f"wb{c}", float(wb[c]), dt) for c in range(3)])
wb = np.clip(1.0 + (wb - 1.0) * wb_strength, 0.85, 1.20)
else:
wb = np.float32([1.0, 1.0, 1.0])
gain = cv2.resize(gain[..., None] * wb, (img.shape[1], img.shape[0]),
interpolation=cv2.INTER_LINEAR)
return np.clip(img * gain, 0.0, 1.0)
def sharpen(y, amount, threshold):
"""しきい値付きアンシャープマスク。
高周波成分のうち振幅が threshold 以下の成分 (主に残留ノイズ) を差し引いて
から強調するため、輪郭や文字だけが立ち、粒状ノイズは増幅されない。
標準偏差は 1.1 画素に固定する。強調したいのは最も細かい構造 (文字の輪郭)
であり、これは解像度によらず数画素の現象だからである。
"""
d = y.astype(np.float32) - cv2.GaussianBlur(y, (0, 0), 1.1)
d -= np.clip(d, -threshold, threshold)
return np.clip(y + d * amount, 0.0, 255.0).astype(np.uint8)
def apply_tone(y, cr, cb, contrast, saturation):
"""明部だけを締めるトーンカーブ (輝度) と彩度を適用する。
暗部を暗く戻す処理 (黒レベル復元・S字トーンの下側成分) は、元の画像の
情報を失わずに暗所を見やすくするという目的に反するため行わない。ここでは
contrast を、中間調より明るい領域だけを上に凸に持ち上げてメリハリを
付ける片側の補正としてのみ使う。暗部側 (t<0.5) は恒等のままなので、
暗部の階調がこの段で圧縮されることはない。
トーンカーブで Y を変えたら、色差 Cr,Cb にも同じ比を掛ける。YCrCb では彩度が
輝度に対する相対量であり、Y だけを上げると彩度比が下がって色が薄く見える
ためである。比は 1 以下に制限する。1 を超える持ち上げに追随させると
増幅された色ノイズも一緒に強まるうえ、飽和付近で色が破綻するからである。
この段は浮動小数で計算し、8bit の LUT による 2 度目の量子化を避ける。
"""
if contrast <= 1e-3:
if abs(saturation - 1.0) > 1e-3:
lut = np.clip((np.arange(256, dtype=np.float32) - 128.0) * saturation
+ 128.0, 0, 255).astype(np.uint8)
cr, cb = cv2.LUT(cr, lut), cv2.LUT(cb, lut)
return y, cr, cb
yf = y.astype(np.float32)
t = np.clip(yf / 255.0, 0.0, 1.0)
lift = contrast * np.maximum(t - 0.5, 0.0) * (1.0 - t) * 2.0 # 明部側だけ持ち上げ
t = t + lift
y2 = t * 255.0
ratio = np.clip(y2 / np.maximum(yf, 1.0), 0.0, 1.0) * saturation
cr = np.clip(128.0 + (cr.astype(np.float32) - 128.0) * ratio + 0.5, 0, 255)
cb = np.clip(128.0 + (cb.astype(np.float32) - 128.0) * ratio + 0.5, 0, 255)
return (np.clip(y2 + 0.5, 0, 255).astype(np.uint8),
cr.astype(np.uint8), cb.astype(np.uint8))
def finish(bgr, denoise, clahe_clip, sharp, contrast, saturation, clahe):
"""YCrCb 空間で仕上げる: ノイズ低減 → CLAHE → 輪郭強調 → 階調・彩度。
色差 (Cr, Cb) は縮小して平滑化する。暗部伸張で最も目立つのは色ノイズであり、
かつ人の視覚は色の空間解像度が輝度より低いため、色の解像度低下は知覚され
にくい。ただし縮小率と平滑化を強くし過ぎると、増幅された色ノイズが平均化
されて消えるのではなく大きな色斑に育つため、1/2 縮小に抑える。輝度 (Y) は
エッジ保存平滑化で弱く処理し、文字の輪郭を残す。
ここで使う窓と標準偏差は絶対画素尺度である。読み出しノイズとショットノイズは
画素単位の現象で画像の大きさに比例しないため、高解像度でも同じ画素数の窓で
処理するのが正しい。窓を解像度に比例させると計算量が二乗で増え、本来残せる
細部も失われる。その結果、高解像度では画面全体に対する効果が相対的に穏やかに
見える。CLAHE のタイル分割は画像を 8x8 に割る相対的な指定である。
"""
y, cr, cb = cv2.split(cv2.cvtColor(bgr, cv2.COLOR_BGR2YCrCb))
if denoise > 0.01:
# バイラテラルフィルタ (エッジ保存平滑化)
y = cv2.bilateralFilter(y, 7 if denoise > 0.45 else 5,
12 + 55 * denoise, 6)
h, w = y.shape
small = (max(2, w // 2), max(2, h // 2))
for ch in (cr, cb):
blurred = cv2.GaussianBlur(
cv2.resize(ch, small, interpolation=cv2.INTER_AREA),
(0, 0), 0.5 + 0.7 * denoise)
ch[:] = cv2.resize(blurred, (w, h), interpolation=cv2.INTER_LINEAR)
if clahe_clip > 0.1:
# CLAHE: コントラスト制限付き適応ヒストグラム平坦化。
# 夜間映像では強くかけるとヒストグラムが一様化して灰色の霧のようになる
clahe.setClipLimit(clahe_clip)
y = clahe.apply(y)
if sharp > 0.01:
y = sharpen(y, sharp, 2 + 14 * denoise)
y, cr, cb = apply_tone(y, cr, cb, contrast, saturation)
return cv2.cvtColor(cv2.merge((y, cr, cb)), cv2.COLOR_YCrCb2BGR)
# ----------------------------------------------------------------------------
# シーン解析 (自動パラメータ推定と屋外/屋内の判定)
# ----------------------------------------------------------------------------
# Immerkær のマスク。i.i.d. ノイズに対する応答の標準偏差は 6σ になる
_NOISE_KERNEL = np.float32([[1, -2, 1], [-2, 4, -2], [1, -2, 1]])
def noise_sigma_of(img):
"""加法性ノイズの標準偏差 σ (画素値を 0-1 に正規化した単位) を推定する。
マスク応答の絶対値の中央値を用いる中央値版で、テクスチャや輪郭の影響を
受けにくい。ガウス分布では中央値 = 0.6745 * 6σ = 4.047σ の関係がある。
ノイズは平均化すると消えるため、必ず与えられた画像をそのままの解像度で
使い、3 か所の小片だけを見る。境界処理の偏りを避けるため応答の外周 1 画素を
除外する。BGR でも単チャネルでも受け取れる。
"""
h, w = img.shape[:2]
n = min(128, h, w)
if n < 16:
return 0.0
resp = []
for y, x in ((0, 0), ((h - n) // 2, (w - n) // 2), (h - n, w - n)):
patch = img[y:y + n, x:x + n]
if patch.ndim == 3:
patch = cv2.cvtColor(patch, cv2.COLOR_BGR2GRAY)
resp.append(np.abs(cv2.filter2D(patch.astype(np.float32), -1,
_NOISE_KERNEL))[1:-1, 1:-1])
return float(np.median(np.concatenate([r.ravel() for r in resp]))) \
/ (4.047 * 255.0)
class SceneAnalyzer:
"""フレーム統計からシーン種別と各強度の推奨値を推定する。"""
def __init__(self, ema):
self.ema = ema
self.outdoor = False
def reset(self):
self.outdoor = False
def analyze(self, bgr, dt, raw=None, trim=1.0):
"""bgr は処理解像度のフレーム、raw は縮小前の原画 (無ければ None)。"""
gray = cv2.cvtColor(bgr, cv2.COLOR_BGR2GRAY) # BT.601 の輝度成分
small = to_float(shrink(gray, 192))
p1, p90, p99 = (float(np.percentile(small, p)) for p in (1, 90, 99))
# ノイズ標準偏差は処理解像度と原解像度の両方から推定し、大きい方を採る。
# 縮小はノイズを平均化するので処理解像度での値が本来の入力量である一方、
# 再標本化でノイズに空間相関が生じるとマスク応答が小さくなり過小評価に
# なる。原解像度からの値は、白色ノイズの仮定のもと幅の比で換算する。
sigma_now = noise_sigma_of(gray)
if raw is not None and raw.shape[1] > bgr.shape[1]:
sigma_now = max(sigma_now,
noise_sigma_of(raw) * bgr.shape[1] / raw.shape[1])
sigma = self.ema("sigma", sigma_now, dt)
# 暗部指標: 平均輝度と90パーセンタイルから作った 0-1 の無次元指標
darkness = self.ema("dark", float(np.clip(
1.0 - (0.6 * float(small.mean()) / 0.45 + 0.4 * p90 / 0.85),
0.0, 1.0)), dt)
noise = float(np.clip((sigma - 0.004) / 0.030, 0.0, 1.0))
edge = self.ema("edge", float(cv2.Canny(
(small * 255).astype(np.uint8), 50, 150).mean()) / 255.0, dt)
# 補正の必要度。明るくノイズも無い映像では 0 になり、入力をそのまま表示する
need = float(np.clip(1.6 * darkness + 1.2 * noise, 0.0, 1.0))
# 屋外らしさ: 街灯や前照灯のような孤立した高輝度画素の有無と輝度レンジ。
# 夜間の空は街明かりで色付くため、色相に基づく判定は行わない。
outdoorness = self.ema("outdoor", float(
0.65 * np.clip((p99 - p90) / 0.30, 0.0, 1.0)
+ 0.35 * np.clip((p99 - p1) / 0.75, 0.0, 1.0)), dt)
if outdoorness > 0.60: # ヒステリシスで判定の往復を防ぐ
self.outdoor = True
elif outdoorness < 0.42:
self.outdoor = False
return {
"darkness": darkness,
"noise": noise,
"sigma": sigma,
"auto_scene": 1 if self.outdoor else 2,
# trim は飽和率に基づく引き下げ係数 (NightVisionPipeline が更新する)
"auto_strength": int(round(100 * darkness * trim)),
"auto_denoise": int(round(100 * need * np.clip(
0.12 + 0.75 * noise + 0.35 * darkness, 0.0, 1.0))),
"auto_detail": int(round(100 * need * np.clip(
0.30 + 1.6 * edge, 0.0, 1.0))),
}
# ----------------------------------------------------------------------------
# 処理パイプライン
# ----------------------------------------------------------------------------
# シーン別の後処理設定
# illum : 照明補正の強さ sigma : 照明推定の広さ (小さいほど局所的)
# protect : 明部保護を始める輝度 target : 照明成分の目標平均 (暗部の持ち上げ量の目安)
# knee : 混合率が 0 になる明度 wb : ホワイトバランスの強さ
# hue : 色度を入力へ引き戻す割合
# clahe : 局所コントラスト sharp : 輪郭強調 dn_floor: ノイズ低減の下限
# contrast: 明部を締める強さ (暗部は変化しない) sat : 彩度の増分
# glare : 面積が広く明るい光源を抑える強さの、シーンごとの倍率 (0で無効)。
# 操作パネルの glare スライダーに掛けて使う。暗部復元の強弱
# (strength) とは独立して働く
# glare_range: 検出のしきい値 (low, high)。近傍占有率 (0〜1、明るい画素が
# 周囲でどれだけ密集しているか) が low 未満では働かず、
# high 以上で最大の減光になる。何を「明るい」とするかは
# 操作パネルの bright_th スライダーが別に決める
#
# 暗所を見やすくすることを最優先し、暗部を暗く戻す処理は行わない。knee は
# 点光源の飽和を防ぐための値、protect は明部保護の起点であり、いずれも情報を
# 失わないための下限側の制御として残す。ホワイトバランスは屋外で 0 にしている。
# Zero-DCE は色チャネル間の偏りを抑えるよう学習されており、その出力へ
# White-Patch 法を重ねると暖色光源の多い夜景で補色側 (青緑) へ振れるためである。
# 屋内は照明の色かぶりが実在するので中程度に効かせる。hue は屋外で大きく取る。
# 夜景は暗部の面積が広く、チャネル別カーブの不均衡がそのまま全体の色かぶりと
# して見えるためである。文字・書類は色を残す必要が薄いので最も大きくし、
# 彩度の増分は 0 にする。
# glare はスライダーで指定した強さに対する、シーンごとの倍率である。対向車の
# ヘッドライトのように面積を持って明るい光源が主に現れる屋外シーンでは倍率を
# そのまま (1 に近い値) にし、屋内は同様の強い面光源が生じにくいため弱め、
# 文字・書類は被写体として光源そのものを想定していないため無効にする。
# 光源かどうかの見分け (どこまでを「明るい」とみなすか) はスライダーの
# bright_th が担い、雲や壁のような自然物との切り分けは利用者が素材を見ながら
# 調整する。しきい値による二値判定である以上、誤検出や検出漏れを完全には
# 避けられないため、strength の既定値は誤って働いた場合でも被害が大きくなり
# 過ぎない範囲にとどめる。
SCENE_PARAMS = {
1: dict(illum=0.60, sigma=0.16, protect=0.55, target=0.34, knee=0.50, wb=0.00,
hue=0.65, clahe=(0.45, 0.55), sharp=(0.25, 0.55), dn_floor=0.00,
contrast=0.55, sat=0.04, glare=1.00, glare_range=(0.30, 0.65)),
2: dict(illum=0.70, sigma=0.07, protect=0.72, target=0.45, knee=0.62, wb=0.45,
hue=0.45, clahe=(0.60, 0.70), sharp=(0.35, 0.65), dn_floor=0.00,
contrast=0.40, sat=0.12, glare=0.55, glare_range=(0.30, 0.65)),
3: dict(illum=0.85, sigma=0.05, protect=0.80, target=0.52, knee=0.70, wb=0.45,
hue=0.80, clahe=(1.40, 1.80), sharp=(0.55, 0.95), dn_floor=0.45,
contrast=0.35, sat=0.00, glare=0.00, glare_range=(0.30, 0.65)),
}
class NightVisionPipeline:
"""入力段のノイズ低減 → 暗部伸張 → 階調・色 → 仕上げ、の順に処理する。"""
def __init__(self, parent):
self.model = ZeroDCE(parent)
self.ema = Ema()
self.analyzer = SceneAnalyzer(self.ema)
self.temporal = TemporalDenoiser()
# CLAHE のインスタンスは使い回す (毎フレーム生成しない)。大域で共有すると
# クリップ値の書き換えが競合するため、パイプラインごとに持つ
self.clahe = cv2.createCLAHE(tileGridSize=(8, 8))
self.trim = 1.0
def reset(self):
self.ema.reset()
self.analyzer.reset()
self.temporal.reset()
self.model.reset()
self.trim = 1.0
def feedback(self, sat_in, sat_out):
"""出力の飽和率が入力より増えすぎている間、暗部復元の強度を引き下げる。
自動推定の強度は暗部指標だけから決まるため、画面全体が暗い夜間映像では
上限に張り付き、白飛びが増えて明部の情報が失われる。
不感帯を置いた緩い積分制御なので、振動せずに収束する。
"""
if sat_out > sat_in + 0.002:
self.trim = max(0.35, self.trim - 0.06)
elif sat_out < sat_in + 0.0005:
self.trim = min(1.0, self.trim + 0.015)
def process(self, frame, scene, strength, denoise, detail, dt=1.0 / 30.0,
raw=None, temporal=True, fixed=None, neighbors=None,
glare_gain=0.45, bright_th=0.85):
"""1 フレームを処理する。
dt : 直前のフレームからの経過時間 [s] (時定数の正規化に使う)
raw : 縮小前の原画 (ノイズ推定に使う。無ければ frame だけで推定)
temporal : 再帰型の時間方向ノイズ低減を使うか
fixed : シーン統計を固定する (書き出しの 2 パス目。解析を省く)
neighbors : 双方向ノイズ低減に使う前後フレーム (frame が中央)
glare_gain : 面積の広い高輝度光源を抑える強さ (操作パネルのスライダー)
bright_th : 光源とみなす明度のしきい値 (操作パネルのスライダー)
"""
mw = map_width(frame.shape[1])
stats = dict(fixed) if fixed is not None else \
self.analyzer.analyze(frame, dt, raw, self.trim)
if scene == 0:
scene = stats["auto_scene"]
p = SCENE_PARAMS[scene]
denoise = max(denoise, p["dn_floor"] * strength)
if strength < 0.02 and denoise < 0.02 and detail < 0.02:
# 補正不要な入力はそのまま返す
self.temporal.reset()
stats["motion"] = 0.0
return frame, stats, scene
base = to_float(frame)
motion = 0.0
if neighbors:
img = window_denoise(base, neighbors, denoise, stats["sigma"], mw)
elif temporal:
img, motion = self.temporal(base, denoise, stats["sigma"], dt, mw)
else:
img = base
stats["motion"] = motion
# 画面全体が動く映像では時間方向のノイズ低減が効かないので、その分だけ
# 空間方向を強める
dn_space = float(min(1.0, denoise * (1.0 + 0.6 * motion)))
if strength > 0.02:
ai = preserve_hue(self.model(img, dt), img, p["hue"])
# 混合は画素別。明るい画素は入力を残すので、強度が 1 でも点光源は守られる
m = blend_mask(img, strength, p["knee"], mw)
img = np.clip(img * (1.0 - m) + ai * m, 0.0, 1.0)
img = tone_and_color(img, p["illum"] * strength, p["sigma"],
p["protect"], p["target"], p["wb"] * strength,
self.ema, dt, mw)
if p["glare"] > 1e-3 and glare_gain > 1e-3:
# 対向車のヘッドライト発光面のように面積を持って明るい光源は
# 内部の階調を保っても情報にならず、むしろ暗部の諧調をハレー
# ションで覆い隠すため、点光源は守ったまま本体だけ減光する。
# 暗部復元の強弱 (strength) とは無関係に働かせる。連動させると
# 暗部復元を弱めたときに光源抑制まで弱まってしまうためである。
img = np.clip(suppress_glare(img, p["glare"] * glare_gain,
bright_th, *p["glare_range"], mw),
0.0, 1.0)
out = finish(to_uint8(img), dn_space,
(p["clahe"][0] + p["clahe"][1] * strength)
* (0.35 + 0.65 * detail),
p["sharp"][0] + p["sharp"][1] * detail,
p["contrast"] * strength, 1.0 + p["sat"] * strength,
self.clahe)
return out, stats, scene
# ----------------------------------------------------------------------------
# 評価用 低照度シミュレーション
# ----------------------------------------------------------------------------
class LowLightSimulator:
"""入力を擬似的な低照度撮影に変換する (効果確認用)。
γ=2.2 の逆変換で近似的に線形化し、露光量を EXPOSURE 倍に下げ、分散が信号に
比例する光ショットノイズと、信号に依存しない読み出しノイズを加えて再び
γ 符号化する。低照度撮影と同種の劣化 (暗部の S/N 低下と量子化) を再現する
が、特定の撮像素子の較正値ではない。ノイズはチャネル間で共通とし、輝度
ノイズとして近似する。
"""
EXPOSURE = 0.12 # 露光量の倍率
FULL_WELL = 8000.0 # 線形信号 1.0 に相当する光電子数 (ショットノイズ量を決める)
READ_NOISE = 6e-4 # 読み出しノイズの標準偏差 (線形信号の単位)
def __init__(self, seed=0):
self.rng = np.random.default_rng(seed)
self._decode = (np.arange(256, dtype=np.float32) / 255.0) ** 2.2
def __call__(self, frame):
lin = self._decode[frame] * self.EXPOSURE
sigma = np.sqrt(lin / self.FULL_WELL + self.READ_NOISE ** 2)
noise = self.rng.standard_normal(frame.shape[:2], dtype=np.float32)[..., None]
lin = np.clip(lin + sigma * noise, 0.0, 1.0)
return (cv2.pow(lin, 1.0 / 2.2) * 255.0 + 0.5).astype(np.uint8)
# ----------------------------------------------------------------------------
# 入力 (カメラ / 動画ファイル / デモ映像)
# ----------------------------------------------------------------------------
class VideoSource:
"""カメラと動画ファイルの共通ラッパ。動画ファイルは末尾で先頭へ戻る。"""
def __init__(self, cap, name, is_live, path=None):
self.cap = cap
self.name = name
self.is_live = is_live
self.path = path
fps = cap.get(cv2.CAP_PROP_FPS)
# カメラや一部のコンテナはフレームレートを報告しないため 30 を既定値とする
self.fps = fps if 1.0 < fps <= 240.0 else 30.0
def read(self):
ok, frame = self.cap.read()
if not ok and not self.is_live:
self.cap.set(cv2.CAP_PROP_POS_FRAMES, 0)
ok, frame = self.cap.read()
return frame if ok else None
def skip(self, count):
"""復号結果を取り出さずにフレームを読み飛ばす (実時間優先の再生で使う)。"""
dropped = 0
for _ in range(int(count)):
if not self.cap.grab():
break
dropped += 1
return dropped
def release(self):
self.cap.release()
def open_camera(index):
"""指定番号のカメラを 1 回だけ開き、1 フレーム取得できたら採用する。
起動時に番号を総当たりで開くと、存在しない番号ごとにバックエンドの
応答待ちが発生して画面表示が遅れる。そのため列挙は行わず、利用者が
指定した番号だけを開き、その接続をそのまま再生に使う (開き直さない)。
それでも DirectShow の初期化自体に数秒かかる機器はある。
BUFFERSIZE の指定は効果がバックエンド依存で、無視される場合もある。
"""
cap = cv2.VideoCapture(index, cv2.CAP_DSHOW) # Windows では開始が速い
cap.set(cv2.CAP_PROP_FRAME_WIDTH, 1280)
cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 720)
cap.set(cv2.CAP_PROP_BUFFERSIZE, 1)
if not (cap.isOpened() and cap.read()[0]):
cap.release()
return None
return VideoSource(cap, f"カメラ {index}", True)
def open_file(path, name=None):
"""動画を開き、先頭フレームを復号できたときだけ VideoSource を返す。"""
cap = cv2.VideoCapture(path)
if not (cap.isOpened() and cap.read()[0]):
cap.release()
return None
cap.set(cv2.CAP_PROP_POS_FRAMES, 0)
return VideoSource(cap, name or os.path.basename(path), False, path)
def choose_source(root):
"""入力を選ぶダイアログ。選ばれた VideoSource を返す。
ウィンドウを閉じた場合は None を返し、呼び出し側はプログラムを終了する。
このダイアログは表示するだけではカメラや動画に触れないため、即座に開く。
root は withdrawn なので transient を設定してはならない。transient は
初回マップ時に親の状態を継承するため、設定すると本ダイアログが非表示の
まま開き、wait_window で待ち続けて「起動しても画面が出ない」状態になる。
"""
state = {"source": None}
win = tk.Toplevel(root)
win.title("入力の選択")
win.resizable(False, False)
pad = dict(padx=20, pady=5)
tk.Label(win, text="入力を選んでください", font=(UI_FONT, 14, "bold")
).pack(anchor="w", padx=20, pady=(18, 2))
tk.Label(win, justify="left", font=(UI_FONT, 9), fg="#444",
text="学習済み CNN (Zero-DCE) と後処理で暗部を復元し、比較しながら\n"
"強度を調整できます。動画ファイルを選ぶと、元解像度・全フレームで\n"
"書き出すこともできます。このウィンドウを閉じると終了します。"
).pack(anchor="w", **pad)
note = tk.StringVar(value="")
def accept(source, failure, discard=None):
if source is None:
note.set(failure)
if discard is not None and os.path.exists(discard):
os.remove(discard)
return
state["source"] = source
win.destroy()
row = tk.Frame(win)
row.pack(anchor="w", **pad)
tk.Label(row, text="カメラ番号", font=(UI_FONT, 10)).pack(side="left")
index = tk.Spinbox(row, from_=0, to=8, width=3, font=(UI_FONT, 10))
index.delete(0, "end")
index.insert(0, "0")
index.pack(side="left", padx=6)
def use_camera():
number = int(index.get()) if index.get().strip().isdigit() else 0
# 接続に数秒かかる機器があるため、開く前に状態を描画しておく
note.set(f"カメラ {number} を開いています...")
win.update_idletasks()
accept(open_camera(number),
f"カメラ {number} からフレームを取得できませんでした。"
"番号を変えるか、他のアプリがカメラを使用していないか確認してください。")
tk.Button(row, text="カメラを使う", width=16, font=(UI_FONT, 10),
command=use_camera).pack(side="left")
def use_file():
path = filedialog.askopenfilename(
title="動画ファイルを選択", parent=win,
filetypes=[("動画ファイル", VIDEO_EXT), ("すべてのファイル", "*.*")])
if path:
accept(open_file(path),
"この動画は復号できませんでした。別のファイルを選んでください。")
def use_demo():
if not os.path.exists(DEMO_PATH):
try:
download(DEMO_URL, DEMO_PATH, win, "デモ映像の取得",
"デモ映像 (夜間の街路 / Pixabay 公開素材) を取得しています。\n"
"2 回目以降の起動ではダウンロードしません。")
except Exception as exc: # 通信失敗でも操作を続けられるようにする
note.set(f"デモ映像を取得できませんでした: {exc}")
return
accept(open_file(DEMO_PATH, DEMO_NAME),
"デモ映像を復号できませんでした。もう一度押すと再取得します。",
DEMO_PATH)
tk.Button(win, text="動画ファイルを選ぶ...", width=34, font=(UI_FONT, 10),
command=use_file).pack(anchor="w", **pad)
tk.Button(win, text="デモ映像を見る (初回のみダウンロード)", width=34,
font=(UI_FONT, 10), command=use_demo).pack(anchor="w", **pad)
tk.Label(win, textvariable=note, font=(UI_FONT, 9), fg="#a04000",
justify="left", wraplength=330).pack(anchor="w", padx=20, pady=(2, 16))
if root.winfo_viewable(): # withdrawn な親には transient を設定しない
win.transient(root)
center_window(win) # update_idletasks でマップされる
win.grab_set() # マップ後に掴む
root.wait_window(win)
return state["source"]
# ----------------------------------------------------------------------------
# 保存
# ----------------------------------------------------------------------------
def new_writer(size, fps, tag="enhanced"):
"""書き込み先を開く。CODECS の順に試し、開けた方式を使う。
どの符号化方式が使えるかは OpenCV の構成に依存するため、実際に開けるか
どうかで判断し、使った方式は呼び出し側で表示する。音声は扱えない。
"""
path = os.path.join(SCRIPT_DIR, time.strftime(f"{tag}_%Y%m%d_%H%M%S.mp4"))
for name in CODECS:
writer = cv2.VideoWriter(path, cv2.VideoWriter_fourcc(*name), fps, size)
if writer.isOpened():
return writer, path, name
writer.release()
raise RuntimeError(
f"書き込み先を作成できません: {path}\n"
"保存先に書き込めない場合や、パスに非ASCII文字が含まれる場合に"
"起こります。")
def save_image(image, tag):
"""静止画を保存する。
cv2.imwrite は Windows で非ASCIIのパスに書けない場合がある (ファイル名の
符号化が合わない既知の問題) ため、符号化してから Python 側で書き出す。
"""
path = os.path.join(SCRIPT_DIR, time.strftime(f"{tag}_%Y%m%d_%H%M%S.png"))
ok, buf = cv2.imencode(".png", image)
if not ok:
raise RuntimeError("画像を PNG に符号化できませんでした")
buf.tofile(path)
return path
# ----------------------------------------------------------------------------
# 元解像度での書き出し (2 パス・双方向ノイズ低減)
# ----------------------------------------------------------------------------
class Progress:
"""書き出しの進捗窓。中止ボタンを持ち、閉じるボタンでは消えない。"""
def __init__(self, parent, title):
self.win = tk.Toplevel(parent)
self.win.title(title)
self.win.resizable(False, False)
self.win.protocol("WM_DELETE_WINDOW", self.cancel)
self.cancelled = False
self.text = tk.StringVar(value="")
tk.Label(self.win, textvariable=self.text, font=(UI_FONT, 10),
justify="left", anchor="w", width=56, height=3
).pack(padx=22, pady=(16, 6))
self.bar = ttk.Progressbar(self.win, length=420, maximum=1000.0)
self.bar.pack(padx=22)
tk.Button(self.win, text="中止", width=12, font=(UI_FONT, 10),
command=self.cancel).pack(pady=(10, 16))
if parent.winfo_viewable():
self.win.transient(parent)
center_window(self.win)
self.win.grab_set()
self.win.update()
def cancel(self):
self.cancelled = True
def update(self, ratio, message):
self.bar["value"] = 1000.0 * float(np.clip(ratio, 0.0, 1.0))
self.text.set(message)
self.win.update()
def close(self):
try:
self.win.grab_release()
except tk.TclError:
pass
self.win.destroy()
def _read_fit(cap):
"""1 フレーム復号し、縦横を偶数にして返す (符号化の前提に合わせる)。"""
ok, raw = cap.read()
return fit_frame(raw, raw.shape[1]) if ok else None
def _survey(cap, pipe, fps, progress, samples=120):
"""1 パス目。ファイル全体から統計を集め、固定する強度の候補を決める。
復号は全フレームに対して行うが、統計の算出は一定間隔の標本だけで行うため
費用は小さい。中央値を採るので、一部の明るい場面に引きずられない。
調整用に代表フレームを 3 枚だけ保持する。
"""
total = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
step = max(1, total // samples) if total > 0 else 30
dark, sig, st, dn, dt = [], [], [], [], []
outdoor, probes, i = 0, [], 0
while True:
if i % step == 0:
frame = _read_fit(cap)
if frame is None:
break
s = pipe.analyzer.analyze(frame, step / fps, None, 1.0)
dark.append(s["darkness"])
sig.append(s["sigma"])
st.append(s["auto_strength"])
dn.append(s["auto_denoise"])
dt.append(s["auto_detail"])
outdoor += 1 if s["auto_scene"] == 1 else 0
if len(dark) in (20, 60, 100) and len(probes) < 3:
probes.append(frame.copy())
elif not cap.grab():
break
i += 1
if i % (step * 4) == 0:
progress.update(0.12 * i / total if total > 0 else 0.0,
"1/3 ファイル全体の統計を測定中\n"
f"{i} / {total if total > 0 else '?'} フレーム")
if progress.cancelled:
return None, []
if not dark:
return None, []
return {
"darkness": float(np.median(dark)),
"sigma": float(np.median(sig)),
"noise": 0.0,
"motion": 0.0,
"auto_scene": 1 if outdoor * 2 >= len(dark) else 2,
"strength": float(np.median(st)) / 100.0,
"denoise": float(np.median(dn)) / 100.0,
"detail": float(np.median(dt)) / 100.0,
}, probes
def _refine(pipe, probes, fixed, scene, strength, denoise, detail, fps, progress,
glare_gain=0.45, bright_th=0.85):
"""代表フレームで出力の飽和率を実測し、入力より増えすぎない強度に確定する。
自動推定の強度は暗部指標だけから決まるため、夜間映像では上限に張り付き、
白飛びが増えて明部の情報が失われる。書き出しでは全フレームに同じ強度を
適用するので、事前にここで確定させる。
"""
if not probes:
return strength, 0.0
over = 0.0
for attempt in range(5):
over = 0.0
for f in probes:
out, _s, _c = pipe.process(f, scene, strength, denoise, detail,
dt=1.0 / fps, fixed=fixed, temporal=False,
glare_gain=glare_gain, bright_th=bright_th)
over = max(over, luminance_profile(out)[1] - luminance_profile(f)[1])
progress.update(0.12 + 0.012 * (attempt + 1),
"2/3 強度の調整中\n"
f"暗部復元の強度 {strength * 100:.0f}% / "
f"飽和率の増分 {over * 100:.2f} ポイント")
if progress.cancelled or over <= 0.002 or strength <= 0.2:
break
strength = max(0.2, strength - 0.1)
pipe.temporal.reset()
pipe.model.reset()
pipe.ema.reset()
return strength, over
def export_video(root, source_path, display_name, pipe, scene_choice,
glare_gain=0.45, bright_th=0.85):
"""動画ファイルを元解像度・元フレームレート・全フレームで書き出す。
戻り値は利用者への報告文である。処理は次の順で行う。
1. 先頭フレームで 1 フレームあたりの処理時間を実測し、所要時間を提示して
続行の確認を取る
2. ファイル全体の統計から強度を決め、代表フレームで飽和率を見て確定する
3. 前後 1 フレームを使う双方向ノイズ低減と本処理を行い、書き出す
音声は cv2.VideoWriter では扱えないため含まれない。glare_gain と
bright_th は、書き出し開始時点で操作パネルのスライダーが示していた値を
そのまま使う (プレビューと同じ見え方にするため)。
"""
cap = cv2.VideoCapture(source_path)
if not cap.isOpened():
return f"書き出しのために開けませんでした: {source_path}"
total = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
fps = cap.get(cv2.CAP_PROP_FPS)
fps = fps if 1.0 < fps <= 240.0 else 30.0
first = _read_fit(cap)
if first is None:
cap.release()
return "先頭フレームを復号できませんでした。"
full_prev = pipe.model.full
pipe.model.set_full(True)
pipe.reset()
h, w = first.shape[:2]
try:
# 1 回目は割り当てなどの初期費用を含むため、2 回目の時間を採る
for _ in range(2):
t0 = time.perf_counter()
pipe.process(first, scene_choice, 0.6, 0.4, 0.5, dt=1.0 / fps,
temporal=False)
ms = (time.perf_counter() - t0) * 1000.0
except RuntimeError as exc:
cap.release()
pipe.model.set_full(full_prev)
pipe.reset()
return str(exc)
frames = total if total > 0 else int(fps * 60)
est_min = ms * frames * 1.3 / 60000.0
proceed = messagebox.askokcancel(
"元解像度で書き出す",
f"{display_name}\n\n"
f"出力解像度 : {w} x {h} px\n"
f"フレーム数 : {frames}{'' if total > 0 else ' (推定)'}\n"
f"フレームレート : {fps:.2f} fps\n"
f"1 フレームの処理時間 (実測) : {ms:.0f} ms\n"
f"所要時間の目安 : 約 {est_min:.1f} 分\n"
f"係数マップの推定: {pipe.model.describe()}\n\n"
"・全フレームを処理するため、再生時間より長くかかります\n"
"・音声は含まれません\n"
"・書き出し中は映像ウィンドウは更新されません\n"
"・途中で中止でき、そこまでの内容が保存されます")
if not proceed:
cap.release()
pipe.model.set_full(full_prev)
pipe.reset()
return "書き出しを取りやめました。"
progress = Progress(root, "元解像度で書き出し中")
writer, path, codec, done = None, "", "", 0
try:
pipe.reset()
cap.set(cv2.CAP_PROP_POS_FRAMES, 0)
fixed, probes = _survey(cap, pipe, fps, progress)
if fixed is None:
return "書き出しを中止しました。"
strength = fixed.pop("strength")
denoise = fixed.pop("denoise")
detail = fixed.pop("detail")
scene = scene_choice if scene_choice else fixed["auto_scene"]
strength, over = _refine(pipe, probes, fixed, scene, strength, denoise,
detail, fps, progress)
if progress.cancelled:
return "書き出しを中止しました。"
cap.set(cv2.CAP_PROP_POS_FRAMES, 0)
writer, path, codec = new_writer((w, h), fps, "export")
# 前後 1 フレームを使うため、prev/cur/nxt を滑らせる。各フレームは
# ちょうど 1 回、入力順に書き出される
prev, cur, nxt = None, _read_fit(cap), _read_fit(cap)
t_start = time.perf_counter()
while cur is not None and not progress.cancelled:
if cur.shape[:2] != (h, w): # 途中で解像度が変わる素材への備え
cur = cv2.resize(cur, (w, h), interpolation=cv2.INTER_AREA)
neighbors = [f for f in (prev, nxt) if f is not None
and f.shape == cur.shape]
out, _s, _c = pipe.process(cur, scene, strength, denoise, detail,
dt=1.0 / fps, fixed=fixed,
neighbors=neighbors,
glare_gain=glare_gain, bright_th=bright_th)
writer.write(out)
done += 1
prev, cur, nxt = cur, nxt, _read_fit(cap)
if done % 5 == 0 or cur is None:
elapsed = time.perf_counter() - t_start
rate = done / max(elapsed, 1e-3)
left = max(frames - done, 0) / max(rate, 1e-3)
progress.update(0.18 + 0.82 * done / max(frames, 1),
f"3/3 書き出し中 {done} / {frames} フレーム\n"
f"経過 {elapsed / 60.0:.1f} 分 / 残り "
f"約 {left / 60.0:.1f} 分\n"
f"{w}x{h} {codec} 強度 {strength * 100:.0f}%")
except Exception as exc:
return f"書き出し中に問題が起きました ({done} フレームまで保存): {exc}"
finally:
if writer is not None:
writer.release()
cap.release()
cancelled = progress.cancelled
progress.close()
pipe.model.set_full(full_prev)
pipe.reset()
return (f"書き出しを{'中止しました' if cancelled else '完了しました'} "
f"({done} フレーム, {w}x{h}, {codec}, 音声なし)\n"
f"暗部復元の強度 {strength * 100:.0f}% / 飽和率の増分 "
f"{over * 100:.2f} ポイント\n{path}")
# ----------------------------------------------------------------------------
# 操作パネル (Tkinter)
# ----------------------------------------------------------------------------
class ControlPanel:
"""映像ウィンドウとは別に常時表示する操作パネル。"""
SLIDERS = (("strength", "暗部復元の強度 α [%] (暗部での Zero-DCE 混合率の上限。"
"明部は入力を残します)", 60),
("denoise", "ノイズ低減の強度 [%] (時間方向 + 空間方向)", 40),
("detail", "輪郭・局所コントラスト強調の強度 [%]", 50),
("glare", "面積の広い高輝度光源を抑える強さ [%] (0で無効。"
"対向車のヘッドライト等の肥大・にじみを抑えます)", 45),
("bright_th", "光源とみなす明度のしきい値 [%] (下げるほど検出が"
"広がりますが、明るい雲や壁を誤って暗くする"
"おそれが増します)", 85))
TOGGLES = (("compare", "並置比較を表示 (境界は映像上を左ドラッグ)", True),
("graph", "輝度ヒストグラムを表示", True),
("simulate", "評価用 低照度シミュレーションを入力に適用", False),
("paused", "一時停止 (停止中も強度の変更は反映される)", False))
QUALITY = ("速度優先 (処理幅の上限あり。録画・静止画もこの解像度)",
"品質優先 (入力の解像度のまま処理。係数マップは 1280px 以下で推定)")
PACING = ("実時間優先 (間に合わない分はフレームを間引く)",
"全フレーム処理 (間引かない。低速再生になる)")
DEFINITIONS = (
"推定ノイズ標準偏差 σ̂ : 入力画素値 (0-1 に正規化) に対する加法性ノイズの"
"標準偏差。Immerkær のマスク応答の中央値から、縮小前と縮小後の両方で"
"推定した大きい方の値です。",
"暗部指標 : 平均輝度と輝度の 90 パーセンタイルから作った 0 (明るい) - "
"1 (暗い) の無次元指標で、照度や放射輝度の測定値ではありません。",
"強度 α : 暗部での Zero-DCE 出力の混合率の上限です。明るい画素では"
"自動的に 0 へ近づくため、α を上げても点光源は飽和しません。",
"引き下げ係数 : 自動推定のとき、出力の飽和率が入力より増えすぎている間は"
"α を自動的に下げます。その係数です。",
"動き画素率 : 時間方向ノイズ低減が効かない画素の割合です。画面全体が動く"
"映像では 1 に近づき、その分だけ空間方向のノイズ低減を強めます。",
"処理時間 : 1 フレームの補正に要した時間の指数移動平均。表示更新率は"
"ウィンドウ描画の実測値で、処理時間の逆数とは一致しません。",
"補正後の画素値 : 画素ごとに異なる非線形トーンマッピングの結果であり、"
"明るさの比較や測光には使用できません。",
)
def __init__(self, root):
self.win = tk.Toplevel(root)
self.win.title("操作パネル")
self.win.resizable(False, False)
self.win.geometry("+24+20")
self.quit = False
self._command = None
self.win.protocol("WM_DELETE_WINDOW", self._request_quit)
self.scene = tk.IntVar(value=0)
self.auto = tk.BooleanVar(value=True)
self.quality = tk.IntVar(value=0)
self.pacing = tk.IntVar(value=0)
self.values = {}
self.flags = {}
box = tk.LabelFrame(self.win, text="シーン別設定", font=(UI_FONT, 9),
padx=8, pady=4)
box.pack(fill="x", padx=14, pady=(10, 6))
for i, label in enumerate(SCENE_LABELS):
tk.Radiobutton(box, text=label, variable=self.scene, value=i,
font=(UI_FONT, 9), anchor="w"
).grid(row=i // 2, column=i % 2, sticky="w", padx=4)
box = tk.LabelFrame(self.win, text="処理解像度", font=(UI_FONT, 9),
padx=8, pady=4)
box.pack(fill="x", padx=14, pady=(0, 6))
for i, label in enumerate(self.QUALITY):
tk.Radiobutton(box, text=label, variable=self.quality, value=i,
font=(UI_FONT, 8), anchor="w", justify="left"
).pack(anchor="w")
box = tk.LabelFrame(self.win, text="動画ファイルの再生方針",
font=(UI_FONT, 9), padx=8, pady=4)
box.pack(fill="x", padx=14, pady=(0, 6))
for i, label in enumerate(self.PACING):
tk.Radiobutton(box, text=label, variable=self.pacing, value=i,
font=(UI_FONT, 8), anchor="w", justify="left"
).pack(anchor="w")
tk.Checkbutton(self.win, variable=self.auto, font=(UI_FONT, 10, "bold"),
text="自動パラメータ推定 (シーン統計から 3 強度を毎フレーム決定)"
).pack(anchor="w", padx=14)
for key, label, init in self.SLIDERS:
var = tk.IntVar(value=init)
scale = tk.Scale(self.win, variable=var, from_=0, to=100, length=360,
orient="horizontal", label=label, font=(UI_FONT, 8))
scale.pack(padx=14)
for event in ("<Button-1>", "<B1-Motion>", "<Key>"):
scale.bind(event, self._to_manual) # 操作した時点で手動へ移る
self.values[key] = var
for key, label, init in self.TOGGLES:
var = tk.BooleanVar(value=init)
tk.Checkbutton(self.win, variable=var, text=label, font=(UI_FONT, 9),
anchor="w").pack(anchor="w", padx=14)
self.flags[key] = var
grid = tk.Frame(self.win)
grid.pack(padx=14, pady=(8, 4))
for i, (text, command) in enumerate((("静止画を保存", "snapshot"),
("録画 開始/停止", "record"),
("元解像度で書き出す", "export"),
("入力を切り替える", "input"),
("終了", "quit"))):
tk.Button(grid, text=text, width=16, font=(UI_FONT, 10),
command=lambda c=command: self._set(c)
).grid(row=i // 2, column=i % 2, padx=3, pady=3)
self.status = tk.StringVar(value="")
tk.Label(self.win, textvariable=self.status, font=(UI_FONT, 9),
justify="left", anchor="w", fg="#14521c"
).pack(fill="x", padx=16, pady=(6, 0))
self.message = tk.StringVar(value="")
tk.Label(self.win, textvariable=self.message, font=(UI_FONT, 9),
justify="left", anchor="w", fg="#8a4000", wraplength=370
).pack(fill="x", padx=16)
box = tk.LabelFrame(self.win, text="表示している数値の定義",
font=(UI_FONT, 9), padx=8, pady=4)
box.pack(fill="x", padx=14, pady=(8, 4))
for text in self.DEFINITIONS:
tk.Label(box, text="・" + text, font=(UI_FONT, 8), fg="#333",
justify="left", anchor="w", wraplength=350).pack(fill="x")
tk.Label(self.win, justify="left", anchor="w", fg="#555", font=(UI_FONT, 8),
text="キー操作 (映像ウィンドウ): SPACE 並置比較 P 一時停止 "
"G ヒストグラム L 低照度\n"
" S 静止画 R 録画 I 入力切替 "
"Q・ESC 終了"
).pack(fill="x", padx=16, pady=(4, 12))
# --- 内部 ---------------------------------------------------------------
def _request_quit(self):
self.quit = True
def _set(self, command):
if command == "quit":
self.quit = True
else:
self._command = command
def _to_manual(self, _event):
self.auto.set(False)
# --- 主ループから使う ---------------------------------------------------
def take_command(self):
command, self._command = self._command, None
return command
def toggle(self, key):
self.flags[key].set(not self.flags[key].get())
# 自動パラメータ推定 (シーン統計) が推奨値を持つスライダー。glare と
# bright_th は光源の映り方という被写体側の事情で決まる値であり、シーン
# 統計から自動推定できる性質のものではないため対象に含めない
AUTO_KEYS = ("strength", "denoise", "detail")
def read(self, stats):
"""現在の設定を返す。自動推定中は推奨値をスライダへ書き戻す。"""
if self.auto.get() and stats is not None and "auto_strength" in stats:
for key in self.AUTO_KEYS:
value = stats["auto_" + key]
if self.values[key].get() != value:
self.values[key].set(value)
cfg = {"scene": self.scene.get(), "auto": self.auto.get(),
"quality": self.quality.get(), "pacing": self.pacing.get()}
for key, var in self.values.items():
cfg[key] = var.get() / 100.0
for key, _label, _init in self.TOGGLES:
cfg[key] = self.flags[key].get()
return cfg
def set_status(self, text):
self.status.set(text)
def set_message(self, text):
self.message.set(text)
# ----------------------------------------------------------------------------
# 映像ウィンドウ (OpenCV)
# ----------------------------------------------------------------------------
CAVEAT = ("補正後の画素値は画素ごとに異なる非線形トーンマッピングの結果であり、"
"放射輝度の測定値ではありません")
class Viewer:
WIN = "Night Vision Enhancer"
def __init__(self):
cv2.namedWindow(self.WIN, cv2.WINDOW_NORMAL)
cv2.resizeWindow(self.WIN, 1120, 630)
cv2.moveWindow(self.WIN, 430, 30)
cv2.setMouseCallback(self.WIN, self._on_mouse)
self.split = 0.5
self.rect = (0, 0, 1120, 630)
def _on_mouse(self, event, x, _y, flags, _param):
"""並置比較の境界を左ドラッグで移動する。"""
if event == cv2.EVENT_LBUTTONDOWN or (
event == cv2.EVENT_MOUSEMOVE and flags & cv2.EVENT_FLAG_LBUTTON):
x0, _, w, _h = self.rect
self.split = float(np.clip((x - x0) / max(w, 1), 0.02, 0.98))
def alive(self):
return cv2.getWindowProperty(self.WIN, cv2.WND_PROP_VISIBLE) >= 1
@staticmethod
def split_view(original, enhanced, pos):
"""左に入力、右に補正後を並べ、境界線とつまみを描く。"""
h, w = enhanced.shape[:2]
x = int(np.clip(pos, 0.0, 1.0) * w)
out = enhanced.copy()
out[:, :x] = original[:, :x]
cv2.line(out, (x, 0), (x, h), (255, 255, 255), 1)
cv2.circle(out, (x, h // 2), 9, (255, 255, 255), 1, cv2.LINE_AA)
return out
@staticmethod
def _plot(canvas, curve, box, color):
x, y, w, h = box
xs = np.linspace(x, x + w, curve.size)
ys = y + h - curve * h
cv2.polylines(canvas, [np.stack([xs, ys], 1).astype(np.int32)],
False, color, 1, cv2.LINE_AA)
def _histogram(self, canvas, area, before, after):
"""入力と補正後の輝度分布を、軸と定義を明記して重ね描きする。"""
ax, ay, aw, ah = area
w, h = min(440, aw - 32), 196
x, y = ax + aw - w - 16, ay + ah - h - 16
if w < 240 or y < ay:
return
b_curve, b_hi, b_lo = before
a_curve, a_hi, a_lo = after
overlay = canvas[y:y + h, x:x + w]
cv2.addWeighted(overlay, 0.35, np.zeros_like(overlay), 0.65, 0.0, dst=overlay)
cv2.rectangle(canvas, (x, y), (x + w, y + h), (70, 70, 70), 1)
plot = (x + 18, y + 30, w - 36, 92)
cv2.rectangle(canvas, (plot[0], plot[1]),
(plot[0] + plot[2], plot[1] + plot[3]), (90, 90, 90), 1)
self._plot(canvas, b_curve, plot, (190, 190, 190))
self._plot(canvas, a_curve, plot, (120, 255, 120))
title = ("輝度ヒストグラム 横軸: 輝度 Y (BT.601) 0-255 を 128 区間 "
"縦軸: log(1+度数) を系列ごとに最大値で正規化")
draw_texts(canvas, (x, y, w, h), (
(14, 8, title, fit_px(title, w - 28, 11), (225, 225, 225), "lt"),
(18, 126, "0", 10, (170, 170, 170), "lt"),
(18 + (w - 36) / 2, 126, "128", 10, (170, 170, 170), "mt"),
(w - 18, 126, "255", 10, (170, 170, 170), "rt"),
(18, 144, "灰線: 入力", 11, (200, 200, 200), "lt"),
(110, 144, "緑線: 補正後", 11, (120, 255, 120), "lt"),
(18, 162, f"飽和率 (Y≥254): 入力 {b_hi * 100:.2f}% → "
f"補正後 {a_hi * 100:.2f}%", 11, (215, 215, 215), "lt"),
(18, 178, f"黒つぶれ率 (Y≤1): 入力 {b_lo * 100:.2f}% → "
f"補正後 {a_lo * 100:.2f}%", 11, (215, 215, 215), "lt"),
))
def show(self, image, headline, comparing, simulated, recording, graph):
"""表示領域の大きさに合わせ、縦横比を保って中央へ描画する。"""
rect = cv2.getWindowImageRect(self.WIN)
cw, ch = (rect[2], rect[3]) if rect[2] > 64 and rect[3] > 64 else (1120, 630)
h, w = image.shape[:2]
scale = min(cw / w, ch / h)
nw, nh = max(1, int(w * scale)), max(1, int(h * scale))
canvas = np.zeros((ch, cw, 3), np.uint8)
x0, y0 = (cw - nw) // 2, (ch - nh) // 2
canvas[y0:y0 + nh, x0:x0 + nw] = cv2.resize(
image, (nw, nh),
interpolation=cv2.INTER_AREA if scale < 1 else cv2.INTER_LINEAR)
self.rect = (x0, y0, nw, nh)
bar = int(np.clip(nh * 0.055, 22, 38))
px = int(bar * 0.55)
draw_texts(canvas, (x0, y0, nw, bar),
((11, bar / 2, headline, fit_px(headline, nw - 24, px),
(150, 255, 150), "lm"),), dim=0.35)
if graph is not None:
self._histogram(canvas, (x0, y0 + bar, nw, nh - bar * 2), *graph)
items = [(nw / 2, bar / 2, CAVEAT, fit_px(CAVEAT, nw - 260, px * 0.78),
(205, 205, 205), "mm")]
if comparing:
left = "← 入力 (低照度シミュレーション適用)" if simulated else "← 入力"
items += [(11, bar / 2, left, px, (235, 235, 235), "lm"),
(nw - 11, bar / 2, "補正後 →", px, (140, 255, 140), "rm")]
draw_texts(canvas, (x0, y0 + nh - bar, nw, bar), items, dim=0.35)
if recording:
cv2.circle(canvas, (x0 + nw - bar // 2 - 8, y0 + bar // 2),
max(4, bar // 5), (60, 60, 255), -1, cv2.LINE_AA)
cv2.imshow(self.WIN, canvas)
# ----------------------------------------------------------------------------
# 主ループ
# ----------------------------------------------------------------------------
KEY_TOGGLES = {ord(" "): "compare", ord("p"): "paused", ord("g"): "graph",
ord("l"): "simulate"}
KEY_COMMANDS = {ord("s"): "snapshot", ord("r"): "record", ord("i"): "input"}
# 輝度ヒストグラムと飽和率は処理解像度で画素を数えるため負荷がある。表示の更新にも
# 自動制御にもこの間隔で足りる
PROFILE_INTERVAL = 4
def preview_cap(quality, cuda):
"""プレビューの処理幅の上限を返す。品質優先では上限を設けない。"""
if quality:
return 1 << 20
return 1280 if cuda else 960
def main():
root = tk.Tk()
root.withdraw()
splash = tk.Toplevel(root)
splash.title("準備中")
splash.protocol("WM_DELETE_WINDOW", lambda: None)
tk.Label(splash, font=(UI_FONT, 11), padx=30, pady=24, justify="left",
text="学習済みモデル (Zero-DCE) を読み込み、この機械での推論時間を\n"
"実測して処理解像度を決定しています。").pack()
center_window(splash)
splash.update()
try:
pipe = NightVisionPipeline(splash)
except Exception as exc: # 重みの取得・読み込み失敗は理由を示して終える
splash.destroy()
messagebox.showerror("起動できません", str(exc))
root.destroy()
return
splash.destroy()
source = choose_source(root)
if source is None:
root.destroy()
return
panel = ControlPanel(root)
viewer = Viewer()
simulator = LowLightSimulator()
cuda = pipe.model.device.type == "cuda"
def announce():
panel.set_message(
f"静止画・録画の保存先: {SCRIPT_DIR}\n"
f"演算装置 {pipe.model.device}/係数マップ: {pipe.model.describe()}\n"
f"速度優先では処理幅 {preview_cap(0, cuda)}px 以下に縮小します"
"(録画・静止画もこの解像度になります)。入力の解像度で残すには"
"「元解像度で書き出す」を使います。"
+ (f"\n{_FONT_WARNING}" if _FONT_WARNING else ""))
announce()
writer, rec_path, rec_codec, written_id = None, "", "", -1
frame, frame_id, read_fail, last_raw = None, 0, 0, None
shown_input, input_key = None, None
enhanced, stats, scene_used, signature = None, None, 1, None
graph_cache, graph_id, quality_now = None, -1, 0
proc_ms, fps_disp = 0.0, 0.0
t_prev, dt_frame, tick, dropped = time.perf_counter(), 1.0 / 30.0, 0, 0
try:
while True:
root.update()
if panel.quit:
break
t_start = time.perf_counter()
cfg = panel.read(stats)
if cfg["quality"] != quality_now:
quality_now = cfg["quality"]
pipe.model.set_full(bool(quality_now))
pipe.reset()
frame, shown_input, input_key, signature = None, None, None, None
graph_cache, graph_id, last_raw = None, -1, None
announce()
if not cfg["paused"] or frame is None:
raw = source.read()
if raw is None:
# カメラの一時的な取りこぼしで終了しないようにする
read_fail += 1
if not source.is_live or read_fail > 60:
break
panel.set_message(
f"入力からフレームを取得できません ({read_fail} 回連続)。"
"接続を確認してください。")
if not viewer.alive():
break
cv2.waitKey(10)
continue
read_fail = 0
last_raw = raw
frame = fit_frame(raw, preview_cap(quality_now, cuda))
frame_id += 1
# 同じ入力・同じ設定なら再計算しない (一時停止中の負荷と揺らぎを除く)
if input_key != (frame_id, cfg["simulate"]):
shown_input = simulator(frame) if cfg["simulate"] else frame
input_key = (frame_id, cfg["simulate"])
key_now = (input_key, cfg["scene"], cfg["strength"], cfg["denoise"],
cfg["detail"], cfg["glare"], cfg["bright_th"])
if signature != key_now:
t0 = time.perf_counter()
try:
enhanced, stats, scene_used = pipe.process(
shown_input, cfg["scene"], cfg["strength"], cfg["denoise"],
cfg["detail"], dt=dt_frame,
raw=None if cfg["simulate"] else last_raw,
glare_gain=cfg["glare"], bright_th=cfg["bright_th"])
except RuntimeError as exc:
panel.quality.set(0)
panel.set_message(str(exc))
signature = None
cv2.waitKey(1)
continue
ms = (time.perf_counter() - t0) * 1000.0
proc_ms = ms if proc_ms == 0.0 else 0.85 * proc_ms + 0.15 * ms
signature = key_now
if writer is not None and written_id != frame_id:
writer.write(enhanced)
written_id = frame_id
# ヒストグラムと飽和率は画素を数えるため間隔を置く。得られた飽和率は
# 自動推定の引き下げ制御にも使う
if graph_id != frame_id and tick % PROFILE_INTERVAL == 0:
graph_cache = (luminance_profile(shown_input),
luminance_profile(enhanced))
graph_id = frame_id
if cfg["auto"]:
pipe.feedback(graph_cache[0][1], graph_cache[1][1])
view = viewer.split_view(shown_input, enhanced, viewer.split) \
if cfg["compare"] else enhanced
scene_text = (SCENE_LABELS[cfg["scene"]] if cfg["scene"]
else f"自動判別 → {SCENE_LABELS[scene_used]}")
headline = (f"{source.name}|{scene_text}|"
f"{'自動パラメータ推定' if cfg['auto'] else '手動設定'}|"
f"{enhanced.shape[1]}x{enhanced.shape[0]}|"
f"処理 {proc_ms:.1f} ms/フレーム|表示 {fps_disp:.1f} fps"
+ (f"|間引き {dropped}" if dropped else "")
+ ("|品質優先" if quality_now else "")
+ ("|低照度シミュレーション" if cfg["simulate"] else "")
+ ("|一時停止" if cfg["paused"] else ""))
if not viewer.alive():
break
viewer.show(view, headline, cfg["compare"], cfg["simulate"],
writer is not None, graph_cache if cfg["graph"] else None)
tick += 1
if tick % 3 == 0:
panel.set_status(
f"推定ノイズ標準偏差 σ̂ = {stats['sigma']:.4f} "
f"暗部指標 = {stats['darkness']:.2f} "
f"引き下げ係数 = {pipe.trim:.2f}\n"
f"動き画素率 = {stats.get('motion', 0.0):.2f} "
f"出力解像度 = {enhanced.shape[1]} x {enhanced.shape[0]} px\n"
f"処理 {proc_ms:.1f} ms/フレーム 表示 {fps_disp:.1f} fps"
+ (f" 間引き {dropped} フレーム" if dropped else "")
+ (f" ● 録画中 ({rec_codec})" if writer is not None else ""))
# 動画ファイルの再生方針。実時間優先では、処理に要した時間ぶんの
# フレームを読み飛ばして再生速度を保つ。録画中は記録内容が欠けるため
# 間引かない
dropped = 0
if not cfg["paused"] and not source.is_live and cfg["pacing"] == 0 \
and writer is None:
behind = int((time.perf_counter() - t_start) * source.fps) - 1
if behind > 0:
dropped = source.skip(min(behind, 8))
frame_id += dropped
if cfg["paused"]:
wait = 30
elif source.is_live:
wait = 1
else:
wait = max(1, int((1.0 / source.fps -
(time.perf_counter() - t_start)) * 1000))
key = cv2.waitKey(wait) & 0xFF
if 65 <= key <= 90: # 大文字も同じ操作として受け付ける
key += 32
now = time.perf_counter()
dt_frame = float(np.clip(now - t_prev, 1e-3, 1.0))
inst = 1.0 / dt_frame
fps_disp = inst if fps_disp == 0.0 else 0.85 * fps_disp + 0.15 * inst
t_prev = now
if key in (ord("q"), 27):
break
if key in KEY_TOGGLES:
panel.toggle(KEY_TOGGLES[key])
command = KEY_COMMANDS.get(key) or panel.take_command()
if command == "snapshot":
try:
panel.set_message(
f"静止画を保存しました ({view.shape[1]}x{view.shape[0]}, "
f"重ね表示は含みません): {save_image(view, 'view')}")
except Exception as exc:
panel.set_message(f"静止画を保存できませんでした: {exc}")
elif command == "record":
if writer is None:
fps = (max(5.0, min(fps_disp, 60.0)) if source.is_live
else source.fps)
try:
writer, rec_path, rec_codec = new_writer(
(enhanced.shape[1], enhanced.shape[0]), fps)
written_id = -1
panel.set_message(
f"録画を開始しました ({enhanced.shape[1]}x"
f"{enhanced.shape[0]}, {rec_codec}, 音声なし)\n"
"補正後の映像のみを全フレーム記録します。録画中は"
"フレームの間引きを行いません。\n"
f"フレームレート {fps:.1f} fps: {rec_path}")
except Exception as exc: # 失敗しても表示は続ける
writer = None
panel.set_message(f"録画を開始できませんでした: {exc}")
else:
writer.release()
writer = None
panel.set_message(f"録画を保存しました: {rec_path}")
elif command == "export":
if source.path is None:
panel.set_message(
"元解像度での書き出しは動画ファイル入力のときだけ使えます。"
"カメラ映像は「録画」で保存してください。")
else:
if writer is not None:
writer.release()
writer = None
panel.set_message(f"録画を保存しました: {rec_path}")
panel.set_message(export_video(root, source.path, source.name,
pipe, cfg["scene"]))
pipe.model.set_full(bool(quality_now))
pipe.reset()
signature, graph_id = None, -1
t_prev = time.perf_counter()
elif command == "input":
if writer is not None: # 解像度が変わるため録画を確定させる
writer.release()
writer = None
panel.set_message(f"録画を保存しました: {rec_path}")
source.release()
source = choose_source(root)
if source is None:
break
pipe.reset()
frame, shown_input, input_key, signature = None, None, None, None
graph_cache, graph_id, last_raw = None, -1, None
read_fail, dropped = 0, 0
panel.flags["paused"].set(False)
announce()
finally:
if source is not None: # 入力選択を閉じた直後は None になり得る
source.release()
if writer is not None:
writer.release()
cv2.destroyAllWindows()
root.destroy()
if __name__ == "__main__":
main()