データベース入門(授業資料)
カリキュラム構成
本授業は以下の4つの部で構成される。
- 第1部:導入とSQL基礎(ds-1〜ds-4)
データベースの基本概念を学んだ後、SQLFiddleを活用してSQLの文法とSELECT文によるデータ検索の基礎を習得する。
- 第2部:SQL応用(ds-5〜ds-8)
テーブル結合、GROUP BYによる集約処理、副問い合わせを学び、総合演習でこれらの知識を統合的に活用する。
- 第3部:データベース設計と理論(ds-9〜ds-12)
主キーと参照整合性制約、正規化理論、トランザクション管理を学習し、オンライントランザクション処理とデータウェアハウスの違いを理解する。
- 第4部:実践と発展(ds-13〜ds-15)
Microsoft Accessを用いたアプリケーション開発を実践し、NoSQLデータベースの概念と特徴を学んでデータ管理技術への視野を広げる。
学習内容一覧
| 回 | タイトル | 主要な学習内容 |
|---|---|---|
| ds-1 | データベースの基本 | データベースと日常生活の関わり,データベースの活用の広さ,データベース管理システム(DBMS)の概念,表計算(Excel)とデータベースの違い,データベース設計の基本概念 |
| ds-2 | リレーショナルデータベースとSQL入門 | リレーショナルデータベースの特徴,テーブル,属性(列),行の概念,基本的なSQL文の構造 |
| ds-3 | データベース設計と正規化 | データベースの異状(異常と異状の違いも理解),正規化の必要性,正規化による異状の防止 |
| ds-4 | SQL入門:SQLFiddleを活用したデータベース操作の基礎と応用 | SQLFiddleの基本操作,テーブルの作成と削除,データの挿入,基本的なデータ検索 |
| ds-5 | テーブルの結合とSQLによるデータ統合 | JOIN、複数テーブルの操作 |
| ds-6 | SQLによるデータ分析:GROUP BYを用いたグループ化と集約 | GROUP BY、集約関数 |
| ds-7 | 副問い合わせ | サブクエリ、入れ子構造 |
| ds-8 | SQL総合演習 | SQL知識の統合、実践演習 |
| ds-9 | 主キーと参照整合性制約 | 主キー、外部キー、制約 |
| ds-10 | データベース設計、正規化 | 正規化理論、設計手法 |
| ds-11 | データベース操作とトランザクション管理:データ整合性と永続性 | ACID特性、トランザクション |
| ds-12 | データ管理の基礎:オンライントランザクションとデータウェアハウスの特徴と活用 | OLTP、データウェアハウス |
| ds-13 | Microsoft Accessの使い方、データの並べ替え(ソート) | Access基本操作、ソート |
| ds-14 | データベースアプリケーションの実践 | アプリケーション開発 |
| ds-15 | NoSQLデータベースシステム | NoSQLの概念と特徴 |
補充教材
本授業には以下の補充教材が用意されている。
| 教材名 | 内容 |
|---|---|
| データベース設計と正規化 | 設計の留意点、異状、正規化の基本概念と手法 |
| 関数従属性 | 関数従属性の概念と応用 |
| インデックス、セキュリティ、データベースの歴史と展望 | 性能最適化、セキュリティ、発展的内容 |
| 全体まとめ | 授業全体の総括 |
到達目標
本授業を修了した受講者は、SQLを用いたデータ操作と分析ができるようになる。また、正規化理論に基づくデータベース設計を理解し、リレーショナルデータベースとNoSQLの特性を踏まえた技術選択ができるようになる。
授業の特徴
本授業は、SQLFiddleによるオンライン演習環境とMicrosoft Accessによるアプリケーション開発実習を組み合わせ、理論と実践の両面からデータベース技術を習得できる構成となっている。リレーショナルデータベースを中心としながらもNoSQLまで扱うことで、現代のデータ管理技術を俯瞰できる視野を養成する。
【サイト内の関連ページ】
公開資料は クリエイティブコモンズ 表示-非営利-継承 4.0 国際ライセンス(CC BY-NC-SA 4.0) で提供しており,事前の許可なく自由に利用できます.条件は著作者表示(BY),非営利目的のみ(NC),同一ライセンスでの再配布(SA)です.
ds-1. データベースの基本
スライド資料
 資料 [PDF], [パワーポイント] (同じ内容, クリックしてダウンロード)
[動画](クリックして再生開始)( クレジット: 「VOICEVOX:青山龍星」、「Vrew」、「Gemini」を用いて作成)
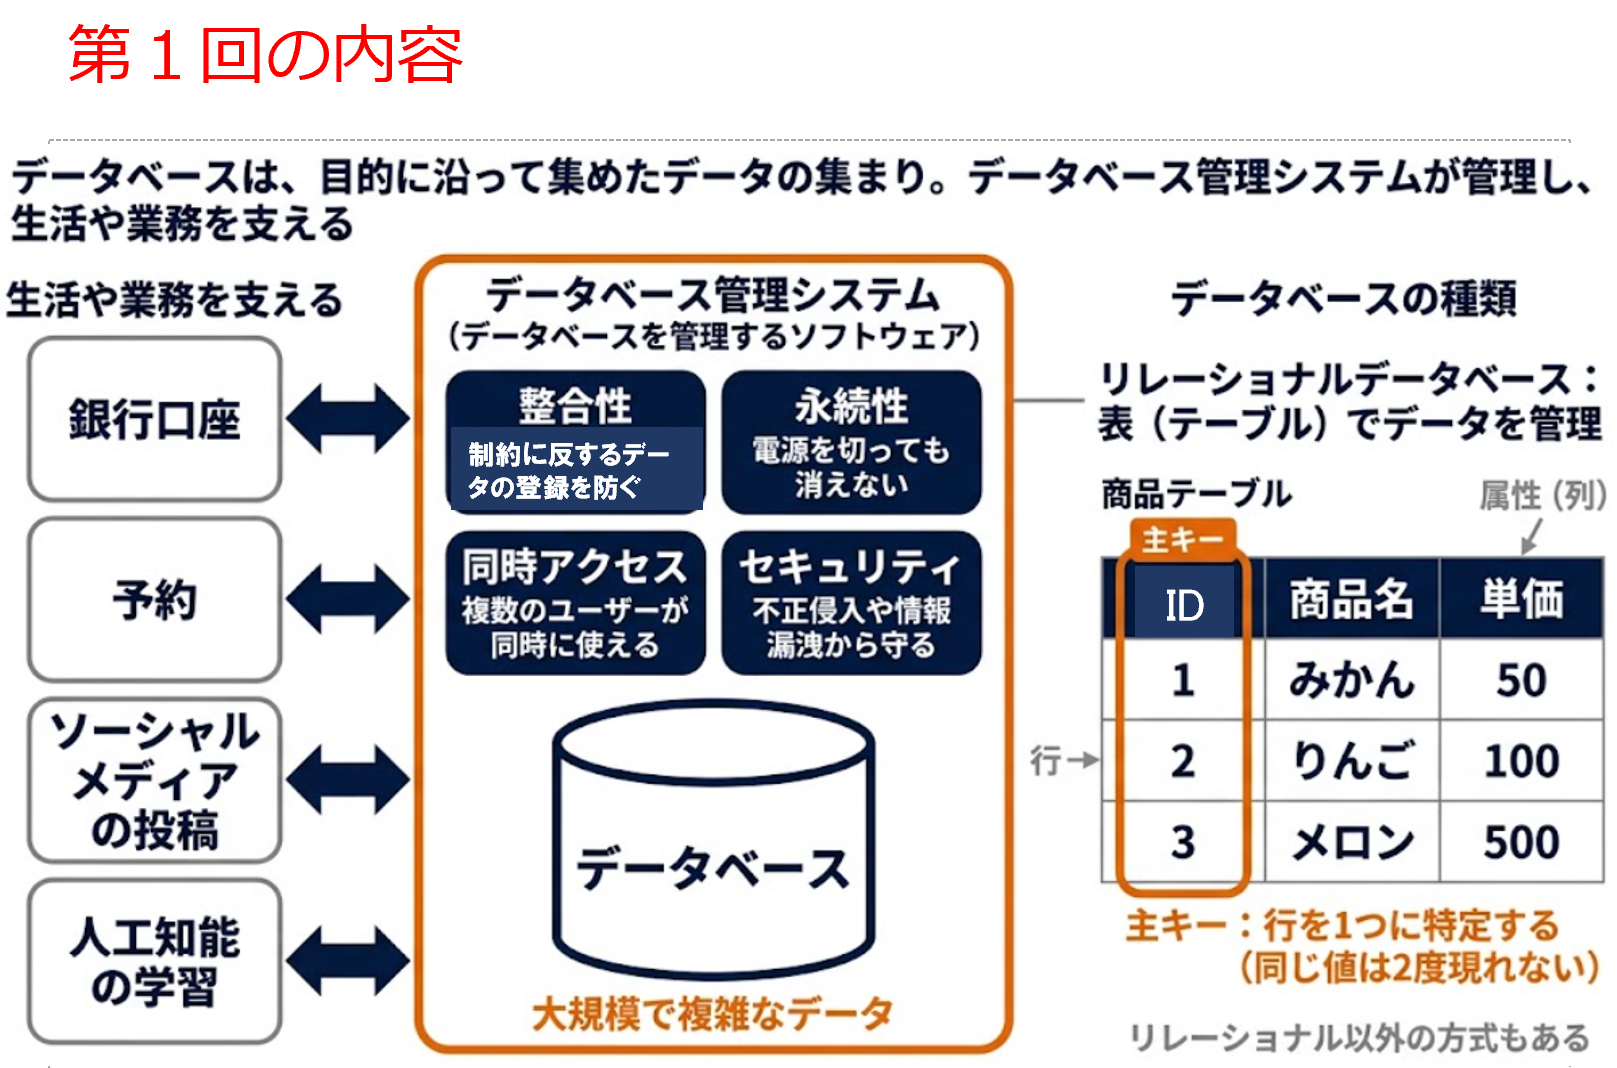
データベースは特定の目的に沿って集めたデータの集まりである。銀行口座、予約、SNS、人工知能の学習などさまざまな生活や業務を支えている。
その特徴は、大規模で複雑なデータ、複数ユーザーの同時アクセス、制約による整合性の維持の重要性、アプリケーションとの連携である。
データベースを管理するソフトウェアである「データベース管理システム(DBMS)」は整合性・永続性・同時アクセス・セキュリティの機能を持つ。データベースには様々な種類がある。
リレーショナルデータベースは表(テーブル)でデータを管理し、主キーで行を特定する。
難しく考えず、Access で、データベースを体験してみてください Microsoft Access は,リレーショナルデータベースを作成・管理するためのソフトウェアである.この演習では,Access を起動し,中身が空の新しいデータベースファイルを作成して,テーブルツール画面を開く. 操作手順
ヒント 考察ポイント テーブルの新規作成は,テーブル定義とデータの挿入の2段階で行う.この演習では,テーブル定義として,「商品名」と「単価」の2つの属性を追加し,それぞれのデータ型を指定する.「ID」は最初から用意されている属性であり,そのまま使う. 操作手順
ヒント 考察ポイント 演習②でテーブル定義を行ったテーブルにデータを挿入し,テーブル名を「商品」として保存する.次の完成形をめざす. 操作手順
ヒント
[演習の詳細を表示するには、この行をクリックしてください]
演習
演習全体の実演動画
演習①
Access の利用開始
データベース1.accdb)が表示されていることを確認する.ファイル名は変える必要はない.
演習②
テーブル定義
属性名 データ型 操作 ID オートナンバー型 そのまま使う 商品名 短いテキスト 追加する 単価 数値 追加する

演習③
データの挿入
ID 商品名 単価 1 みかん 50 2 りんご 100 3 メロン 500


 [動画]
(クリックして再生開始)
考察ポイント
- 「ID」に 1, 2, 3 の通し番号が自動設定される様子を確認する.
ds-2. SQLの基本
スライド資料
 資料 [PDF], [パワーポイント] (同じ内容, クリックしてダウンロード)
[動画](クリックして再生開始)( クレジット: 「VOICEVOX:青山龍星」、「Vrew」、「Gemini」を用いて作成)
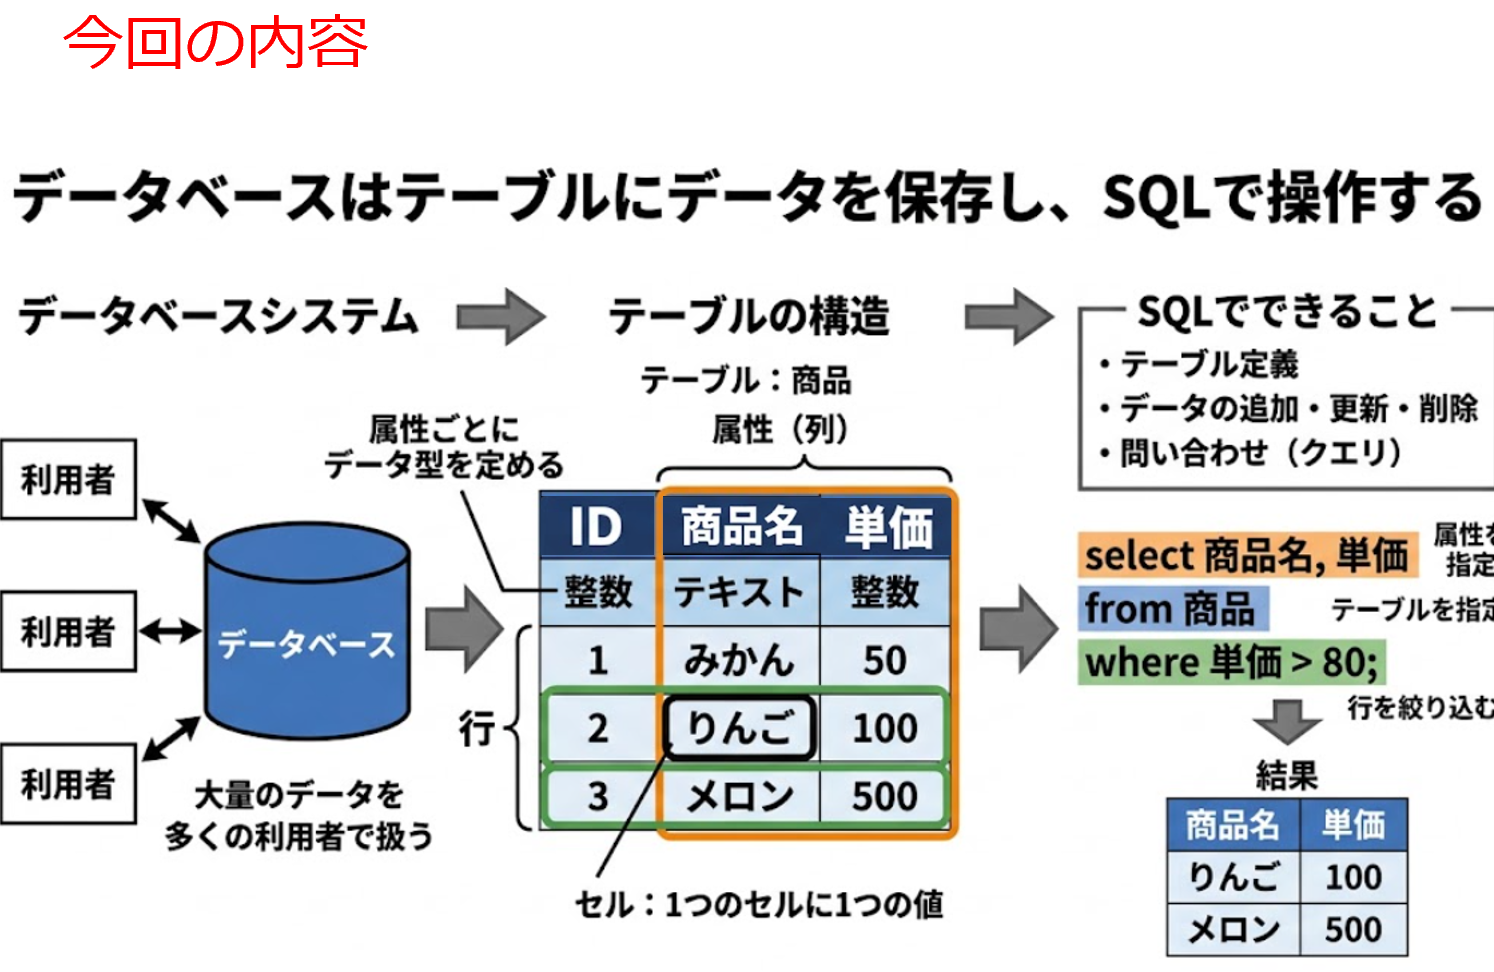
データベースシステムは大量のデータを多くの利用者で扱うためのシステムである。リレーショナルデータベースでは、データを属性(列)と行からなるテーブルに保存する。テーブルの各属性にデータ型を定める。テーブルの1つのセルに1つの値を入れる。SQLはテーブル定義、データの追加・更新・削除、問い合わせ(クエリ)を行う言語である。問い合わせはselectで属性、fromでテーブルを指定し、whereで行を絞り込む。
SQLFiddle は,Webブラウザ上で SQL を実行できるサイトであり,データベースソフトウェアのインストールは不要である.上のパネルに SQL を入力して「Execute」をクリックすると,上のパネルのすべての SQL が実行され,結果が結果ウィンドウに表示される.
この演習では,テーブル定義(create table)とデータ追加(insert into)を行い,続いて問い合わせ(select)でテーブルの中身を確認する. SQLFiddle のサイト:https://sqlfiddle.com/ 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ Cookie についての警告が表示される場合がある。緑色のAcceptをクリックする。
ヒント 考察ポイント 演習①と同じく SQLFiddle を使う.テーブル「従業員」を定義してデータを追加し,問い合わせ(select)は,すべての属性の取得,必要な属性を選ぶ問い合わせ,where で条件に合う行を選ぶ問い合わせ(選択)の3通りを行う. SQLFiddle のサイト:https://sqlfiddle.com/ 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント
[演習の詳細を表示するには、この行をクリックしてください]
演習全体の実演動画
演習① SQLFiddle を用いたテーブル定義とデータ追加
create table 朝食と値段 (
  名前 text,
  朝食 text,
  値段 integer
);
insert into 朝食と値段 values ('A', 'カレーライス', 400);
insert into 朝食と値段 values ('B', 'うどん', 250);
insert into 朝食と値段 values ('C', 'カレーライス', 400);insert into 朝食と値段 values ('C', 'カレーライス', 400);)の末尾をクリックし,Enter キーで改行してから,次の1行を入力する.
追加後の上のパネルは,次のようになる.
select * from 朝食と値段;create table 朝食と値段 (
名前 text,
朝食 text,
値段 integer
);
insert into 朝食と値段 values ('A', 'カレーライス', 400);
insert into 朝食と値段 values ('B', 'うどん', 250);
insert into 朝食と値段 values ('C', 'カレーライス', 400);
select * from 朝食と値段;
演習② テーブル定義,データ追加,問い合わせ
CREATE TABLE 従業員 (
  id INTEGER,
  name TEXT,
  age INTEGER,
  salary INTEGER,
  department_id INTEGER);
INSERT INTO 従業員 VALUES (1, 'Alice', 30, 50000, 1);
INSERT INTO 従業員 VALUES (2, 'Bob', 40, 60000, 1);
INSERT INTO 従業員 VALUES (3, 'Charlie', 35, 70000, 2);
select * from 従業員;CREATE TABLE 従業員 (
id INTEGER,
name TEXT,
age INTEGER,
salary INTEGER,
department_id INTEGER);
INSERT INTO 従業員 VALUES (1, 'Alice', 30, 50000, 1);
INSERT INTO 従業員 VALUES (2, 'Bob', 40, 60000, 1);
INSERT INTO 従業員 VALUES (3, 'Charlie', 35, 70000, 2);
SELECT age FROM 従業員;CREATE TABLE 従業員 (
id INTEGER,
name TEXT,
age INTEGER,
salary INTEGER,
department_id INTEGER);
INSERT INTO 従業員 VALUES (1, 'Alice', 30, 50000, 1);
INSERT INTO 従業員 VALUES (2, 'Bob', 40, 60000, 1);
INSERT INTO 従業員 VALUES (3, 'Charlie', 35, 70000, 2);
SELECT * FROM 従業員 WHERE age = 30;
 [動画]
(クリックして再生開始)
第3回.データベース設計と正規化
スライド資料
 資料 [PDF], [パワーポイント] (同じ内容, クリックしてダウンロード)
[動画](クリックして再生開始)( クレジット: 「VOICEVOX:青山龍星」、「Vrew」、「Gemini」を用いて作成)
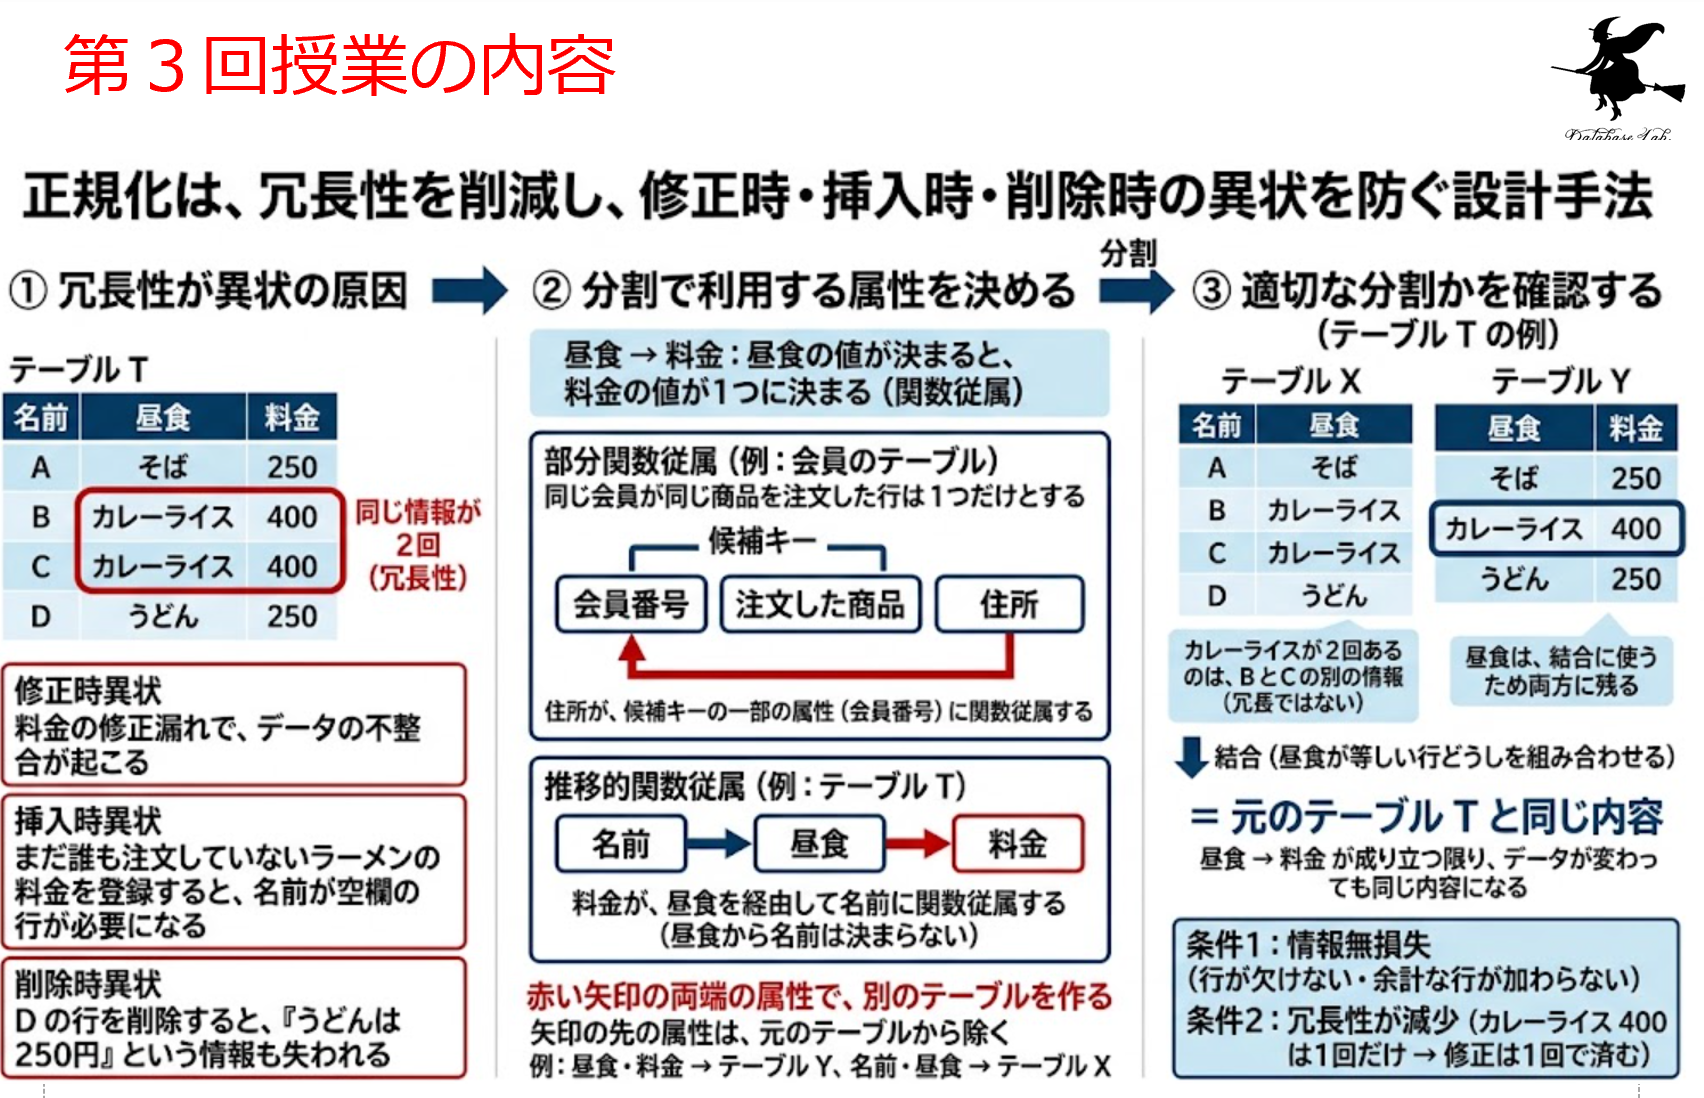
正規化は、冗長性を削減し、修正時・挿入時・削除時の異状(データの不整合など)を防ぐ設計手法である.部分関数従属と推移的関数従属を手がかりにテーブルの分割で利用する属性を決める.適切な分割であるかどうかは、情報無損失(結合すると常に元のテーブルと同じ内容になる)であることと、冗長性が減少していることで確認する.
この演習では,SQLFiddle を用いて,テーブルの分割(正規化)と,分割したテーブルの結合を行い,分割が情報無損失であるか,冗長性が減少しているかを確認する. SQLFiddle は,Webブラウザ上で SQL を実行できるサイトであり,インストールは不要である.上のパネルに SQL を入力して「Execute」をクリックすると,上のパネルのすべての SQL が実行され,結果が結果ウィンドウに表示される. SQLFiddle のサイト:https://sqlfiddle.com/ 授業で用いたテーブル T(名前,昼食,料金)を作り,テーブル X(名前,昼食)とテーブル Y(昼食,料金)に分割する.分割には 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント 演習①で分割したテーブル X とテーブル Y を,「昼食が等しい」行どうしを組み合わせて結合し,元のテーブル T と同じ内容になること(情報無損失)を確認する. 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント 同じテーブル T を,演習①とは別の方法で分割する.テーブル P(昼食,料金)とテーブル Q(名前,料金)に分け,共通の属性である「料金」が等しい行どうしを結合して,元のテーブル T に戻るかを確認する(授業資料の「分割③」). 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ 考察ポイント
[演習の詳細を表示するには、この行をクリックしてください]
演習
演習全体の実演動画
演習① テーブル T の分割(CREATE TABLE … AS SELECT DISTINCT)
CREATE TABLE … AS SELECT DISTINCT を使う.
CREATE TABLE T (
  名前 TEXT,
  昼食 TEXT,
  料金 INTEGER);
INSERT INTO T VALUES ('A', 'そば', 250);
INSERT INTO T VALUES ('B', 'カレーライス', 400);
INSERT INTO T VALUES ('C', 'カレーライス', 400);
INSERT INTO T VALUES ('D', 'うどん', 250);
CREATE TABLE X AS SELECT DISTINCT 名前, 昼食 FROM T;
CREATE TABLE Y AS SELECT DISTINCT 昼食, 料金 FROM T;
SELECT * FROM T;SELECT * FROM T; をマウスでドラッグして選択し,Delete キーで消す.消した場所に,次の1行を入力する.
SELECT * FROM X;SELECT * FROM X; を消し,次の1行を入力する.
SELECT * FROM Y;CREATE TABLE Y AS SELECT DISTINCT 昼食, 料金 FROM T; の行から DISTINCT の1語だけを消して(CREATE TABLE Y AS SELECT 昼食, 料金 FROM T; にして)「Execute」をクリックし,テーブル Y の行数を手順9と比べる.
CREATE TABLE … AS は,SELECT 文の結果から新しいテーブルを作る.DISTINCT は,SELECT 文の結果から重複する行を除く.
演習② 結合による情報無損失の確認(INNER JOIN)
CREATE TABLE T (
  名前 TEXT,
  昼食 TEXT,
  料金 INTEGER);
INSERT INTO T VALUES ('A', 'そば', 250);
INSERT INTO T VALUES ('B', 'カレーライス', 400);
INSERT INTO T VALUES ('C', 'カレーライス', 400);
INSERT INTO T VALUES ('D', 'うどん', 250);
CREATE TABLE X AS SELECT DISTINCT 名前, 昼食 FROM T;
CREATE TABLE Y AS SELECT DISTINCT 昼食, 料金 FROM T;
SELECT X.名前, X.昼食, Y.料金 FROM X
  INNER JOIN Y ON X.昼食 = Y.昼食;
| 名前 | 昼食 | 料金 |
+--------+--------------------+--------+
| A | そば | 250 |
| B | カレーライス | 400 |
| C | カレーライス | 400 |
| D | うどん | 250 |
+--------+--------------------+--------+
SELECT X.名前, X.昼食, Y.料金 は取り出す属性,FROM X は最初のテーブル,INNER JOIN Y は結合する相手のテーブル,ON X.昼食 = Y.昼食 は結合条件である.
演習③ 情報無損失にならない分割の確認
CREATE TABLE T (
  名前 TEXT,
  昼食 TEXT,
  料金 INTEGER);
INSERT INTO T VALUES ('A', 'そば', 250);
INSERT INTO T VALUES ('B', 'カレーライス', 400);
INSERT INTO T VALUES ('C', 'カレーライス', 400);
INSERT INTO T VALUES ('D', 'うどん', 250);
CREATE TABLE P AS SELECT DISTINCT 昼食, 料金 FROM T;
CREATE TABLE Q AS SELECT DISTINCT 名前, 料金 FROM T;
SELECT * FROM Q;SELECT * FROM Q; をマウスでドラッグして選択し,Delete キーで消す.消した場所に,次の SQL を入力する.
SELECT Q.名前, P.昼食, P.料金 FROM Q
  INNER JOIN P ON Q.料金 = P.料金;
 [動画]
(クリックして再生開始)
第4回.SQL入門:SQLFiddleを活用したデータベース操作の基礎と応用
スライド資料
 資料 [PDF], [パワーポイント] (同じ内容, クリックしてダウンロード)
[動画](クリックして再生開始)( クレジット: 「VOICEVOX:青山龍星」、「Vrew」、「Gemini」を用いて作成)
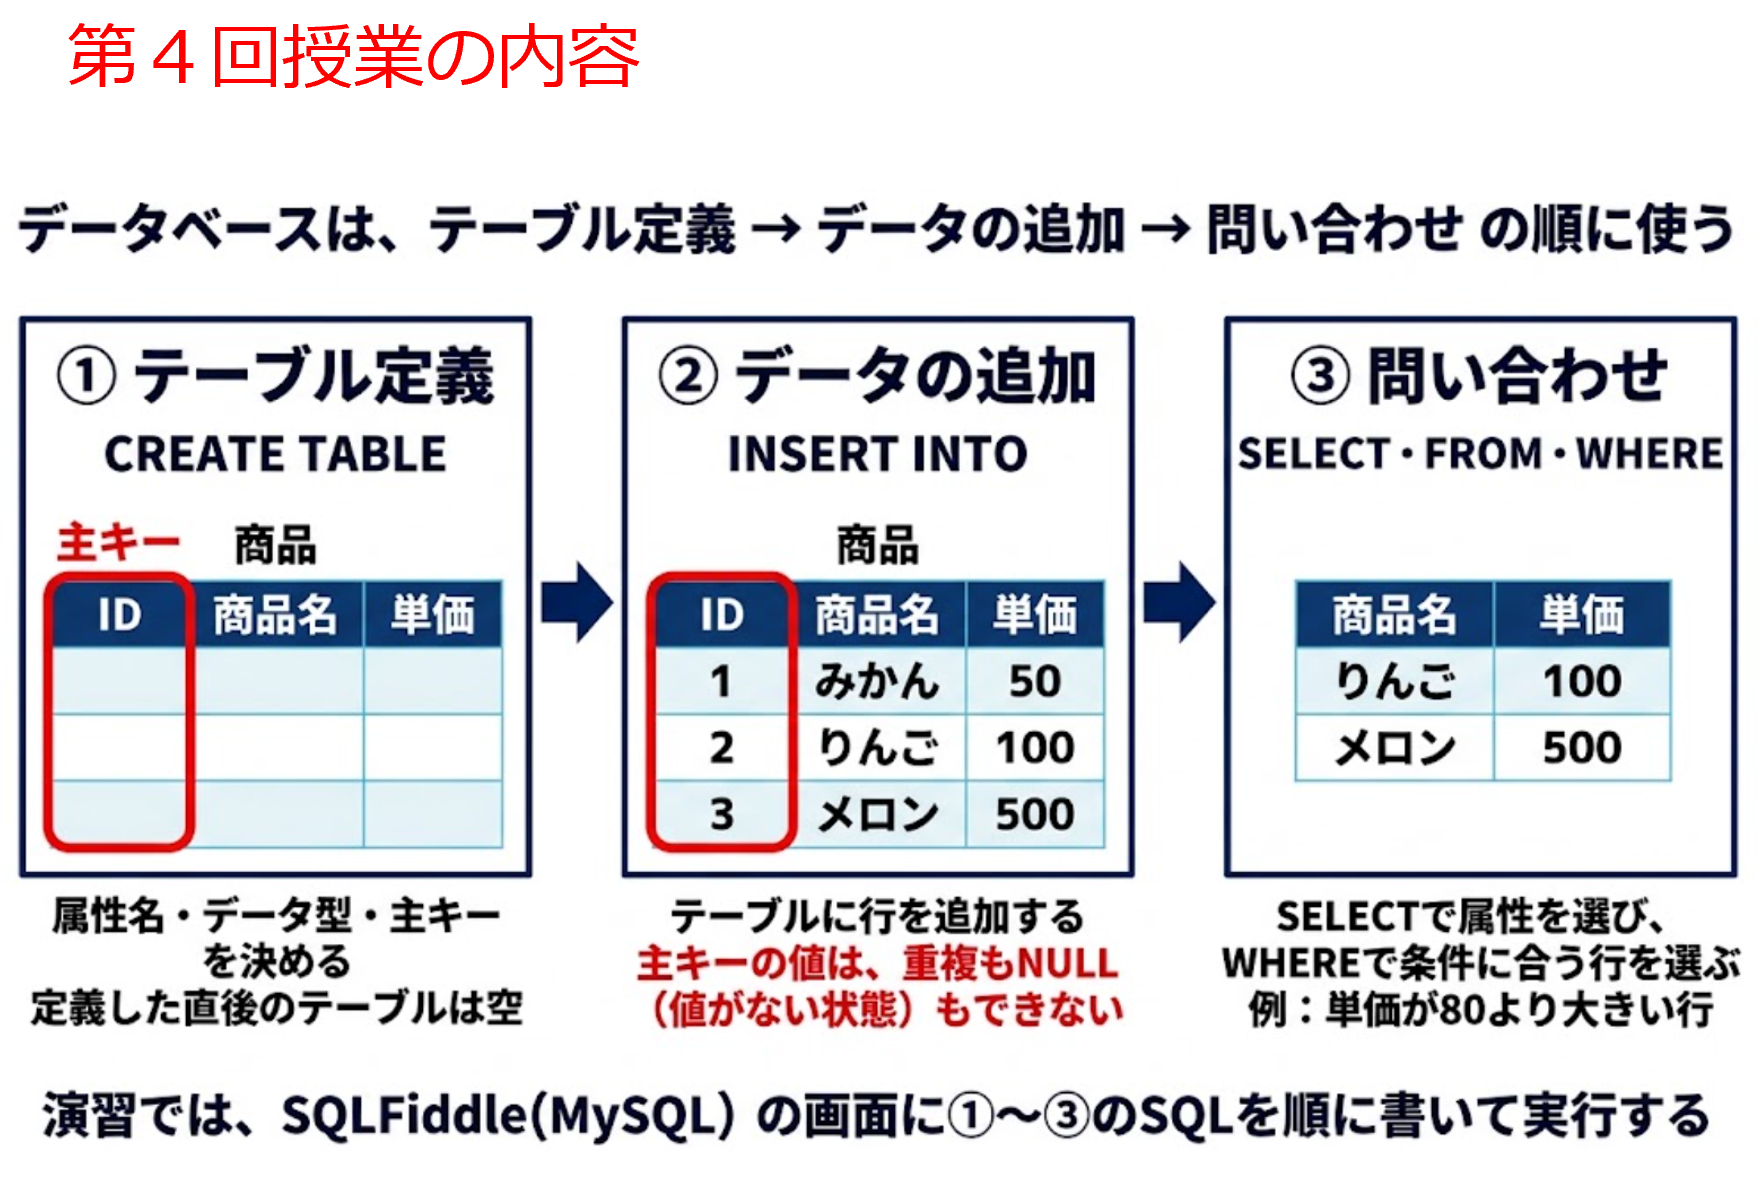
リレーショナルデータベースは、データを行と属性からなるテーブルで保存する。そして、他のテーブルの主キーを参照する属性でテーブル間を関連付ける。主キーは行を1つに特定する属性(または属性の組)で、値の重複とNULLをデータベース管理システムが自動で拒否する。
テーブル定義は、CREATE TABLEで属性名とデータ型を定義する。INSERT INTOで行を追加する。
問い合わせは、SELECTで属性、FROMでテーブル、WHEREで条件を指定する。LIKEと%を使えば、文字列の一部が一致する行も選べる。
この演習では,SQLFiddle を用いて,テーブル定義(CREATE TABLE),データの追加(INSERT INTO),問い合わせ(SELECT)を行い,主キー制約の働きと,WHERE と LIKE による行の選択を確認する. SQLFiddle は,Webブラウザ上で SQL を実行できるサイトであり,インストールは不要である.上のパネルに SQL を入力して「Execute」をクリックすると,上のパネルのすべての SQL が実行され,結果が結果ウィンドウに表示される. SQLFiddle のサイト:https://sqlfiddle.com/ 授業で用いた商品テーブル(ID,商品名,単価)を作り,行を追加して,問い合わせで内容を確認する.続いて,従業員テーブルと部署テーブルを作り,2つのテーブルの関連を確認する. 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント 商品テーブルに,主キー(ID)の値が重複する行を追加し,エラーになることを確認する.続いて,重複しない値に変えて,行を追加できることを確認する. 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント 属性の組(学生ID,科目ID)を主キーとする成績テーブルを作り,組の値が重複する行を追加するとエラーになることを確認する.続いて,その行を消して,残りの行を追加できることを確認する. 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント 47行の都道府県テーブル(コード,都道府県名,人口,面積)を作り,WHERE と LIKE で条件を変えて問い合わせを行い,選ばれる行を確認する. 操作手順 SQLFiddle のサイト:https://sqlfiddle.com/ ヒント 考察ポイント
[演習の詳細を表示するには、この行をクリックしてください]
演習
演習① テーブル定義,データの追加,問い合わせ(CREATE TABLE,INSERT INTO,SELECT)
CREATE TABLE 商品 (
  ID INTEGER PRIMARY KEY,
  商品名 TEXT,
  単価 INTEGER);
INSERT INTO 商品 VALUES (1, 'みかん', 50);
INSERT INTO 商品 VALUES (2, 'りんご', 100);
INSERT INTO 商品 VALUES (3, 'メロン', 500);
SELECT * FROM 商品;CREATE TABLE 従業員 (
id INTEGER PRIMARY KEY,
name TEXT,
age INTEGER,
salary INTEGER,
department_id INTEGER);
CREATE TABLE 部署 (
id INTEGER PRIMARY KEY,
name TEXT);
INSERT INTO 従業員 VALUES (1, 'Alice', 30, 50000, 1);
INSERT INTO 従業員 VALUES (2, 'Bob', 40, 60000, 1);
INSERT INTO 従業員 VALUES (3, 'Charlie', 35, 70000, 2);
INSERT INTO 部署 VALUES (1, 'HR');
INSERT INTO 部署 VALUES (2, 'Engineering');
SELECT * FROM 従業員;SELECT * FROM 従業員; をマウスでドラッグして選択し,Delete キーで消す.消した場所に,次の1行をコピーして貼り付ける.
SELECT * FROM 部署;
演習② 主キー制約違反のエラーの確認(商品)
CREATE TABLE 商品 (
  ID INTEGER PRIMARY KEY,
  商品名 TEXT,
  単価 INTEGER);
INSERT INTO 商品 VALUES (1, 'みかん', 50);
INSERT INTO 商品 VALUES (2, 'りんご', 100);
INSERT INTO 商品 VALUES (3, 'メロン', 500);
INSERT INTO 商品 VALUES (1, 'いちご', 1000);ERROR 1062 (23000) at line 8: Duplicate entry '1' for key '商品.PRIMARY'
INSERT INTO 商品 VALUES (1, 'いちご', 1000); をマウスでドラッグして選択し,Delete キーで消す.消した場所に,次の2行をコピーして貼り付ける.
INSERT INTO 商品 VALUES (4, 'いちご', 1000);
SELECT * FROM 商品;
演習③ 属性の組を主キーにする(成績)
CREATE TABLE 成績 (
  学生ID INTEGER,
  科目ID INTEGER,
  得点 INTEGER,
  PRIMARY KEY (学生ID, 科目ID));
INSERT INTO 成績 VALUES (1, 1001, 90);
INSERT INTO 成績 VALUES (1, 1002, 100);
INSERT INTO 成績 VALUES (2, 1001, 85);
INSERT INTO 成績 VALUES (2, 1002, 90);
INSERT INTO 成績 VALUES (2, 1003, 95);
INSERT INTO 成績 VALUES (1, 1001, 95);
SELECT * FROM 成績;ERROR 1062 (23000) at line 11: Duplicate entry '1-1001' for key '成績.PRIMARY'
INSERT INTO 成績 VALUES (1, 1001, 95); をマウスでドラッグして選択し,Delete キーで消す.
演習④ 都道府県テーブルに対する問い合わせ(WHERE,LIKE)
CREATE TABLE 都道府県 (
  コード INTEGER,
  都道府県名 TEXT,
  人口 INTEGER,
  面積 REAL);
INSERT INTO 都道府県 VALUES (1, '北海道', 5224614, 83424.31);
INSERT INTO 都道府県 VALUES (2, '青森県', 1237984, 9645.64);
INSERT INTO 都道府県 VALUES (3, '岩手県', 1210534, 15275.01);
INSERT INTO 都道府県 VALUES (4, '宮城県', 2301996, 7282.29);
INSERT INTO 都道府県 VALUES (5, '秋田県', 959502, 11637.52);
INSERT INTO 都道府県 VALUES (6, '山形県', 1068027, 9323.15);
INSERT INTO 都道府県 VALUES (7, '福島県', 1833152, 13784.14);
INSERT INTO 都道府県 VALUES (8, '茨城県', 2867009, 6097.39);
INSERT INTO 都道府県 VALUES (9, '栃木県', 1933146, 6408.09);
INSERT INTO 都道府県 VALUES (10, '群馬県', 1939110, 6362.28);
INSERT INTO 都道府県 VALUES (11, '埼玉県', 7344765, 3797.75);
INSERT INTO 都道府県 VALUES (12, '千葉県', 6284480, 5157.61);
INSERT INTO 都道府県 VALUES (13, '東京都', 14047594, 2194.07);
INSERT INTO 都道府県 VALUES (14, '神奈川県', 9237337, 2416.17);
INSERT INTO 都道府県 VALUES (15, '新潟県', 2201272, 12584.10);
INSERT INTO 都道府県 VALUES (16, '富山県', 1044588, 4247.61);
INSERT INTO 都道府県 VALUES (17, '石川県', 1132526, 4186.09);
INSERT INTO 都道府県 VALUES (18, '福井県', 766863, 4190.49);
INSERT INTO 都道府県 VALUES (19, '山梨県', 809974, 4465.27);
INSERT INTO 都道府県 VALUES (20, '長野県', 2048011, 13561.56);
INSERT INTO 都道府県 VALUES (21, '岐阜県', 1978742, 10621.29);
INSERT INTO 都道府県 VALUES (22, '静岡県', 3633202, 7777.42);
INSERT INTO 都道府県 VALUES (23, '愛知県', 7542415, 5172.92);
INSERT INTO 都道府県 VALUES (24, '三重県', 1770254, 5774.40);
INSERT INTO 都道府県 VALUES (25, '滋賀県', 1413610, 4017.38);
INSERT INTO 都道府県 VALUES (26, '京都府', 2578087, 4612.19);
INSERT INTO 都道府県 VALUES (27, '大阪府', 8837685, 1905.14);
INSERT INTO 都道府県 VALUES (28, '兵庫県', 5465002, 8401.02);
INSERT INTO 都道府県 VALUES (29, '奈良県', 1324473, 3690.94);
INSERT INTO 都道府県 VALUES (30, '和歌山県', 922584, 4724.64);
INSERT INTO 都道府県 VALUES (31, '鳥取県', 553407, 3507.13);
INSERT INTO 都道府県 VALUES (32, '島根県', 671126, 6708.26);
INSERT INTO 都道府県 VALUES (33, '岡山県', 1888432, 7114.62);
INSERT INTO 都道府県 VALUES (34, '広島県', 2799702, 8479.63);
INSERT INTO 都道府県 VALUES (35, '山口県', 1342059, 6112.54);
INSERT INTO 都道府県 VALUES (36, '徳島県', 719559, 4146.65);
INSERT INTO 都道府県 VALUES (37, '香川県', 950244, 1876.72);
INSERT INTO 都道府県 VALUES (38, '愛媛県', 1334841, 5676.11);
INSERT INTO 都道府県 VALUES (39, '高知県', 691527, 7103.63);
INSERT INTO 都道府県 VALUES (40, '福岡県', 5135214, 4986.52);
INSERT INTO 都道府県 VALUES (41, '佐賀県', 811442, 2440.69);
INSERT INTO 都道府県 VALUES (42, '長崎県', 1312317, 4130.98);
INSERT INTO 都道府県 VALUES (43, '熊本県', 1738301, 7409.35);
INSERT INTO 都道府県 VALUES (44, '大分県', 1123852, 6340.73);
INSERT INTO 都道府県 VALUES (45, '宮崎県', 1069576, 7735.31);
INSERT INTO 都道府県 VALUES (46, '鹿児島県', 1588256, 9186.94);
INSERT INTO 都道府県 VALUES (47, '沖縄県', 1467480, 2282.59);
SELECT * FROM 都道府県;SELECT * FROM 都道府県; をマウスでドラッグして選択し,Delete キーで消す.消した場所に,次の1行をコピーして貼り付ける.
SELECT 都道府県名, 人口 FROM 都道府県 WHERE 人口 >= 3000000;SELECT 都道府県名 FROM 都道府県 WHERE 都道府県名 LIKE '%県%';SELECT 都道府県名 FROM 都道府県 WHERE 都道府県名 LIKE '山%';SELECT 都道府県名 FROM 都道府県 WHERE 都道府県名 LIKE '%島%';
ds-5. テーブルの結合と SQL によるデータ統合
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: 学習目標 この演習で習得する内容: 2.1 演習の目的 この演習では、データベースの基本操作を学びます。具体的には、テーブルを作成し、データを追加し、そのデータを取得する一連の流れを体験します。 2.2 手順 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください ステップ2:SQLを入力して実行してください SQLFiddleの場合は上のパネルに、DBFiddleの場合は左側の「Schema SQL」に以下のSQLを入力してください。 注意: 最初に表示されているサンプルSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタンをクリックしてください。 ステップ3:結果を確認してください 下のパネルに以下の結果が表示されることを確認してください。 商品テーブルの全データが表示されます(3行:みかん、りんご、メロン)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 2.3 ヒントと考察のポイント テーブル定義について: データ追加について: SELECT文について: よくある間違い: 3.1 演習の目的 この演習では、2つのテーブルを結合する方法を学びます。具体的には、INNER JOINを使用して、関連性のあるデータを結び付ける方法を体験します。 3.2 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタンをクリックしてください。 ステップ3:結果を確認してください 下のパネルに以下の結果が表示されることを確認してください。 商品テーブルと購入テーブルが結合され、購入者がどの商品を購入したかが表示されます(3行)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 3.3 ヒントと考察のポイント なぜテーブルを分けるのか: INNER JOINについて: 結合条件について: よくある間違い: 4.1 演習の目的 この演習では、結合後のテーブルから必要な列のみを選択する方法を学びます。 4.2 手順 問題: 結合の結果のテーブルは5列です。このうち、「商品名」と「購入者」の列のみを表示し、他の列は表示しないようなSQLを作成してください。 ヒント: SELECT * を変更して、必要な列のみを指定してください。 期待される結果: 4.3 解答例 4.4 解説 5.1 演習の目的 この演習では、結合後のテーブルの行数を数える方法を学びます。 5.2 手順 問題: 結合の結果のテーブルは、1つのテーブルです。この行数3を得るSQLを作成してください。 ヒント: COUNT(*) を使用してください。 期待される結果: 5.3 解答例 5.4 解説 6.1 演習の目的 この演習では、INNER JOINとWHERE句を組み合わせて使用する方法を学びます。具体的には、結合後のデータを条件で絞り込む方法を体験します。 6.2 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタンをクリックしてください。 ステップ3:結果を確認してください 下のパネルに以下の結果が表示されることを確認してください。 購入者がXの行のみが表示されます(2行)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 ステップ4:追加のSELECT文を試してください 上のパネルの最後に、以下のSQLを追加してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 再度「Execute」ボタンをクリックし、結果を確認してください。 指定した列のみが表示されます(2行)。 期待される結果: 6.3 ヒントと考察のポイント WHERE句について: SELECT句での列の指定について: よくある間違い: 7.1 演習の目的 この演習では、WHERE句の条件を変更した場合の結果を予想する力を養います。 7.2 手順 問題: いまの演習において、次のSQLを実行したら、どのような結果になるか、予想してください。そして、実際に動作させてください。 ヒント: 購入.購入者 = 'X' でなく、購入.購入者 = 'Y' になっていることに注意 7.3 解答 期待される結果: 8.1 演習の目的 この演習では、CROSS JOINの動作を学びます。具体的には、結合条件を指定しない場合に、2つのテーブルの全ての組み合わせが作成されることを体験します。 8.2 手順 ステップ1:SQLFiddleにアクセスしてください ステップ2:SQLを入力して実行してください 上のパネルに以下のSQLを入力してください。 注意: 最初に表示されているサンプルSQLは削除してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタンをクリックしてください。 ステップ3:結果を確認してください 下のパネルに以下の結果が表示されることを確認してください。 全ての組み合わせが表示されます(9行:商品3行×購入3行)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 8.3 ヒントと考察のポイント CROSS JOINについて: INNER JOINとの違い: 考察のポイント: 9.1 演習の目的 この演習では、これまで学んだ内容を統合して使用します。具体的には、テーブルの作成、結合、列の選択、条件による絞り込み、集計を体験します。 9.2 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタンをクリックしてください。 ステップ3:結果を確認してください 下のパネルに結果が表示されることを確認してください。 全ての組み合わせが表示されます(6行:名簿3行×食材2行)。 ステップ4:追加のSELECT文を試してください 上のパネルの最後に、以下のSQLを追加してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 再度「Execute」ボタンをクリックし、結果を確認してください。 1つ目のSQLは、結合条件を指定した結合の結果が表示されます(3行)。 2つ目のSQLは、名前の列のみが表示されます(3行)。 3つ目のSQLは、とうふを買った人のみが表示されます(1行)。 4つ目のSQLは、行数が表示されます(3)。 期待される結果: 1つ目のSQL:
2つ目のSQL:
3つ目のSQL:
4つ目のSQL: 9.3 ヒントと考察のポイント データの関連性について: 段階的なデータ抽出について: エラーが出た場合 Syntax errorが表示される 予期しない結果が表示される、何も結果が表示されない SQLFiddleが動かない場合 この演習で学んだこと 重要なポイント[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
2. 演習1:テーブル定義とデータの追加
CREATE TABLE 商品 (


 ID INTEGER,


 商品名 TEXT,


 単価 INTEGER);


INSERT INTO 商品 VALUES(1, 'みかん', 50);


INSERT INTO 商品 VALUES(2, 'りんご', 100);


INSERT INTO 商品 VALUES(3, 'メロン', 500);


SELECT * FROM 商品;
ID
商品名
単価
1
みかん
50
2
りんご
100
3
メロン
500
3. 演習2:SQLによる結合
CREATE TABLE 商品 (


 ID INTEGER,


 商品名 TEXT,


 単価 INTEGER);


INSERT INTO 商品 VALUES(1, 'みかん', 50);


INSERT INTO 商品 VALUES(2, 'りんご', 100);


INSERT INTO 商品 VALUES(3, 'メロン', 500);


CREATE TABLE 購入 (


 購入者 TEXT,


 商品番号 INTEGER);


INSERT INTO 購入 VALUES('X', 1);


INSERT INTO 購入 VALUES('X', 3);


INSERT INTO 購入 VALUES('Y', 2);


SELECT * FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号;
ID
商品名
単価
購入者
商品番号
1
みかん
50
X
1
3
メロン
500
X
3
2
りんご
100
Y
2
4. 発展問題①:SELECTの応用
商品名
購入者
みかん
X
メロン
X
りんご
Y
SELECT 商品名, 購入者 FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号;
5. 発展問題②:COUNT(*)の応用
COUNT(*)
3
SELECT COUNT(*) FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号;
6. 演習3:複数の条件の指定
CREATE TABLE 商品 (


 ID INTEGER,


 商品名 TEXT,


 単価 INTEGER);


INSERT INTO 商品 VALUES(1, 'みかん', 50);


INSERT INTO 商品 VALUES(2, 'りんご', 100);


INSERT INTO 商品 VALUES(3, 'メロン', 500);


CREATE TABLE 購入 (


 購入者 TEXT,


 商品番号 INTEGER);


INSERT INTO 購入 VALUES('X', 1);


INSERT INTO 購入 VALUES('X', 3);


INSERT INTO 購入 VALUES('Y', 2);


SELECT * FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号 WHERE 購入.購入者 = 'X';
ID
商品名
単価
購入者
商品番号
1
みかん
50
X
1
3
メロン
500
X
3
SELECT 商品名, 購入者, 単価 FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号 WHERE 購入.購入者 = 'X';
商品名
購入者
単価
みかん
X
50
メロン
X
500
7. 発展問題③:条件変更による結果の予想
SELECT 商品名, 購入者, 単価 FROM 商品


INNER JOIN 購入


ON 商品.ID = 購入.商品番号 WHERE 購入.購入者 = 'Y';
商品名
購入者
単価
りんご
Y
100
8. 演習4:結合条件のない結合
CREATE TABLE 商品 (


 ID INTEGER,


 商品名 TEXT,


 単価 INTEGER);


INSERT INTO 商品 VALUES(1, 'みかん', 50);


INSERT INTO 商品 VALUES(2, 'りんご', 100);


INSERT INTO 商品 VALUES(3, 'メロン', 500);


CREATE TABLE 購入 (


 購入者 TEXT,


 商品番号 INTEGER);


INSERT INTO 購入 VALUES('X', 1);


INSERT INTO 購入 VALUES('X', 3);


INSERT INTO 購入 VALUES('Y', 2);


SELECT * FROM 商品


CROSS JOIN 購入;
ID
商品名
単価
購入者
商品番号
3
メロン
500
X
1
2
りんご
100
X
1
1
みかん
50
X
1
3
メロン
500
X
3
2
りんご
100
X
3
1
みかん
50
X
3
3
メロン
500
Y
2
2
りんご
100
Y
2
1
みかん
50
Y
2
9. 演習5:結合の総合演習
CREATE TABLE 名簿(


 ID INTEGER,


 name TEXT,


 buy INTEGER


);


INSERT INTO 名簿 VALUES(1, '織田', 1);


INSERT INTO 名簿 VALUES(2, '豊臣', 2);


INSERT INTO 名簿 VALUES(3, '徳川', 2);


CREATE TABLE 食材(


 ID INTEGER,


 name TEXT


);


INSERT INTO 食材 VALUES(1, 'とうふ');


INSERT INTO 食材 VALUES(2, '納豆');


SELECT * FROM 名簿


CROSS JOIN 食材;SELECT * FROM 名簿
JOIN 食材
ON 名簿.buy = 食材.ID;
SELECT 名簿.name, 食材.name FROM 名簿
INNER JOIN 食材
ON 名簿.buy = 食材.ID;
SELECT 名簿.name, 食材.name FROM 名簿
INNER JOIN 食材
ON 名簿.buy = 食材.ID WHERE 食材.name ='とうふ';
SELECT COUNT() FROM 名簿
INNER JOIN 食材
ON 名簿.buy = 食材.ID;
ID
name
buy
ID
name
1
織田
1
1
とうふ
2
豊臣
2
2
納豆
3
徳川
2
2
納豆
name
name
織田
とうふ
豊臣
納豆
徳川
納豆
name
name
織田
とうふ
COUNT()
3
10. トラブルシューティング
11. まとめ
ds-6. SQL によるデータ分析:GROUP BY を用いたグループ化と集約
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: 学習目標 この演習で習得する内容: 演習の目的 この演習では、SQLによるテーブル定義(CREATE TABLE)の基本を理解し、データの追加(INSERT INTO)とSELECT文による確認方法を習得します。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください ステップ2:SQLを入力して実行してください SQLFiddleの場合は上のパネルに、DBFiddleの場合は左側の「Schema SQL」に以下のSQLを入力してください。 注意: 最初に表示されているサンプルSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ3:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 成績テーブルの全データが表示されます(5行)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 ヒントと考察のポイント CREATE TABLE文について: INSERT INTO文について: SELECT文について: よくある間違い: 演習の目的 この演習では、集約関数(AVG, MAX, MIN, SUM, COUNT)の使い方を習得し、WHERE句と集約関数の組み合わせを理解します。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ3:結果を確認してください 実行すると、国語の平均点(87.5)が表示されます。 期待される結果: ステップ4:他の集約関数も試してください 以下のSQLを順に試してみましょう(最後のSELECT文の部分だけを変更して実行)。 ヒントと考察のポイント 集約関数について: WHERE句について: よくある間違い: 発展問題 発展問題①:算数の平均点の計算 目的:成績テーブルから算数の平均得点を算出する。 科目が算数の行について、得点の平均値を求めるSQL文を書いてください。 ヒント:AVGを使い、WHERE 句で科目を算数に絞り込みます。 発展問題②:科目は問わず全体の最高点の計算 目的:成績テーブルから最高得点を算出する。 得点の最大値を求めるSQL文を書いてください。 ヒント:MAXを使います。 演習の目的 この演習では、GROUP BY句の基本的な使い方を理解し、グループ化と集約の組み合わせ、WHERE句とGROUP BYの組み合わせを習得します。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 期待される結果: ステップ2:WHERE句との組み合わせを試してください 90点以上の成績について、科目ごとの受講者数を計算します。 最後のSELECT文を以下に変更して実行してください。 期待される結果: ヒントと考察のポイント GROUP BY句について: よくある間違い: 発展問題 以下の問題に挑戦してみましょう。 発展問題③:受講者ごとの科目数 発展問題④:科目ごとの平均点 発展問題⑤:受講者ごとの平均点 ヒント:AVG と GROUP BY を使用します。発展問題④の「科目」を「受講者」に変更してみましょう。 演習の目的 この演習では、実務に近いデータでGROUP BYを活用し、複数列でのグループ化を理解し、計算式(個数 * 単価)を含む集約を習得します。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 期待される結果: ヒントと考察のポイント 計算式の使用について: よくある間違い: 発展問題 発展問題⑥:商品Aの総売上を計算 ヒント:WHERE句で商品Aのみを選択し、SUMで合計します。
解答
期待される結果: 15000 計算の内訳: 発展問題⑦:日付別・商品別の総売上を計算 以下のSQLを実行し、結果を確認してください。 期待される結果: 解説: SQLFiddleで実行できない場合 エラーメッセージが表示される場合 結果が期待と異なる場合[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:テーブル定義とデータの追加
CREATE TABLE 成績 (
科目 TEXT,
受講者 TEXT,
得点 INTEGER);

INSERT INTO 成績 VALUES('国語', 'A', 85);
INSERT INTO 成績 VALUES('国語', 'B', 90);
INSERT INTO 成績 VALUES('算数', 'A', 90);
INSERT INTO 成績 VALUES('算数', 'B', 96);
INSERT INTO 成績 VALUES('理科', 'A', 95);

SELECT * FROM 成績;
科目
受講者
得点
国語
A
85
国語
B
90
算数
A
90
算数
B
96
理科
A
95
演習2:集約関数の基本
CREATE TABLE 成績 (
科目 TEXT,
受講者 TEXT,
得点 INTEGER);

INSERT INTO 成績 VALUES('国語', 'A', 85);
INSERT INTO 成績 VALUES('国語', 'B', 90);
INSERT INTO 成績 VALUES('算数', 'A', 90);
INSERT INTO 成績 VALUES('算数', 'B', 96);
INSERT INTO 成績 VALUES('理科', 'A', 95);

SELECT AVG(得点) FROM 成績 WHERE 科目 = '国語';
AVG(得点)
87.5000
-- 算数の平均点
SELECT AVG(得点) FROM 成績 WHERE 科目 = '算数';

-- 全体の最高点
SELECT MAX(得点) FROM 成績;

-- 全体の最低点
SELECT MIN(得点) FROM 成績;

-- 全体の合計点
SELECT SUM(得点) FROM 成績;

-- 全体の行数
SELECT COUNT(*) FROM 成績;
演習3:GROUP BYによるグループ化と集約
CREATE TABLE 成績 (
科目 TEXT,
受講者 TEXT,
得点 INTEGER);

INSERT INTO 成績 VALUES('国語', 'A', 85);
INSERT INTO 成績 VALUES('国語', 'B', 90);
INSERT INTO 成績 VALUES('算数', 'A', 90);
INSERT INTO 成績 VALUES('算数', 'B', 96);
INSERT INTO 成績 VALUES('理科', 'A', 95);

SELECT 科目, COUNT(*) FROM 成績 GROUP BY 科目;
科目
COUNT(*)
国語
2
算数
2
理科
1
SELECT 科目, COUNT(*) FROM 成績 WHERE 得点 >= 90 GROUP BY 科目;
科目
COUNT(*)
国語
1
算数
2
理科
1
SELECT 受講者, COUNT(*) FROM 成績 GROUP BY 受講者;SELECT 科目, AVG(得点) FROM 成績 GROUP BY 科目;演習4:売上データでのGROUP BY活用
CREATE TABLE 売上 (
日付 DATETIME,
商品 TEXT,
個数 INTEGER,
単価 INTEGER
);

INSERT INTO 売上 VALUES('2024-01-01', '商品A', 1, 500);
INSERT INTO 売上 VALUES('2024-01-01', '商品A', 2, 500);
INSERT INTO 売上 VALUES('2024-01-01', '商品A', 3, 500);
INSERT INTO 売上 VALUES('2024-01-01', '商品A', 4, 500);
INSERT INTO 売上 VALUES('2024-01-01', '商品B', 1, 1500);
INSERT INTO 売上 VALUES('2024-01-01', '商品B', 2, 1500);
INSERT INTO 売上 VALUES('2024-01-01', '商品B', 3, 1500);
INSERT INTO 売上 VALUES('2024-01-01', '商品B', 4, 1500);
INSERT INTO 売上 VALUES('2024-01-02', '商品A', 1, 500);
INSERT INTO 売上 VALUES('2024-01-02', '商品A', 2, 500);
INSERT INTO 売上 VALUES('2024-01-02', '商品A', 3, 500);
INSERT INTO 売上 VALUES('2024-01-02', '商品A', 4, 500);
INSERT INTO 売上 VALUES('2024-01-02', '商品B', 1, 1500);
INSERT INTO 売上 VALUES('2024-01-02', '商品B', 2, 1500);
INSERT INTO 売上 VALUES('2024-01-02', '商品B', 3, 1500);
INSERT INTO 売上 VALUES('2024-01-02', '商品B', 4, 1500);
INSERT INTO 売上 VALUES('2024-01-03', '商品A', 1, 500);
INSERT INTO 売上 VALUES('2024-01-03', '商品A', 2, 500);
INSERT INTO 売上 VALUES('2024-01-03', '商品A', 3, 500);
INSERT INTO 売上 VALUES('2024-01-03', '商品A', 4, 500);
INSERT INTO 売上 VALUES('2024-01-03', '商品B', 1, 1500);
INSERT INTO 売上 VALUES('2024-01-03', '商品B', 2, 1500);
INSERT INTO 売上 VALUES('2024-01-03', '商品B', 3, 1500);
INSERT INTO 売上 VALUES('2024-01-03', '商品B', 4, 1500);

SELECT 日付, SUM(個数 * 単価)
FROM 売上
GROUP BY 日付;
日付
SUM(個数 * 単価)
2024-01-01 00:00:00
20000
2024-01-02 00:00:00
20000
2024-01-03 00:00:00
20000
SELECT SUM(個数 * 単価)
FROM 売上
WHERE 商品 = '商品A';
SELECT 日付, 商品, SUM(個数 * 単価)
FROM 売上
GROUP BY 日付, 商品;
日付
商品
SUM(個数 * 単価)
2024-01-01 00:00:00
商品A
5000
2024-01-01 00:00:00
商品B
15000
2024-01-02 00:00:00
商品A
5000
2024-01-02 00:00:00
商品B
15000
2024-01-03 00:00:00
商品A
5000
2024-01-03 00:00:00
商品B
15000
トラブルシューティング
ds-7. 副問い合わせ
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: この演習では、IN演算子を使用して、複数の値のいずれかに一致するデータを検索する方法を習得します。IN演算子は、複数の条件を簡潔に記述するための機能です。後の副問い合わせと組み合わせることで、より複雑なデータ抽出が可能になります。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください ステップ2:SQLを入力して実行してください SQLFiddleの場合は上のパネルに、DBFiddleの場合は左側の「Schema SQL」に以下のSQLを入力してください。 注意: 最初に表示されているサンプルSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ3:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 科目が「国語」または「算数」の行がすべて表示されます(4行)。 期待される結果: 各テーブルの内容が正しく表示されていることを確認してください。 ヒントと考察のポイント IN演算子について: SELECT文について: 課題 得点が80点または90点である成績を検索するSQL文を書いてください。IN演算子を使用してください。 ヒント 解答例 このSQLは、得点が80または90のレコードを検索します。 解説:得点列の値が80または90に一致する行を取得します。実際のデータでは、得点90の行(A・算数、B・国語)が該当しますが、80点のレコードはデータに含まれていないため表示されません。 考察のポイント:実行後、結果に80点のレコードが含まれていない理由を考えてください。 課題 得点が80点、85点、または90点である成績を検索するSQL文を書いてください。IN演算子を使用してください。 ヒント 解答例 このSQLは、得点が80、85、または90のレコードを検索します。 解説:得点列の値が80、85、または90に一致する行を取得します。 INの丸かっこ内には、必要な数だけ値を追加できます。 副問い合わせ(サブクエリ)の基本構造と実行順序を理解し、別のSQL文の結果を利用したデータ検索を習得します。副問い合わせは、複雑なデータ抽出を1つのSQL文で実現する重要な技術です。実務では、動的な条件設定や複数テーブルからのデータ抽出に頻繁に使用されます。 副問い合わせの基礎知識 副問い合わせとは 副問い合わせ(サブクエリ)は、別のSQL文の中に埋め込まれたSQL文のことです。 基本構造: 特徴: なぜ副問い合わせが必要か 問題設定:最高得点を取った受講者を検索したい場合 方法1:2段階で実行 方法2:副問い合わせで1つのSQLにまとめる 副問い合わせの利点: 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ3:結果を確認してください 実行すると、最高得点を取った受講者「B」が表示されます。 期待される結果:最高得点を取った受講者「B」が表示される ヒントと考察のポイント 副問い合わせの実行順序: 考察のポイント: 課題 成績テーブルから、全科目の平均点よりも高い得点のレコードをすべて選択してください。副問い合わせを使用してください。 ヒント 解答例 このSQLは、平均点よりも高い得点のレコードを検索します。 解説: 重要なポイント: 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:従業員テーブルの作成とデータ追加 注意: 以前使用したSQLは削除 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 ステップ4:実行と結果確認 期待される結果:最高給与を受け取る従業員の名前「松本」が表示される ステップ5:平均よりも高い給与を受け取る従業員の検索 次に、上のパネルのSELECT文を以下に書き換えます SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 このSQLは、平均よりも高い給与を受け取る従業員の名前を検索します。 ステップ6:実行と結果確認 期待される結果:平均よりも高い給与を受け取る従業員の名前が複数表示される ヒントと考察のポイント 学習した内容のまとめ 演習1で学んだこと 演習2で学んだこと 発展演習③で学んだこと 演習3で学んだこと[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:SQLのIN演算子
CREATE TABLE 成績 (
科目 TEXT,
受講者 TEXT,
得点 INTEGER);

INSERT INTO 成績 VALUES('国語', 'A', 85);
INSERT INTO 成績 VALUES('国語', 'B', 90);
INSERT INTO 成績 VALUES('算数', 'A', 90);
INSERT INTO 成績 VALUES('算数', 'B', 96);
INSERT INTO 成績 VALUES('理科', 'A', 95);

SELECT * FROM 成績 WHERE 科目 IN ('国語', '算数');
発展演習① 得点による検索(2つの値)
SELECT * FROM 成績 WHERE 得点 IN (80, 90);発展演習② 得点による検索(3つの値)
SELECT * FROM 成績 WHERE 得点 IN (80, 85, 90);
演習2:副問い合わせ
SELECT … FROM … WHERE … = (別の SQL 文);
SELECT MAX(得点) FROM 成績; → 結果:96SELECT 受講者 FROM 成績 WHERE 得点 = 96; SELECT 受講者 FROM 成績 WHERE 得点 = (SELECT MAX(得点) FROM 成績);
CREATE TABLE 成績 (
科目 TEXT,
受講者 TEXT,
得点 INTEGER);

INSERT INTO 成績 VALUES('国語', 'A', 85);
INSERT INTO 成績 VALUES('国語', 'B', 90);
INSERT INTO 成績 VALUES('算数', 'A', 90);
INSERT INTO 成績 VALUES('算数', 'B', 96);
INSERT INTO 成績 VALUES('理科', 'A', 95);

SELECT 受講者 FROM 成績 WHERE 得点 = (SELECT MAX(得点) FROM 成績);
(SELECT MAX(得点) FROM 成績) → 結果:96SELECT 受講者 FROM 成績 WHERE 得点 = 96 → 結果:B
発展演習③ 平均点より高い得点の検索
SELECT * FROM 成績 WHERE 得点 > (SELECT AVG(得点) FROM 成績);
(SELECT AVG(得点) FROM 成績) → (85 + 90 + 90 + 96 + 95) ÷ 5 = 91.2SELECT * FROM 成績 WHERE 得点 > 91.2 → 96点(B・算数)と95点(A・理科)が該当
演習3:
CREATE TABLE 従業員 (
従業員ID INTEGER,
名前 TEXT,
部署ID INTEGER,
給与 INTEGER
);

INSERT INTO 従業員 VALUES(5, '伊藤', 104, 280000);
INSERT INTO 従業員 VALUES(6, '渡辺', 101, 320000);
INSERT INTO 従業員 VALUES(7, '小林', 102, 270000);
INSERT INTO 従業員 VALUES(8, '加藤', 103, 290000);
INSERT INTO 従業員 VALUES(9, '吉田', 104, 310000);
INSERT INTO 従業員 VALUES(10, '中村', 101, 330000);
INSERT INTO 従業員 VALUES(11, '小川', 102, 260000);
INSERT INTO 従業員 VALUES(12, '高橋', 103, 340000);
INSERT INTO 従業員 VALUES(13, '山本', 104, 300000);
INSERT INTO 従業員 VALUES(14, '石川', 101, 350000);
INSERT INTO 従業員 VALUES(15, '中島', 102, 280000);
INSERT INTO 従業員 VALUES(16, '佐々木', 103, 360000);
INSERT INTO 従業員 VALUES(17, '山口', 104, 290000);
INSERT INTO 従業員 VALUES(18, '松本', 101, 370000);
INSERT INTO 従業員 VALUES(19, '井上', 102, 310000);
INSERT INTO 従業員 VALUES(20, '木村', 103, 280000);
INSERT INTO 従業員 VALUES(21, '林', 104, 320000);
INSERT INTO 従業員 VALUES(22, '清水', 101, 330000);
INSERT INTO 従業員 VALUES(23, '山崎', 102, 340000);
INSERT INTO 従業員 VALUES(24, '中田', 103, 300000);
SELECT 名前 FROM 従業員 WHERE 給与 = (SELECT MAX(給与) FROM 従業員);このSQLは、最高給与を受け取る従業員の名前を検索します。
CREATE TABLE 従業員 (
従業員ID INTEGER,
名前 TEXT,
部署ID INTEGER,
給与 INTEGER
);

INSERT INTO 従業員 VALUES(5, '伊藤', 104, 280000);
INSERT INTO 従業員 VALUES(6, '渡辺', 101, 320000);
INSERT INTO 従業員 VALUES(7, '小林', 102, 270000);
INSERT INTO 従業員 VALUES(8, '加藤', 103, 290000);
INSERT INTO 従業員 VALUES(9, '吉田', 104, 310000);
INSERT INTO 従業員 VALUES(10, '中村', 101, 330000);
INSERT INTO 従業員 VALUES(11, '小川', 102, 260000);
INSERT INTO 従業員 VALUES(12, '高橋', 103, 340000);
INSERT INTO 従業員 VALUES(13, '山本', 104, 300000);
INSERT INTO 従業員 VALUES(14, '石川', 101, 350000);
INSERT INTO 従業員 VALUES(15, '中島', 102, 280000);
INSERT INTO 従業員 VALUES(16, '佐々木', 103, 360000);
INSERT INTO 従業員 VALUES(17, '山口', 104, 290000);
INSERT INTO 従業員 VALUES(18, '松本', 101, 370000);
INSERT INTO 従業員 VALUES(19, '井上', 102, 310000);
INSERT INTO 従業員 VALUES(20, '木村', 103, 280000);
INSERT INTO 従業員 VALUES(21, '林', 104, 320000);
INSERT INTO 従業員 VALUES(22, '清水', 101, 330000);
INSERT INTO 従業員 VALUES(23, '山崎', 102, 340000);
INSERT INTO 従業員 VALUES(24, '中田', 103, 300000);
SELECT 名前 FROM 従業員 WHERE 給与 > (SELECT AVG(給与) FROM 従業員);
考察のポイント:
学習の振り返り
ds-8. SQL 総合演習
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: WHERE句を使った条件指定によるデータの絞り込み、副問い合わせの理解と活用、IN演算子による複数条件の指定、AND演算子による複数条件の組み合わせを習得します。 従業員テーブルを使用して、以下のSQL問い合わせを実行します。 手順 ステップ1:テーブル定義とデータ追加 SQLFiddleの場合は上のパネルに、DBFiddleの場合は左側の「Schema SQL」に以下のSQLを入力してください。 注意: 最初に表示されているサンプルSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ2:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 部署ID 101の従業員の名前と給与が表示されます。 期待される結果: 部署ID 101の従業員の名前と給与が正しく表示されていることを確認してください。 ヒントと考察のポイント WHERE句について: ステップ3:副問い合わせを使った条件指定 上のパネルに以下のSQLを追加してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ4:結果を確認してください 結果をスクロールして、給与が平均以上の従業員のみが表示されていることを確認してください。 期待される結果: 給与が平均以上の従業員のみが正しく表示されていることを確認してください。 ヒントと考察のポイント 副問い合わせについて: ステップ5:IN演算子による複数条件の指定 上のパネルに以下のSQLを追加してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ6:結果を確認してください 部署ID 101または102の従業員のみが表示されることを確認してください。 期待される結果: 部署ID 101または102の従業員のみが正しく表示されていることを確認してください。 ヒントと考察のポイント IN演算子について: ステップ7:AND演算子による複数条件の組み合わせ 上のパネルに以下のSQLを追加してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ8:結果を確認してください 条件を満たす従業員が表示されることを確認してください。 期待される結果: 条件を満たす従業員が正しく表示されていることを確認してください。 ヒントと考察のポイント AND演算子について: 複数のテーブルの作成とデータ追加、INNER JOINによるテーブル結合の理解、結合条件の指定方法、結合結果を使った計算、GROUP BYによるグループ化とSUM関数による集計を習得します。 商品テーブルと申し込みテーブルを使用して、複数のSQL問い合わせを実行します。 手順 ステップ1:SQLFiddleまたはDBFiddleにアクセスしてください。
前回と同じ手順でアクセス。「MySQL」を選択 ステップ2:SQLを入力して実行してください。 注意: 以前使用したSQLは削除。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ2:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 商品テーブルの内容が表示されます。id、商品名、単価の3列が表示されます。 期待される結果: 商品テーブルの内容が正しく表示されていることを確認してください。 ヒントと考察のポイント SELECT文について: ステップ3:申し込みテーブルの確認 上のパネルの最後の行を以下に変更してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ4:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 申し込みテーブルの内容が表示されます。日時は実行時の時刻が記録されます。 期待される結果: 申し込みテーブルの内容が正しく表示されていることを確認してください。 ヒントと考察のポイント SELECT文について: ステップ5:テーブル結合の実行 上のパネルの最後の行を以下に変更してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ6:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 結果には、申し込みテーブルと商品テーブルの両方の列が含まれています。各申し込みに対応する商品名と単価が表示されていることを確認してください。 期待される結果: 申し込みテーブルと商品テーブルの両方の列が正しく表示されていることを確認してください。 ヒントと考察のポイント INNER JOINについて: ステップ7:結合結果を使った計算 上のパネルの最後のところを以下に変更してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ8:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 各申し込みの日時、氏名、および合計金額が表示されることを確認してください。合計金額は個数×単価で計算されます。 期待される結果: 各申し込みの日時、氏名、および合計金額が正しく表示されていることを確認してください。 ヒントと考察のポイント SELECT文について: ステップ9:グループ化と集計 上のパネルの最後のところを以下に変更してください。 SQLFiddleへの貼り付けは、CTRLキーとvキーの同時押しで行えます。 入力後、「Execute」ボタン(SQLFiddleの場合)または「Run」ボタン(DBFiddleの場合)をクリックしてください。 ステップ10:結果を確認してください 下のパネルまたは右側に以下の結果が表示されることを確認してください。 氏名ごとの合計金額が表示されることを確認してください。Xさんは2200円、Yさんは1000円と表示されます。 期待される結果: 氏名ごとの合計金額が正しく表示されていることを確認してください。 ヒントと考察のポイント GROUP BYについて: 基本的な演習を完了したら、以下の発展演習に挑戦してください。各問題には、目的、ヒント、期待される結果が示されています。 発展演習1:商品の単価の最大値を取得 目的 集約関数MAXの使用方法を理解します。 問題 商品テーブルを使用して、商品の単価の最大値を取得するSQLを作成してください。 ヒント 集約関数MAXを使用します。 期待される結果 使用する知識 集約関数MAX 発展演習2:特定の氏名による申し込み情報の取得 目的 WHERE句を使った条件指定を復習します。 問題 申し込みテーブルを使用して、氏名が'X'のすべての申し込み情報を取得するSQLを作成してください。 ヒント WHERE句を使用して条件を指定します。 注意事項 日時の値は、実際にデータを追加した日時になるため、人によって結果が異なります。 期待される結果の例 発展演習3:特定商品を申し込んだ人の氏名取得 目的 テーブル結合、条件指定、重複除去の組み合わせを理解します。 問題 商品テーブルと申し込みテーブルを結合し、商品名が'商品A'である商品を申し込んだすべての人の氏名を取得するSQLを作成してください。ただし、重複行は除去してください。 ヒント INNER JOINでテーブルを結合し、WHERE句で商品名を指定し、DISTINCTで重複を除去します。 期待される結果 発展演習4:氏名別の申し込み回数の集計 目的 GROUP BYとCOUNT関数の使用方法を理解します。 問題 申し込みテーブルを使用して、氏名ごとに申し込みの回数を集計するSQLを作成してください。 ヒント COUNT(*)で行数をカウントし、GROUP BYで氏名ごとにグループ化します。 期待される結果 発展演習5:特定商品に対する申し込み総数の計算 目的 テーブル結合、条件指定、SUM関数の組み合わせを理解します。 問題 商品テーブルと申し込みテーブルを結合し、商品名が'商品B'に対する申し込みの総個数を計算するSQLを作成してください。 ヒント INNER JOINでテーブルを結合し、WHERE句で商品名を指定し、SUM関数で個数の合計を求めます。 期待される結果 自分で考えた後、以下の解答を参考にしてください。 発展演習1の解答 解説 MAX関数は指定した列の最大値を返す集約関数です。商品テーブルの単価列から最大値200が得られます。 発展演習2の解答 解説 WHERE句で氏名が'X'の行のみを抽出します。*はすべての列を意味します。結果として、Xさんによる3件の申し込み情報が表示されます。 発展演習3の解答 解説 INNER JOINで申し込みテーブルと商品テーブルを結合し、WHERE句で商品名が'商品A'の行を抽出し、DISTINCTで重複する氏名を除去します。結果として、商品Aを申し込んだ人の氏名が1件だけ表示されます。 発展演習4の解答 解説 GROUP BY 氏名で、氏名ごとにグループ化し、COUNT(*)で各グループの行数をカウントします。結果として、Xさんは3回、Yさんは1回の申し込みがあることがわかります。 発展演習5の解答 解説 INNER JOINで申し込みテーブルと商品テーブルを結合し、WHERE句で商品名が'商品B'の行を選択し、SUM関数で個数列の合計を計算します。結果として、商品Bの申し込み総数15が得られます。Xさんが10個、Yさんが5個です。 テーブル結合について INNER JOINは、2つのテーブルを結合条件に基づいて結合します。結合条件は `ON テーブル1.列名 = テーブル2.列名` の形式で指定します。テーブルを分割してデータの重複を避けつつ、必要な情報を組み合わせて取得できます。 集約関数について AVGは平均値を計算し、MAXは最大値を取得し、MINは最小値を取得し、SUMは合計値を計算し、COUNTは行数をカウントします。 GROUP BYについて 指定した列の値が同じ行をグループ化します。集約関数と組み合わせて、グループごとの統計情報を計算できます。[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:SQLの様々な機能
CREATE TABLE 従業員 (
従業員ID INTEGER,
名前 TEXT,
部署ID INTEGER,
給与 INTEGER
);

INSERT INTO 従業員 VALUES(5, '伊藤', 104, 280000);
INSERT INTO 従業員 VALUES(6, '渡辺', 101, 320000);
INSERT INTO 従業員 VALUES(7, '小林', 102, 270000);
INSERT INTO 従業員 VALUES(8, '加藤', 103, 290000);
INSERT INTO 従業員 VALUES(9, '吉田', 104, 310000);
INSERT INTO 従業員 VALUES(10, '中村', 101, 330000);
INSERT INTO 従業員 VALUES(11, '小川', 102, 260000);
INSERT INTO 従業員 VALUES(12, '高橋', 103, 340000);
INSERT INTO 従業員 VALUES(13, '山本', 104, 300000);
INSERT INTO 従業員 VALUES(14, '石川', 101, 350000);
INSERT INTO 従業員 VALUES(15, '中島', 102, 280000);
INSERT INTO 従業員 VALUES(16, '佐々木', 103, 360000);
INSERT INTO 従業員 VALUES(17, '山口', 104, 290000);
INSERT INTO 従業員 VALUES(18, '松本', 101, 370000);
INSERT INTO 従業員 VALUES(19, '井上', 102, 310000);
INSERT INTO 従業員 VALUES(20, '木村', 103, 280000);
INSERT INTO 従業員 VALUES(21, '林', 104, 320000);
INSERT INTO 従業員 VALUES(22, '清水', 101, 330000);
INSERT INTO 従業員 VALUES(23, '山崎', 102, 340000);
INSERT INTO 従業員 VALUES(24, '中田', 103, 300000);

SELECT 名前, 給与 FROM 従業員 WHERE 部署ID = 101;
SELECT * FROM 従業員 WHERE 給与 >= (SELECT AVG(給与) FROM 従業員);
SELECT * FROM 従業員 WHERE 部署ID IN (101, 102);
SELECT * FROM 従業員 WHERE 給与 >= 300000 AND 部署ID = 102;
演習2:2つのテーブルを用いた本格的なデータ処理
CREATE TABLE 商品 (
id INTEGER,
商品名 TEXT,
単価 INTEGER
);

CREATE TABLE 申し込み (
id INTEGER,
日時 DATETIME,
氏名 TEXT,
商品番号 INTEGER,
個数 INTEGER
);

INSERT INTO 商品 VALUES (1, '商品A', 100);
INSERT INTO 商品 VALUES (2, '商品B', 200);
INSERT INTO 商品 VALUES (3, '商品C', 150);

INSERT INTO 申し込み VALUES (101, NOW(), 'X', 1, 1);
INSERT INTO 申し込み VALUES (102, NOW(), 'X', 2, 10);
INSERT INTO 申し込み VALUES (103, NOW(), 'Y', 2, 5);
INSERT INTO 申し込み VALUES (104, NOW(), 'X', 1, 1);

SELECT * FROM 商品;
SELECT * FROM 申し込み;
SELECT * FROM 申し込み
INNER JOIN 商品 ON 申し込み.商品番号 = 商品.id;
SELECT 申し込み.日時,申し込み.氏名,申し込み.個数 * 商品.単価
FROM 申し込み
INNER JOIN 商品 ON 申し込み.商品番号 = 商品.id;
SELECT 氏名, SUM(個数 * 商品.単価)
FROM 申し込み
INNER JOIN 商品 ON 申し込み.商品番号 = 商品.id
GROUP BY 氏名;
発展演習
MAX(単価)
200 +-----+---------------------+------+----------+------+
| id | 日時 | 氏名 | 商品番号 | 個数 |
+-----+---------------------+------+----------+------+
| 101 | 2025-10-31 15:19:24 | X | 1 | 1 |
| 102 | 2025-10-31 15:19:24 | X | 2 | 10 |
| 104 | 2025-10-31 15:19:24 | X | 1 | 1 |
+-----+---------------------+------+----------+------++------+
| 氏名 |
+------+
| X |
+------++------+------------+
| 氏名 | |
+------+------------+
| X | 3 |
| Y | 1 |
+------+------------++----------------------+
| 15 |
+----------------------+発展演習の解答
SELECT MAX(単価) FROM 商品;SELECT * FROM 申し込み WHERE 氏名 = 'X';SELECT DISTINCT 申し込み.氏名
FROM 申し込み
INNER JOIN 商品 ON 申し込み.商品番号 = 商品.id
WHERE 商品.商品名 = '商品A';SELECT 氏名, COUNT(*)
FROM 申し込み GROUP BY 氏名;SELECT SUM(申し込み.個数)
FROM 申し込み
INNER JOIN 商品 ON 申し込み.商品番号 = 商品.id
WHERE 商品.商品名 = '商品B';学習のポイント
ds-9. 主キーと参照整合性制約
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: このガイドは、データベース設計の基礎(主キー・外部キーを用いたテーブル間の関連付けとSQL実践)の演習を自習するためのものです。SQLFiddle([http://sqlfiddle.com/](http://sqlfiddle.com/))またはDBFiddle([https://www.db-fiddle.com/](https://www.db-fiddle.com/))を使用してオンラインで演習を実施できます。 演習の目的 主キーは、テーブルの各行を一意に識別するためのキーです。この演習では、主キー制約を設定し、重複したデータの挿入が自動的にブロックされることを確認します。 手順 1. Webブラウザを使用 アドレスバーにSQLFiddleのURLを入力します:[http://sqlfiddle.com/](http://sqlfiddle.com/) 2. MySQLを選択 データベース管理システムとして「MySQL」を選択します。 3. 上のパネルにSQLを入力 テーブル定義、データの追加、問い合わせを行うSQLを入力します(SQLFiddleで最初に出てくるSQLは不要なので消します)。 4. Executeをクリック SQL文が実行され、結果が表示されます。 5. 下のパネルで結果を確認 商品テーブルにID=1(みかん)、ID=2(りんご)、ID=3(メロン)の3件のデータが正常に追加されたことを確認します。 6. 主キー制約の確認 上のパネルのSQLを以下に変更します(以前のSQLは不要なので消します)。 7. Executeをクリック 8. 下のパネルで結果を確認 エラーメッセージ「ERROR 1062 (23000): Duplicate entry '1' for key '商品.PRIMARY'」が表示されることを確認します。 ヒント 考察のポイント 理解のポイント よくある間違い 演習の目的 単一の列ではなく、複数の列の組み合わせで一意性を保証する主キー制約を学びます。 手順 1. 上のパネルにSQLを入力 テーブル定義、データの追加、問い合わせを行うSQLを入力します(以前のSQLは不要なので消します)。 2. Executeをクリック SQL文が実行され、結果が表示されます。 3. 下のパネルで結果を確認 成績テーブルに学生ID=1の2件、学生ID=2の3件、合計5件のデータが正常に追加されたことを確認します。 ヒント 考察のポイント 理解のポイント よくある間違い 演習の目的 発展演習1に1行追加し、主キー制約に違反する場合、実行できないことを確認します。 手順 1. 上のパネルにSQLを入力(発展演習1に1行増やしています) テーブル定義、データの追加を行うSQLを入力します(以前のSQLは不要なので消します)。 2. Executeをクリック 3. 下のパネルで結果を確認 エラーメッセージ「ERROR 1062 (23000): Duplicate entry '1-1001' for key '成績.PRIMARY'」が表示されることを確認します。 ヒント 考察のポイント 理解のポイント よくある間違い 演習の目的 外部キーを使用してテーブル間の関連を表現し、参照整合性制約によってデータの整合性が保証されることを確認します。また、複数のテーブルを結合して情報を取得する方法を学びます。 手順 1. 商品テーブルの作成 上のパネルに以下のSQLを入力します(以前のSQLは不要なので消します)。 2. Executeをクリック SQL文が実行され、結果が表示されます。 3. 下のパネルで結果を確認 商品テーブルにID=1(みかん)、ID=2(りんご)、ID=3(メロン)の3件のデータが正常に追加されたことを確認します。 4. 購入テーブルの作成(外部キー制約付き) 上のパネルに以下のSQLを入力します(以前のSQLは不要なので消します)。 5. Executeをクリック SQL文が実行され、結果が表示されます。 6. 下のパネルで結果を確認 購入テーブルにID=1(購入者X、商品ID=1、数量10)、ID=2(購入者Y、商品ID=2、数量5)の2件のデータが正常に追加されたことを確認します。 7. テーブルの結合 上のパネルに以下のSQLを入力します(以前のSQLは不要なので消します)。 8. Executeをクリック SQL文が実行され、結果が表示されます。 9. 下のパネルで結果を確認 購入者X(みかん、500円)、購入者Y(りんご、500円)の2件の結果が表示されることを確認します。2つのテーブルの利用により、各購入者の購入商品とその総額が表示されることを確認します。 ヒント 考察のポイント 理解のポイント よくある間違い 演習の目的 存在しない商品IDを挿入しようとして、参照整合性制約違反を確認します。 手順 1. 上のパネルにSQLを入力(演習2に1行増やしています) テーブル定義、データの追加を行うSQLを入力します(以前のSQLは不要なので消します)。 2. Executeをクリック 3. 下のパネルで結果を確認 エラーメッセージ「ERROR 1452 (23000): Cannot add or update a child row: a foreign key constraint fails」が表示されることを確認します。 ヒント 考察のポイント 理解のポイント よくある間違い 日常生活との対応[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:テーブル定義とデータの追加、主キー制約
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);

INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);

SELECT * FROM 商品;CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
INSERT INTO 商品 VALUES(1, 'いちご', 1000);
発展演習1:複数列の主キー制約
CREATE TABLE 成績 (
学生ID INTEGER,
科目ID INTEGER,
得点 INTEGER,
PRIMARY KEY(学生ID, 科目ID));

INSERT INTO 成績 VALUES(1, 1001, 90);
INSERT INTO 成績 VALUES(1, 1002, 100);
INSERT INTO 成績 VALUES(2, 1001, 85);
INSERT INTO 成績 VALUES(2, 1002, 90);
INSERT INTO 成績 VALUES(2, 1003, 95);

SELECT * FROM 成績;
発展演習2:主キー制約の違反
CREATE TABLE 成績 (
学生ID INTEGER,
科目ID INTEGER,
得点 INTEGER,
PRIMARY KEY(学生ID, 科目ID));

INSERT INTO 成績 VALUES(1, 1001, 90);
INSERT INTO 成績 VALUES(1, 1002, 100);
INSERT INTO 成績 VALUES(2, 1001, 85);
INSERT INTO 成績 VALUES(2, 1002, 90);
INSERT INTO 成績 VALUES(2, 1003, 95);
INSERT INTO 成績 VALUES(1, 1001, 95);

SELECT * FROM 成績;
演習2:外部キー、参照整合性制約
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);

INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);

SELECT * FROM 商品;CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));
INSERT INTO 購入 VALUES(1, 'X', 1, 10);
INSERT INTO 購入 VALUES(2, 'Y', 2, 5);
SELECT * FROM 購入;CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));
INSERT INTO 購入 VALUES(1, 'X', 1, 10);
INSERT INTO 購入 VALUES(2, 'Y', 2, 5);
SELECT 購入.購入者, 商品.商品名, 商品.単価 * 購入.数量
FROM 購入
INNER JOIN 商品 ON 購入.商品ID = 商品.ID;
発展演習3:参照整合性制約の違反
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);

INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);

CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));

INSERT INTO 購入 VALUES(1, 'X', 1, 10);
INSERT INTO 購入 VALUES(2, 'Y', 2, 5);
INSERT INTO 購入 VALUES(3, 'X', 22, 1);
ds-10. データベース設計、正規化
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: 学習目標 背景知識 テーブルとは、データを行と列の形式で整理したものです。正規化とは、テーブルの構造を最適化し、データの重複を減らす手法です。 正規化前のテーブルには「カレーライス 400円」という情報が2回出現しています。このような冗長性は、データ更新時に複数箇所を変更する必要があり、更新ミスのリスクを生みます。正規化により、同じ情報を1箇所だけに保存することでこの問題を解決します。 演習手順 ステップ1: SQLFiddleへのアクセス [http://sqlfiddle.com/](http://sqlfiddle.com/) にアクセスし、MySQLを選択してください。 ステップ2: SQLの入力 上のパネルに以下のSQLを入力してください。以前のSQLがあれば消してください。 ステップ3: 実行と結果確認 「Execute」ボタンをクリックしてください。下側のウィンドウに結果が表示されます。 期待される結果: テーブルXの内容: テーブルYの内容: 考察のポイント テーブルTの問題点について 正規化後のテーブルXとYについて よくある間違いと回避方法 間違い1: DISTINCTキーワードを忘れる 間違い2: CREATE TABLE ... AS構文の理解不足 学習目標 背景知識 情報無損失とは、正規化によってテーブルを分割しても、元の情報が失われないことを意味します。INNER JOINとは、2つのテーブルを指定した条件に基づいて結合する操作です。属性とは、テーブルの列のことを指します。 正規化の目的は冗長性の削減であって情報の削減ではありません。正しく正規化されたテーブル群は、結合することで元のテーブルを正確に復元できます。 演習手順 ステップ1: SQLFiddleへのアクセス [http://sqlfiddle.com/](http://sqlfiddle.com/) にアクセスし、MySQLを選択してください。 ステップ2: SQLの入力 上のパネルに以下のSQLを入力してください。以前のSQLがあれば消してください。 ステップ3: 実行と結果確認 「Execute」ボタンをクリックしてください。下側のウィンドウに結果が表示されます。 結合結果が元のテーブルTと一致することを確認してください。 期待される結果: 考察のポイント INNER JOINの動作について 情報無損失の確認について 適切な正規化の条件について よくある間違いと回避方法 間違い1: 結合条件を間違える 間違い2: 結合結果と元のテーブルの比較を忘れる 学習目標 演習手順 ステップ1: SQLFiddleへのアクセス [http://sqlfiddle.com/](http://sqlfiddle.com/) にアクセスし、MySQLを選択してください。 ステップ2: SQLの入力と実行 上のパネルに以下のSQLを入力し、「Execute」をクリックしてください。 考察のポイント 冗長性の確認について ヒント 解答例 期待される結果: 冗長性の分析: これは冗長なデータです。学生の名前を変更する場合、その学生が受講しているすべての科目の行を更新する必要があります。 学習目標 演習手順 ステップ1: SQLの追加 発展演習1のSQLは消さないで、下のSQLを追加して実行してください。 考察のポイント 冗長性の確認について ヒント 解答例 期待される結果: 冗長性の分析: これは明らかにデータの冗長性です。学生の基本情報が受講科目の数だけ重複して格納されています。 学習目標 演習手順 ステップ1: SQLの追加 SQLは消さないで、下のSQLを追加して実行してください。 考察のポイント DISTINCTの効果について ヒント 解答例 期待される結果: DISTINCTの効果: DISTINCTキーワードを使用することで、冗長なデータを除去し、各学生の基本情報を一度だけ取得できます。 学習目標 演習手順 ステップ1: SQLの追加 SQLは消さないで、下のSQLを追加して実行してください。 考察のポイント 正規化の効果について ヒント 解答例 期待される結果: テーブルU(学生基本情報): テーブルV(受講情報): 正規化の効果: この正規化により、データの冗長性が削減され、データの整合性が向上しました。[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1: テーブルの分割による正規化
CREATE TABLE T (
名前 TEXT,
昼食 TEXT,
料金 INTEGER);

INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);

CREATE TABLE X AS SELECT DISTINCT 名前, 昼食 FROM T;
CREATE TABLE Y AS SELECT DISTINCT 昼食, 料金 FROM T;

SELECT * FROM X;
SELECT * FROM Y;名前 昼食
A そば
B カレーライス
C カレーライス
D うどん昼食 料金
そば 250
カレーライス 400
うどん 250
演習2: 正規化における情報無損失
CREATE TABLE T (
名前 TEXT,
昼食 TEXT,
料金 INTEGER);

INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);

CREATE TABLE X AS SELECT DISTINCT 名前, 昼食 FROM T;
CREATE TABLE Y AS SELECT DISTINCT 昼食, 料金 FROM T;

SELECT X.名前, X.昼食, Y.料金 FROM X INNER JOIN Y ON X.昼食 = Y.昼食;名前 昼食 料金
A そば 250
B カレーライス 400
C カレーライス 400
D うどん 250
発展演習1: 学生情報のためのテーブル作成
CREATE TABLE S (
StudentID INTEGER,
StudentName TEXT,
Course TEXT
);

INSERT INTO S VALUES (1, 'Alice', 'Math');
INSERT INTO S VALUES (1, 'Alice', 'Science');
INSERT INTO S VALUES (2, 'Bob', 'History');
INSERT INTO S VALUES (3, 'Charlie', 'Math');
INSERT INTO S VALUES (3, 'Charlie', 'History');
INSERT INTO S VALUES (3, 'Charlie', 'Science');

SELECT * FROM S;
StudentID  StudentName  Course
1          Alice        Math
1          Alice        Science
2          Bob          History
3          Charlie      Math
3          Charlie      History
3          Charlie      Science
発展演習2: 冗長なデータの確認
SELECT StudentID, StudentName FROM S;
StudentID  StudentName
1          Alice
1          Alice
2          Bob
3          Charlie
3          Charlie
3          Charlie
発展演習3: 重複なしの学生情報抽出
SELECT DISTINCT StudentID, StudentName FROM S;
StudentID  StudentName
1          Alice
2          Bob
3          Charlie
発展演習4: 正規化
CREATE TABLE U AS SELECT DISTINCT StudentID, StudentName FROM S;
CREATE TABLE V AS SELECT DISTINCT StudentID, Course FROM S;

SELECT * FROM U;
SELECT * FROM V;
StudentID  StudentName
1          Alice
2          Bob
3 CharlieStudentID Course
1 Math
1 Science
2 History
3 Math
3 History
3 Science
ds-11. データベース操作とトランザクション管理:データ整合性と永続性
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: SQLFiddleを使用してデータベース操作とトランザクション管理を実践的に学ぶ。各演習を順番に進めることで、データベースの基本概念とトランザクションの重要性を理解できる。 学習目標 データベースの基本操作であるINSERT(追加)、SELECT(問い合わせ)、UPDATE(更新)、DELETE(削除)を実際に実行し、その動作を理解する。 事前準備:SQLFiddleへのアクセス 演習1-1:テーブルの作成とデータの追加 目的 テーブルを定義し、初期データを追加する方法を学ぶ。 手順 期待される実行結果 4行のデータが正しく追加され、各列の値が表示される。 ヒント 演習1-2:データの更新(UPDATE) 目的 既存のデータを変更する方法を学ぶ。 手順 期待される実行結果 カレーライスの料金が400円から450円に変更されている。BとCの両方が更新される。 ヒント 演習1-3:特定行の更新 目的 特定の行のみを更新する方法を学ぶ。 手順 期待される実行結果 名前が'C'の行のみが更新され、Cの昼食が「カレーライス」から「ラーメン」に変更されている。 演習1-4:データの削除(DELETE) 目的 特定のデータを削除する方法を学ぶ。 手順 期待される実行結果 名前が'B'の行が削除され、残りの3行(A、C、D)のデータが保持されている。 注意点 目的 OR条件を使用して、複数の条件に合致する行を一度に更新する方法を学ぶ。 課題 「そば」と「うどん」の料金を300円に更新する。 ヒント 解答例 このSQL文は、昼食が「そば」または「うどん」であるすべての行の料金を300円に更新する。 目的 INSERT INTOを使用して新しいレコードをテーブルに追加する方法を学ぶ。 課題 新しく「E」が「天ぷら」を料金500円で食べた情報をテーブルTに追加する。 ヒント 解答例 このSQL文は、名前「E」、昼食「天ぷら」、料金500円の新しい行をテーブルTに追加する。 学習目標 トランザクションの概念を理解し、COMMITとROLLBACKの動作を実際に確認する。 トランザクションとは 複数のデータベース操作を一つの処理単位としてまとめたもの。すべての操作が成功した場合のみ変更を確定し、一つでも失敗すれば全体を取り消す仕組み。 演習2-1:ROLLBACKによる変更の取り消し 目的 トランザクション内の変更をROLLBACKで取り消す動作を確認する。 手順 期待される実行結果 トランザクション内で実行されたAとBの変更がROLLBACKにより取り消され、元のデータが保持されている。 ヒント 演習2-2:COMMITによる変更の確定 目的 トランザクション内の変更をCOMMITで確定する動作を確認する。 手順 期待される実行結果 トランザクション内で実行されたAとBの変更がCOMMITにより確定されている。 ヒント COMMITとROLLBACKの比較 よくある質問と注意点 Q1:WHERE句を忘れるとどうなるか A:DELETEやUPDATEでWHERE句を省略すると、テーブル内のすべての行が対象となる。意図しないデータの削除や変更を防ぐため、WHERE句は必ず指定する。 Q2:主キー制約とは何か A:主キー制約は、列の値が重複しないことを保証する制約。主キーに設定された列には、同じ値を持つ行を追加できない。 Q3:トランザクションはいつ使うのか A:複数の操作が互いに関連している場合に使用する。例えば、銀行の送金処理では、出金と入金の両方が成功した場合のみ確定する必要がある。 Q4:制約違反が発生するとどうなるか A:制約違反(主キーの重複など)が発生すると、COMMITは実行されず、トランザクション全体が自動的にロールバックされる。 まとめ この自習ガイドを通じて、以下の内容を学んだ。 これらは、データベースを扱うすべてのアプリケーション開発において基礎となる重要な概念である。演習を繰り返し実践することで、理解を深めることができる。[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:データベース操作の実践
[http://sqlfiddle.com/](http://sqlfiddle.com/)
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 250 |
| B | カレーライス | 400 |
| C | カレーライス | 400 |
| D | うどん | 250 |
+--------+------------------+-------+
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
UPDATE T SET 料金 = 450 WHERE 昼食 = 'カレーライス';
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 250 |
| B | カレーライス | 450 |
| C | カレーライス | 450 |
| D | うどん | 250 |
+--------+------------------+-------+
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
UPDATE T SET 昼食 = 'ラーメン' WHERE 名前 = 'C';
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 250 |
| B | カレーライス | 400 |
| C | ラーメン | 400 |
| D | うどん | 250 |
+--------+------------------+-------+
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
DELETE FROM T WHERE 名前 = 'B';
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 250 |
| C | カレーライス | 400 |
| D | うどん | 250 |
+--------+------------------+-------+
発展演習1:複数条件での更新
UPDATE T SET 料金 = 300 WHERE 昼食 = 'そば' OR 昼食 = 'うどん';発展演習2:新しいデータの追加
INSERT INTO T VALUES ('E', '天ぷら', 500);演習2:トランザクション
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
START TRANSACTION;
UPDATE T SET 料金 = 500 WHERE 名前 = 'A';
UPDATE T SET 昼食 = 'ラーメン' WHERE 名前 = 'B';
ROLLBACK;
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 250 |
| B | カレーライス | 400 |
| C | カレーライス | 400 |
| D | うどん | 250 |
+--------+------------------+-------+
CREATE TABLE T (
名前 VARCHAR(20) PRIMARY KEY,
昼食 TEXT,
料金 INTEGER);
INSERT INTO T VALUES('A', 'そば', 250);
INSERT INTO T VALUES('B', 'カレーライス', 400);
INSERT INTO T VALUES('C', 'カレーライス', 400);
INSERT INTO T VALUES('D', 'うどん', 250);
START TRANSACTION;
UPDATE T SET 料金 = 500 WHERE 名前 = 'A';
UPDATE T SET 昼食 = 'ラーメン' WHERE 名前 = 'B';
COMMIT;
SELECT * FROM T;+--------+------------------+-------+
| 名前 | 昼食 | 料金 |
+--------+------------------+-------+
| A | そば | 500 |
| B | ラーメン | 400 |
| C | カレーライス | 400 |
| D | うどん | 250 |
+--------+------------------+-------+
操作       | 動作                             | 結果
COMMIT     | トランザクション内の変更を確定 | データベースに永続的に反映
ROLLBACK   | トランザクション内の変更を取り消し | トランザクション開始時の状態に復元
ds-12. データ管理の基礎:オンライントランザクションとデータウェアハウスの特徴と活用
資料(スライド): [PDF], [パワーポイント]
SQLFiddle(推奨) DBFiddle(代替案) 準備 この演習では、インストール不要のオンラインツールを使用します。以下のいずれかのサイトにアクセスしてください。 SQLFiddle(推奨) DBFiddle(代替案) コピー: SQLFiddleへの貼り付け: SQLFiddleを使用してデータベース操作とトランザクション管理を実践的に学ぶ。各演習を順番に進めることで、データベースの基本概念とトランザクションの重要性を理解できる。 演習の構成と学習の流れ 本ガイドでは以下の順序で演習を実施する。各演習は段階的に内容が発展していく構成となっている。 注意事項 重要: SQLFiddleではサーバの時刻が表示されるため、「2024-05-23 13:19:53」のように実際の現在日時と異なる場合があるが、演習の進行には影響しないので続行すること。 学習目標 この演習では以下を習得する。 演習の目的 データベースの基本操作として、テーブルを作成し、データを追加し、その内容を確認する一連の流れを体験する。主キー制約により、各行を一意に識別できることを確認する。 手順 期待される結果 実行すると、下のパネルに以下のような表が表示される。 ヒント 学習目標 この演習では以下を習得する。 演習の目的 商品テーブルと購入テーブルという2つのテーブルを作成し、外部キーによって両者を関連付ける。これにより、存在しない商品IDを購入テーブルに登録できないことを確認する。演習1で学んだ主キーの知識を活用し、テーブル間の関連を定義する。 手順 期待される結果 実行すると、商品テーブルと購入テーブルの2つの表が表示される。 商品テーブル: 購入テーブル: ヒント 学習目標 この演習では以下を習得する。 演習の目的 データベースで日時情報を扱う第一歩として、現在日時を取得する方法を学ぶ。次の演習4で日時型の属性を持つテーブルを作成するための準備となる。 手順 期待される結果 実行すると、現在日時が表示される。 ヒント 学習目標 この演習では以下を習得する。 演習の目的 購入テーブルに購入日時という日時型の属性を追加し、いつ購入されたかを記録できるようにする。演習3で学んだ日時の取得方法を活用し、実際にテーブルで日時を扱う。 手順 期待される結果 購入テーブルに購入日時が追加されて表示される。 ヒント 学習目標 この演習では以下を習得する。 演習の目的 商品の価格が変化する状況を想定し、価格改定の履歴を記録するテーブルを作成する。これにより、過去のある時点での価格を参照できることを確認する。演習1~4で学んだすべての知識を統合して活用する。 背景知識 手順1:テーブル作成とデータ追加 期待される結果(手順1) 商品テーブルでは、同じ商品でも価格改定ごとに別の行として記録される。 商品テーブル: 重要: りんごはID=2とID=4の2行があり、それぞれ異なる価格である。メロンも同様である。 ヒント(手順1) 手順2:応用的な問い合わせの実行 この手順では、履歴データを活用した複数の問い合わせを実行する。 問い合わせ例1:商品と購入を結合して表示 上のパネルに以下のSQLを追加し、Executeをクリックする。 この問い合わせでは、2つのテーブルを結合し、購入時の商品情報と購入情報を一緒に表示する。 問い合わせ例2:購入者ごとの合計金額を計算 上のパネルに以下のSQLを追加し、Executeをクリックする。 この問い合わせでは、各購入者がいくら支払ったかを計算する。 問い合わせ例3:各商品の最新の改訂日時を取得 上のパネルに以下のSQLを追加し、Executeをクリックする。 この問い合わせでは、各商品の最も新しい価格改定日時を取得する。 問い合わせ例4:各商品の最新価格を取得 上のパネルに以下のSQLを追加し、Executeをクリックする。 この問い合わせでは、各商品の現在の価格を取得する。副問い合わせとは、SELECT文の中にさらにSELECT文を含める手法である。 ヒント(手順2) 位置づけ この演習は応用的な内容である。演習5を完了してから取り組むこと。 学習目標 この演習では以下を習得する。 演習の目的 商品名「りんご」を購入したすべての購入者を取得するSQLを作成する。同じ購入者が複数回購入している場合でも、重複を除いて1回だけ表示する。 課題 商品名が「りんご」である商品を購入したすべての購入者を得るSQLを作成する。DISTINCTによる重複行の除去も行うこと。 期待される結果 ヒント 解答例 重要概念の復習 データ管理の2つのアプローチ[演習の詳細を表示するには、この行をクリックしてください]
【関連する外部サイトへのリンク】
演習全般について
演習1:テーブル定義とデータの追加、主キー制約
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
select * FROM 商品;
+----+--------+------+
| ID | 商品名 | 単価 |
+----+--------+------+
| 1  | みかん | 50   |
| 2  | りんご | 100  |
| 3  | メロン | 500  |
+----+--------+------+
演習2:外部キー、参照整合性制約
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));
INSERT INTO 購入 VALUES(1, 'X', 1, 10);
INSERT INTO 購入 VALUES(2, 'Y', 2, 5);
select * FROM 商品;
select * FROM 購入;
+----+--------+------+
| ID | 商品名 | 単価 |
+----+--------+------+
| 1  | みかん | 50   |
| 2  | りんご | 100  |
| 3  | メロン | 500  |
+----+--------+------++----+--------+--------+------+
| ID | 購入者 | 商品ID | 数量 |
+----+--------+--------+------+
| 1 | X | 1 | 10 |
| 2 | Y | 2 | 5 |
+----+--------+--------+------+
演習3:now()による現在日時の取得
select now();
+---------------------+
| now()               |
+---------------------+
| 2024-05-23 13:19:53 |
+---------------------+
演習4:日時を扱うテーブル
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER);
INSERT INTO 商品 VALUES(1, 'みかん', 50);
INSERT INTO 商品 VALUES(2, 'りんご', 100);
INSERT INTO 商品 VALUES(3, 'メロン', 500);
CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
購入日時 DATETIME,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));
INSERT INTO 購入 VALUES(1, 'X', 1, 10, '2026-12-04 09:00:00');
INSERT INTO 購入 VALUES(2, 'Y', 2, 5, '2025-12-04 10:00:00');
select * FROM 商品;
select * FROM 購入;
+----+--------+--------+------+---------------------+
| ID | 購入者 | 商品ID | 数量 | 購入日時            |
+----+--------+--------+------+---------------------+
| 1  | X      | 1      | 10   | 2026-12-04 09:00:00 |
| 2  | Y      | 2      | 5    | 2025-12-04 10:00:00 |
+----+--------+--------+------+---------------------+
演習5:データウェアハウス
CREATE TABLE 商品 (
ID INTEGER PRIMARY KEY,
商品名 TEXT,
単価 INTEGER,
改訂日時 DATETIME);
INSERT INTO 商品 VALUES(1, 'みかん', 50, '2025-12-01 09:00:00');
INSERT INTO 商品 VALUES(2, 'りんご', 100, '2025-12-01 09:00:00');
INSERT INTO 商品 VALUES(3, 'メロン', 500, '2025-12-01 09:00:00');
INSERT INTO 商品 VALUES(4, 'りんご', 150, '2026-01-01 09:00:00');
INSERT INTO 商品 VALUES(5, 'メロン', 400, '2026-01-01 09:00:00');
CREATE TABLE 購入 (
ID INTEGER PRIMARY KEY,
購入者 TEXT,
商品ID INTEGER,
数量 INTEGER,
購入日時 DATETIME,
FOREIGN KEY (商品ID) REFERENCES 商品(ID));
INSERT INTO 購入 VALUES(1, 'X', 1, 10, '2025-12-10 10:00:00');
INSERT INTO 購入 VALUES(2, 'Y', 2, 5, '2025-12-20 12:00:00');
INSERT INTO 購入 VALUES(3, 'Y', 4, 20, '2026-01-05 09:00:00');
INSERT INTO 購入 VALUES(4, 'Z', 5, 3, '2026-01-05 11:00:00');
select * FROM 商品;
select * FROM 購入;
+----+--------+------+---------------------+
| ID | 商品名 | 単価 | 改訂日時            |
+----+--------+------+---------------------+
| 1  | みかん | 50   | 2025-12-01 09:00:00 |
| 2  | りんご | 100  | 2025-12-01 09:00:00 |
| 3  | メロン | 500  | 2025-12-01 09:00:00 |
| 4  | りんご | 150  | 2026-01-01 09:00:00 |
| 5  | メロン | 400  | 2026-01-01 09:00:00 |
+----+--------+------+---------------------+
SELECT * FROM 商品
INNER JOIN 購入 ON 商品.ID = 購入.商品ID;SELECT 購入.購入者, SUM(購入.数量 * 商品.単価)
FROM 商品
INNER JOIN 購入 ON 商品.ID = 購入.商品ID
GROUP BY 購入.購入者;SELECT 商品名, MAX(改訂日時)
FROM 商品
GROUP BY 商品名;SELECT 商品名, 単価, 改訂日時
FROM 商品
WHERE (商品名, 改訂日時) IN (
SELECT 商品名, MAX(改訂日時)
FROM 商品
GROUP BY 商品名);
発展演習1:商品「りんご」を購入した人の取得
+--------+
| 購入者 |
+--------+
| Y      |
+--------+
SELECT DISTINCT(購入.購入者)
FROM 購入
INNER JOIN 商品 ON 購入.商品ID = 商品.ID
WHERE 商品.商品名 = 'りんご';
学習のまとめ
ds-13. Microsoft Access の使い方、データの並べ替え(ソート)
資料(スライド): [PDF], [パワーポイント]
db4-4.accdb 今回の演習では、SQL Fiddle を使わずに、Microsoft Access を使う。 Microsoft Access は、パソコン室のパソコンにインストール済み。 今回の授業の特徴: Microsoft Access の練習。大量データの処理 学習目標 使用するソフトウェア 演習用データベースファイル データについて 演習では「米国成人調査データ」(1994年、米国における統計調査データのうち32561人分)を使用する。 データの出典: Lichman, M. (2013). UCI Machine Learning Repository [[http://archive.ics.uci.edu/ml](http://archive.ics.uci.edu/ml)]. Irvine, CA: University of California, School of Information and Computer Science(米国) 注意: 演習では、特定の職業、学歴、性別、母国を差別的に見ないようにすること。 問い合わせ(クエリ)の基本 問い合わせ(クエリ)は、データベースから必要なデータを検索・加工するためのコマンド。 主なパターンは以下の通りである。 Accessの3つのビュー Accessには主に3つのビューがある。 本演習では、主にSQLビューとデータシートビューを使用する。 Accessの起動方法とデータベースの新規作成手順を理解する。 手順 Accessのスタート画面の構成 スタート画面には以下の要素がある。 リボンとタブについて リボンには、タブ、グループ、コマンドが配置される。各タブには、作業の種類ごとにコマンドがまとめられている。 ヒント SQLのORDER BY句を使用して、データの並べ替えを実行する方法を習得する。 並べ替えのバリエーション 本演習では以下のバリエーションを学習する。 SQLビューを開く操作 以下の手順でSQLビューを開く。 AccessでのSQL実行手順 以下の手順でSQLを実行する。 並べ替えの基本構文 WHERE句やGROUP BY句と組み合わせる場合は、ORDER BY句を最後に記述する。 重要 最初に db4-4.accdb を開き、その後下の演習 2-1 から開始する db4-4.accdb 演習2-1: 年齢による並べ替え(昇順) 目的: ORDER BY句による昇順の並べ替えを理解する SQL:(次のSQLを使用) 入力時の注意: 確認ポイント: 演習2-2: 年齢による並べ替え(降順) 目的: DESCキーワードを使用した降順の並べ替えを理解する SQL: 確認ポイント: 演習2-1との比較: 演習2-3: 教育年数による並べ替え(昇順) 目的: 異なる列(教育年数)での並べ替えを実践する SQL: 確認ポイント: 演習2-4: 複数の列による並べ替え(昇順) 目的: 複数の列を指定した並べ替えの動作を理解する SQL: 入力時の注意: 確認ポイント: 学習のポイント: ORDER BY句に複数の列を指定すると、左側の列が優先される。同じ値の場合に次の列で並べ替えが行われる。 演習2-4補足: 複数の列による並べ替え(降順) 目的: 複数の列での降順の並べ替えを実践する SQL: 入力時の注意: 確認ポイント: 学習のポイント: 各列に対して個別にDESCを指定することで、それぞれを降順にできる。 演習2-5: 選択と並べ替えの組み合わせ(昇順) 目的: WHERE句による選択とORDER BY句による並べ替えを組み合わせる方法を習得する SQL: 確認ポイント: 学習のポイント: WHERE句とORDER BY句を組み合わせる場合、WHEREが先、ORDER BYが後である。 演習2-6: 選択と並べ替えの組み合わせ(降順) 目的: 選択と降順の並べ替えの組み合わせを実践する SQL: 確認ポイント: 演習2-7: 集計と並べ替えの組み合わせ 目的: GROUP BY句による集計結果をORDER BY句で並べ替える方法を習得する SQL: 確認ポイント: 学習のポイント: GROUP BY句とORDER BY句を組み合わせる場合、GROUP BYが先、ORDER BYが後である。集計関数(COUNT、SUM、AVGなど)の結果で並べ替えることも可能である。 本演習で学習した内容を整理する。 データベースファイルを開く際に以下のメッセージが表示される場合がある。 信頼できるファイルのみを開くようにすること。 作業終了後は、ウィンドウ右上の×ボタンをクリックしてAccessを終了する。[演習の詳細を表示するには、この行をクリックしてください]
演習で使用するデータベースファイル
演習全般について
基礎知識
演習1: Accessの利用開始
演習2: AccessのSQLビューを用いた並べ替え
SELECT 列名
FROM テーブル名
ORDER BY 並べ替えの列;
SELECT *
FROM 米国成人調査データ
ORDER BY 年齢;
SELECT *
FROM 米国成人調査データ
ORDER BY 年齢 DESC;
SELECT *
FROM 米国成人調査データ
ORDER BY 教育年数;
SELECT *
FROM 米国成人調査データ
ORDER BY 年齢, 教育年数;
SELECT *
FROM 米国成人調査データ
ORDER BY 年齢 DESC, 教育年数 DESC;
SELECT *
FROM 米国成人調査データ
WHERE 年齢 > 80
ORDER BY 年齢;
SELECT *
FROM 米国成人調査データ
WHERE 年齢 > 80
ORDER BY 年齢 DESC;
SELECT 母国, COUNT(*)
FROM 米国成人調査データ
GROUP BY 母国
ORDER BY COUNT(*);
まとめ
セキュリティに関する注意
Accessの終了
ds-14. データベースアプリケーションの実践
資料(スライド): [PDF], [パワーポイント]
今日は Google Colaboratory という、オンラインで Python プログラムを実行できるサイトを使用。 [https://colab.research.google.com/drive/18F9rdskdANKrWkB9CTbzyi8e8Gpuj18V?usp=drive_link](https://colab.research.google.com/drive/18F9rdskdANKrWkB9CTbzyi8e8Gpuj18V?usp=drive_link) 本演習を通じて、以下の知識とスキルを習得する。 事前準備 演習を開始する前に、以下を確認する。 演習用ノートブック 以下のURLからGoogle Colaboratoryのノートブックを開く。 演習の進め方 演習は全7つのセル(セル1〜セル7)で構成されている。各セルを上から順番に実行する。セルの実行方法は以下のいずれかである。 目的 演習で使用するデータベースを準備する。データベースへの接続、テーブル作成、データ挿入、コミットの一連の流れを確認する。 関連する学習内容 手順 期待される出力 確認ポイント ヒント 目的 文字列連結でSQLを組み立てた場合に、SQLインジェクション攻撃によって情報漏洩が発生することを確認する。 関連する学習内容 手順 期待される出力 確認ポイント ヒント 注意 本演習で学ぶSQLインジェクションは、防御方法を理解するための学習である。他者が管理するシステムに対してSQLインジェクション攻撃を試みることは、不正アクセス禁止法に違反する犯罪行為である。 目的 プレースホルダ([演習の詳細を表示するには、この行をクリックしてください]
演習
演習1:お店のデータベースを作る
)sqlite3.connect()
)conn.cursor()
)cur.execute()
)conn.commit()
準備完了:お店を開店しました。
によりデータが確定されたcommit()
を実行するまで、データベースへの変更は「仮保存」状態であるcommit()演習2:SQLインジェクション攻撃
)によるSQL組み立ての危険性+
実行される危険なSQL: SELECT * FROM items WHERE name = '' OR '1'='1'
--- 検索結果 ---
[(1, 'パソコン', 120000), (2, 'マウス', 3000), (3, 'キーボード', 8000)]
により、WHERE句の条件が常に真になった' OR '1'='1
は常に真であるため、すべてのデータが取得された'1'='1'
(偽)OR name = ''
(真)となる'1'='1'演習3:プレースホルダで守る
)を使用することで、SQLインジェクション攻撃を防御できることを確認する。?
関連する学習内容
- プレースホルダ:SQL文の中で、後からデータが入る場所をあらかじめ「?」記号で確保しておく仕組み
- データをリスト形式で渡す方法
手順
- セル2を実行済みであることを確認する
- セル3を見つける
- セル3を実行する
期待される出力
--- 安全な検索結果 ---
[]
確認ポイント
- 演習2と同じ攻撃文字列
を送信したが、何も表示されなかった(攻撃失敗)' OR '1'='1 - プレースホルダを使用したため、攻撃文字列は「ただの検索文字列」として処理された
- SQL文の構造(WHERE句には条件が1つある)が確定しているため、入力データがSQL命令として解釈されない
ヒント
- プレースホルダを使用すると、SQL文の構造が先に確定する
- データは後から「値」として埋め込まれるため、SQL命令として解釈される可能性がない
- SQLインジェクション対策として、常にプレースホルダを使用する習慣をつける
演習4:更新とコミット
目的
データを変更し、
commit()関連する学習内容
- UPDATE文によるデータ更新
- コミット:仮保存状態の変更をデータベースに確定する操作
手順
- セル3を実行済みであることを確認する
- セル4を見つける
- セル4を実行する
期待される出力
値上げを確定しました。
[(2, 'マウス', 3500)]
確認ポイント
- マウスの価格が3,000円から3,500円に変更された
により、この変更が確定されたcommit()- この確定状態が、演習6での「戻る先(ロールバック先)」になる
ヒント
を実行するまで、変更は仮保存状態であるcommit()
を実行した時点が、ロールバックで戻れる最新の確定状態となるcommit()
演習5:エラー体験
目的
commit()関連する学習内容
- トランザクション:複数の操作を「1つのまとまり」として扱う仕組み
- エラー発生時の動作
手順
- セル4を実行済みであることを確認する
- セル5を見つける
- セル5を実行する
期待される出力
--- ここからトラブル実験 ---
パソコンを削除してしまいました...(まだ未確定)
その後、赤い背景で以下のエラーが表示される。
ZeroDivisionError: division by zero確認ポイント
- パソコンのデータは削除されたように見える
- しかし、エラーにより
が実行されなかったcommit() - 削除は「仮保存」のまま、確定されていない
ヒント
は0で割り算を行ったときに発生するエラーであるZeroDivisionError- このエラーは演習のために意図的に発生させている
- エラーが表示されることは、この演習では正常な動作である
演習6:手動ロールバック
目的
rollback()関連する学習内容
- ロールバック:変更を取り消し、最後にコミットした状態に戻す操作
- データの整合性(矛盾のない状態)の維持
手順
- セル5を実行済みであることを確認する
- セル6を見つける
- セル6を実行する
期待される出力
ロールバックを実行しました。
--- 在庫確認 ---
[(1, 'パソコン', 120000), (2, 'マウス', 3500), (3, 'キーボード', 8000)]
確認ポイント
- パソコンのデータが復旧した
により、演習4でrollback()
した直後の状態に戻ったcommit()- マウスは3,500円のまま(演習4で確定済みのため)
ヒント
は、最後にrollback()
した時点まで戻すcommit()
で確定した変更は、commit()
では取り消せないrollback()- トランザクションを使用することで、複数の操作を安全に実行できる
演習7:切断
目的
データベース接続を適切に終了する。
関連する学習内容
- 接続の切断(
)conn.close()
手順
- セル6を実行済みであることを確認する
- セル7を見つける
- セル7を実行する
確認ポイント
でデータベースとの接続を終了するclose()- 接続を切断した後に再度演習を行う場合は、セル1から実行し直す
演習の総括
本演習で体験した内容を整理する。
| 演習 | 内容 | 学んだこと |
|---|---|---|
| 演習1 | データベースを作成 | 接続、カーソル、SQL実行、コミット |
| 演習2 | SQLインジェクション攻撃 | 文字列連結の危険性、情報漏洩 |
| 演習3 | プレースホルダで防御 | |
| 演習4 | 更新とコミット | 変更の確定方法 |
| 演習5 | エラー体験 | コミット前のエラーで変更は未確定 |
| 演習6 | ロールバック | |
| 演習7 | 切断 | 接続の終了 |
Pythonでの3つの原則
本演習で学んだ原則を以下にまとめる。
- データはリスト
に格納して渡す[] - SQLには
を使用し、文字列連結(?
)を行わない+ - エラーが発生したら
でデータを復旧するrollback()
用語集
- ドライバ:プログラミング言語とデータベースの間の通信を担うソフトウェア
- カーソル:SQL文を実行し、結果を取得するためのオブジェクト
- プレースホルダ:SQL文中でデータの挿入位置を示す記号(
)? - SQLインジェクション:悪意のある入力によってSQL文を改ざんする攻撃手法
- トランザクション:複数の操作を1つのまとまりとして扱い、整合性を保証する仕組み
- コミット:仮保存状態の変更をデータベースに確定する操作
- ロールバック:変更を取り消す操作
ds-15. NoSQL データベースシステム
資料(スライド): [PDF], [パワーポイント]
[演習の詳細を表示するには、この行をクリックしてください]
演習による体験と探求